工具IMAGE
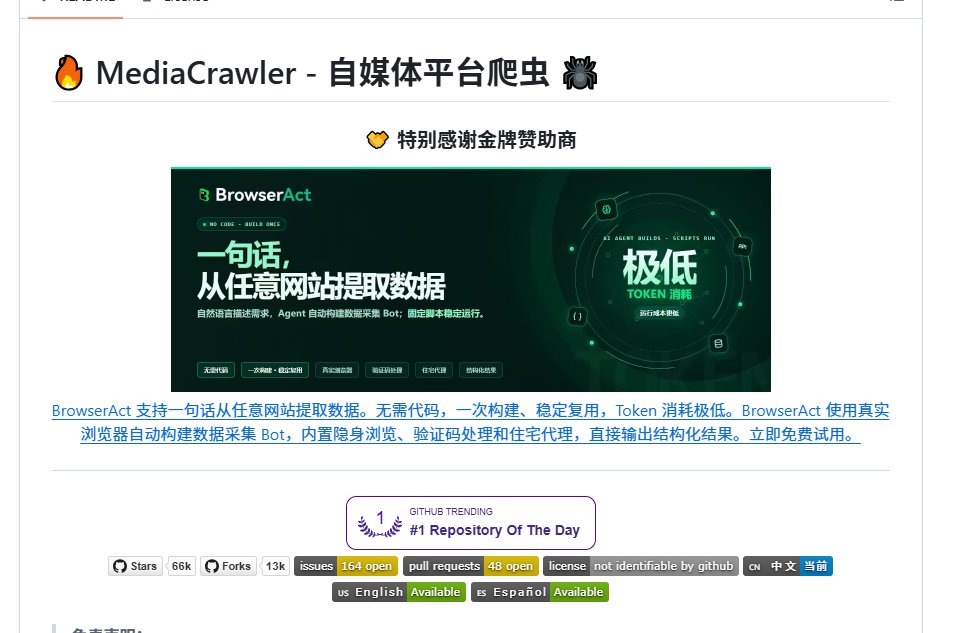
MediaCrawler scrapes Xiaohongshu, Douyin and Kuaishou via browser automation
The 66k-star MediaCrawler uses Playwright to collect public data from Xiaohongshu, Douyin and Kuaishou without reverse engineering, with multi-account support, proxy pools, resumable crawling and AI agent integration.
Gk
@0xGkyArchived 26 days agoOriginally posted 2026.10.06
Gk @0xGkyOriginally posted 2026.10.06
抓小红书、抖音、快手的公开数据,反爬和加密这两关是不是把你卡得够呛? GitHub 上那个 6.6万 Star 的 MediaCrawler,干脆绕开逆向这条路,用 Playwright 驱动的浏览器自动化,把公开数据稳稳当当取回来。 它的硬实力摆在这儿: 关键词一搜就能捞、指定帖子精准抓、二级评论往深里挖、创作者主页整页扒,能覆盖的入口相当全。 多账号来回换,再叠加 IP 代理池,靠环境隔离把风控拦在门口。 断点续爬也安排上了,网络中途掉线随时能续,前面的活儿不白干。 Cursor、Claude Code、OpenClaw 这些 AI Agent 都已打通,采集任务交给它们自己跑。 🔗https://github.com/NanmiCoder/MediaCrawler
x.com/0xgky/status/2107332773945954381Archived 2026.10.07 10:24