Eight open-source Jev reimplementations appear within a week of release
A roundup of eight projects — SemIf, Simple Jev, Laya, Von, Verdict, Kev, Nimble and OpenJev — comparing their accuracy and latency.
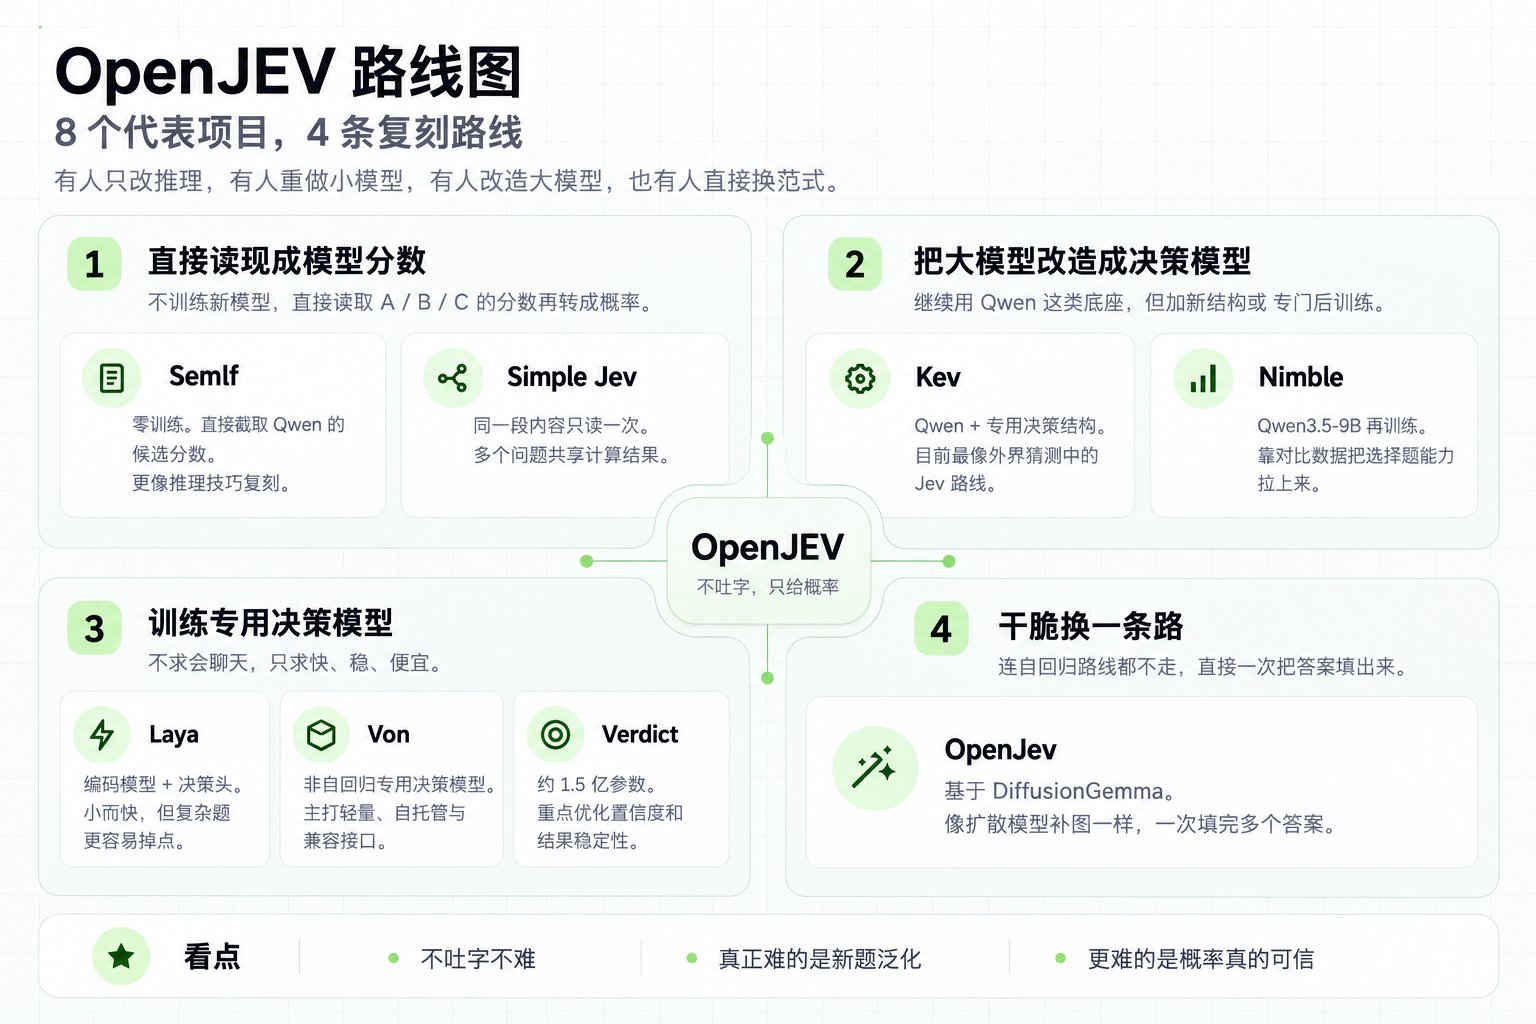
Jev 发布还不到一周,OpenJEV 也开始扎堆了。 我整理了 8 个目前比较有代表性的项目: 1. SemIf 最省事的一派。直接拿现成 Qwen,在模型准备回答 A / B / C 时截住,不让它继续生成文字,只读取每个选项的分数,再换算成概率。 不用重新训练模型,更像是把传统大模型换了一种用法。 https://github.com/TheoLeeCJ/SemIf 2. Simple Jev 思路和 SemIf 类似,但进一步省掉重复计算。 同一段材料只让模型读一次,后面的多个问题共用这部分结果,再分别算答案概率。 作者也说得很清楚,它复刻的是 Jev 的接口和用法,不代表准确率、速度和概率校准已经做到 Jev 水平。 https://github.com/featherless-ai/simple-jev 3. Laya 直接放弃「会写字的大模型」,改用更像传统分类器的编码模型,再加专门的决策头。 模型只有几亿参数,可以做得非常快,但复杂任务还有明显差距。比如一次从 77 个选项里选答案,Laya 准确率 42.5%,Jev 是 87.0%。 https://github.com/NandhaKishorM/laya 4. Von 也是从头做一个专门的决策模型。 Von 只有约 4 亿参数,不生成文字,一次前向直接处理 Choice、Noul 和 Score,更像一个能读自然语言的新一代分类器。 项目自测里,本地 GPU 单次判断已经能压到几十毫秒。 https://github.com/wfzyx/von 5. Verdict 体积更小,只有约 1.5 亿参数。 作者专门处理了两个问题:模型答错了还报很高的置信度,以及把 A、B 选项前后换个顺序,答案就跟着变。 这条路线很看重判断结果和概率能不能稳定。 https://github.com/Heman10x-NGU/Verdict-open-jev 6. Kev Kev 选择了保留大模型,直接拿 Qwen 改。 它给 Qwen 加了专门的决策结构,同一份输入只读一次,多个问题分别给出概率。第三方此前逆向 Jev 时,也猜测 Jev 可能采用类似设计。 Kev 拿训练时没见过的新题测试,8B 版准确率约 78%,Jev 约 86%。差距还在,但已经能看出这条路线确实能跑通。 https://github.com/jaredpalmer/kev 7. Nimble Nimble 更偏「靠训练把 Qwen 练成 Jev」。 它用 Qwen3.5-9B,再准备大量「只改一个事实,正确答案就翻转」的数据做后训练。 在 324 个没参与训练的测试样本里,Nimble 有 90.1% 选中了参考答案,Jev 是 93.2%。不过作者也提醒,它报出来的概率目前还没有完全校准。 https://github.com/bespokelabsai/nimble 8. OpenJev 这条最不一样,直接用了 DiffusionGemma。 它先把多个答案位置留空,再像扩散模型补图一样,一次把答案填出来,不需要一个 token 一个 token 往后生成。 在 RTX PRO 6000 上,作者测到单请求中位延迟约 94ms。 https://github.com/razorback16/openjev --- 看下来,OpenJEV 已经很明显分成了四派: 1. 直接读现成大模型的答案分数 2. 重新训练专用决策模型 3. 把现有大模型改造成决策模型 4. 用扩散模型直接填答案 「不吐 token,只给概率」这个表面形式确实不难复刻。 真正拉开差距的还是准确率、泛化和概率校准。模型敢报 90%,这个 90% 到底有多可信,才是最难的部分。