New todaydeepseek-v4.1IMAGE
Mollick: open-weight gap widens on new eval, DeepSeek V4.1 Flash scores 32
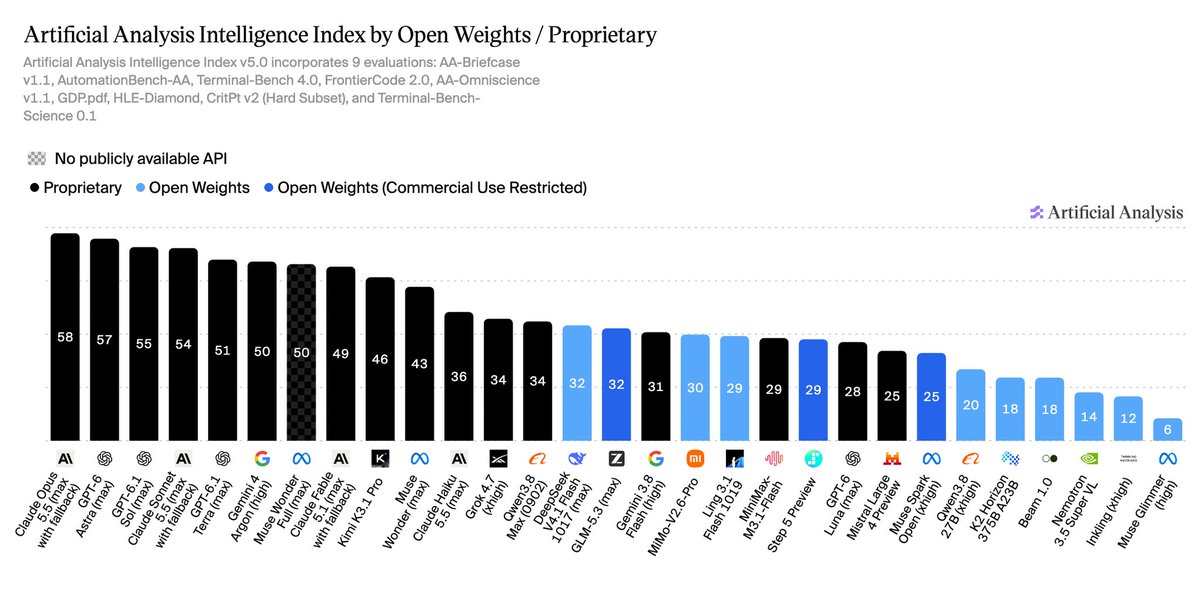
Ethan Mollick comments on Artificial Analysis's v5 leaderboard: with private tests added, open-weight models trail further, with released-weight DeepSeek V4.1 Flash 1017 and GLM-5.3 both at 32 versus a top score of 58.
Ciel 🎒
@0xlunasterlingArchived 7 hours agoOriginally posted 2026.10.28
Ciel 🎒 @0xlunasterlingOriginally posted 2026.10.28
【Mollick:换了评测尺子,开权重模型与前沿的差距更大】 沃顿商学院教授Ethan Mollick评论Artificial Analysis新版榜单:引入非公开测试后,开权重模型落后的幅度,比此前测出来的更大。他同时提醒,对结果仍要保留判断。 按Artificial Analysis发布的v5图表,Kimi K3.1 Pro得分46,距离榜首58分差12分;v4.3的差距为3分。这里有个关键限定:Kimi这款模型的权重尚未发布。 已经放出权重的模型中,DeepSeek V4.1 Flash 1017与GLM-5.3均为32分。Mollick认为,这与他尚未见到Fable级别开权重模型的观察一致。 换版也换了测试口径,分差不能直接当作模型能力倒退。这组数据衡量的是该评测下的能力,成本、部署自由度和具体任务表现仍需分别比较。 #AI #大模型 #开源模型
x.com/0xlunasterling/status/2115280281494298969Archived 2026.10.28 12:02