deepseek-v4.1IMAGE
552B DeepSeek V4.1 Flash runs on a single RTX 4090 at 27 tok/s
A developer's custom Xolotl engine runs the 552B DeepSeek V4.1 Flash on one RTX 4090 via tiered storage and per-expert loading, hitting ~27 tok/s decode with 512K context.
ハカセ アイ(Ai-Hakase)🐾生成AI・ComfyUI
@ai_hakase_Archived 11 days agoOriginally posted 2026.10.19
ハカセ アイ(Ai-Hakase)🐾生成AI・ComfyUI @ai_hakase_Originally posted 2026.10.19
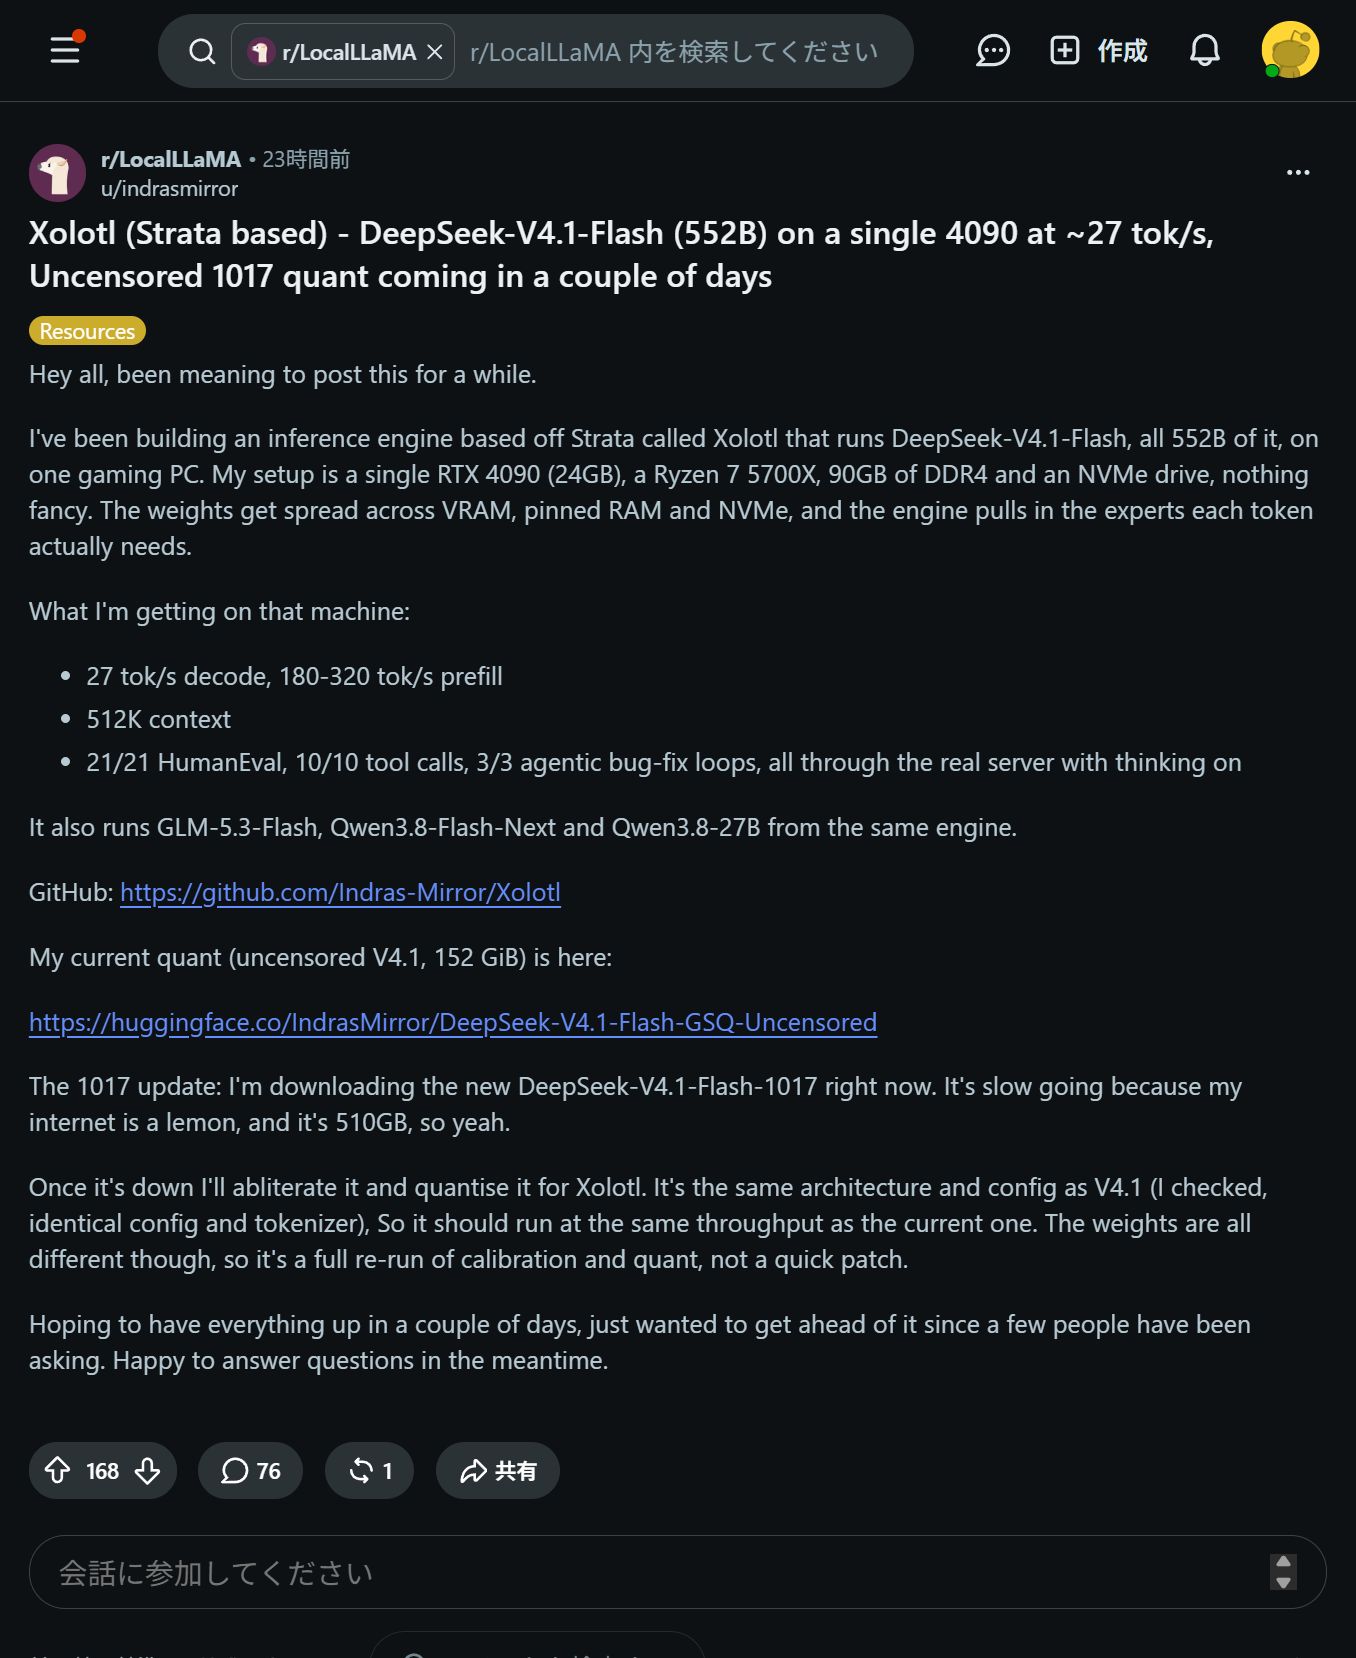
【単一RTX 4090で552Bモデルを動かすカスタム推論エンジン「Xolotl」】 開発者のindrasmirror氏が、Strataベースのカスタム推論エンジン「Xolotl」を構築し、552B(5,520億パラメータ)の超巨大モデル「DeepSeek-V4.1-Flash」を単体のRTX 4090環境で稼働させることに成功しました! VRAM(24GB)、ピン留めされたDDR4システムRAM、NVMe SSDの階層ストレージ間で重みを動的に分散し、推論時に必要なエキスパート層のみをロードする仕組みを採用しています。これにより、デコード速度約27 tok/s、プリフィル速度180〜320 tok/s、そして512Kコンテキスト長の維持を実現しているのが面白いポイントですね! モデルにはper-expert GPTQ(平均2.1 bpw、DenseはQ8_0)などのヘビーな量子化が施されており、ファイルサイズは152 GiBとなっています。オリジナルのAPI等と比較して同じ結論に到達するまでに多めの思考トークンを消費する傾向があるものの、HumanEvalやツール呼び出しなどのベンチマークでは機能がしっかり維持されているとのことです。 #LLM #ローカルAI
x.com/ai_hakase_/status/2112034767092830434Archived 2026.10.20 12:06