Project Maya v1.1.22: 1.6-bit DeepSeek V4.1 Flash fits 128GB memory
The new Maya-XS profile quantizes the 748B MoE's 384 experts to about 1.6 bits so all stay in GPU memory, puts the 161GB Engram table on SSD, and speeds prompt processing ~1.9x on a 9-GPU tp8 setup.
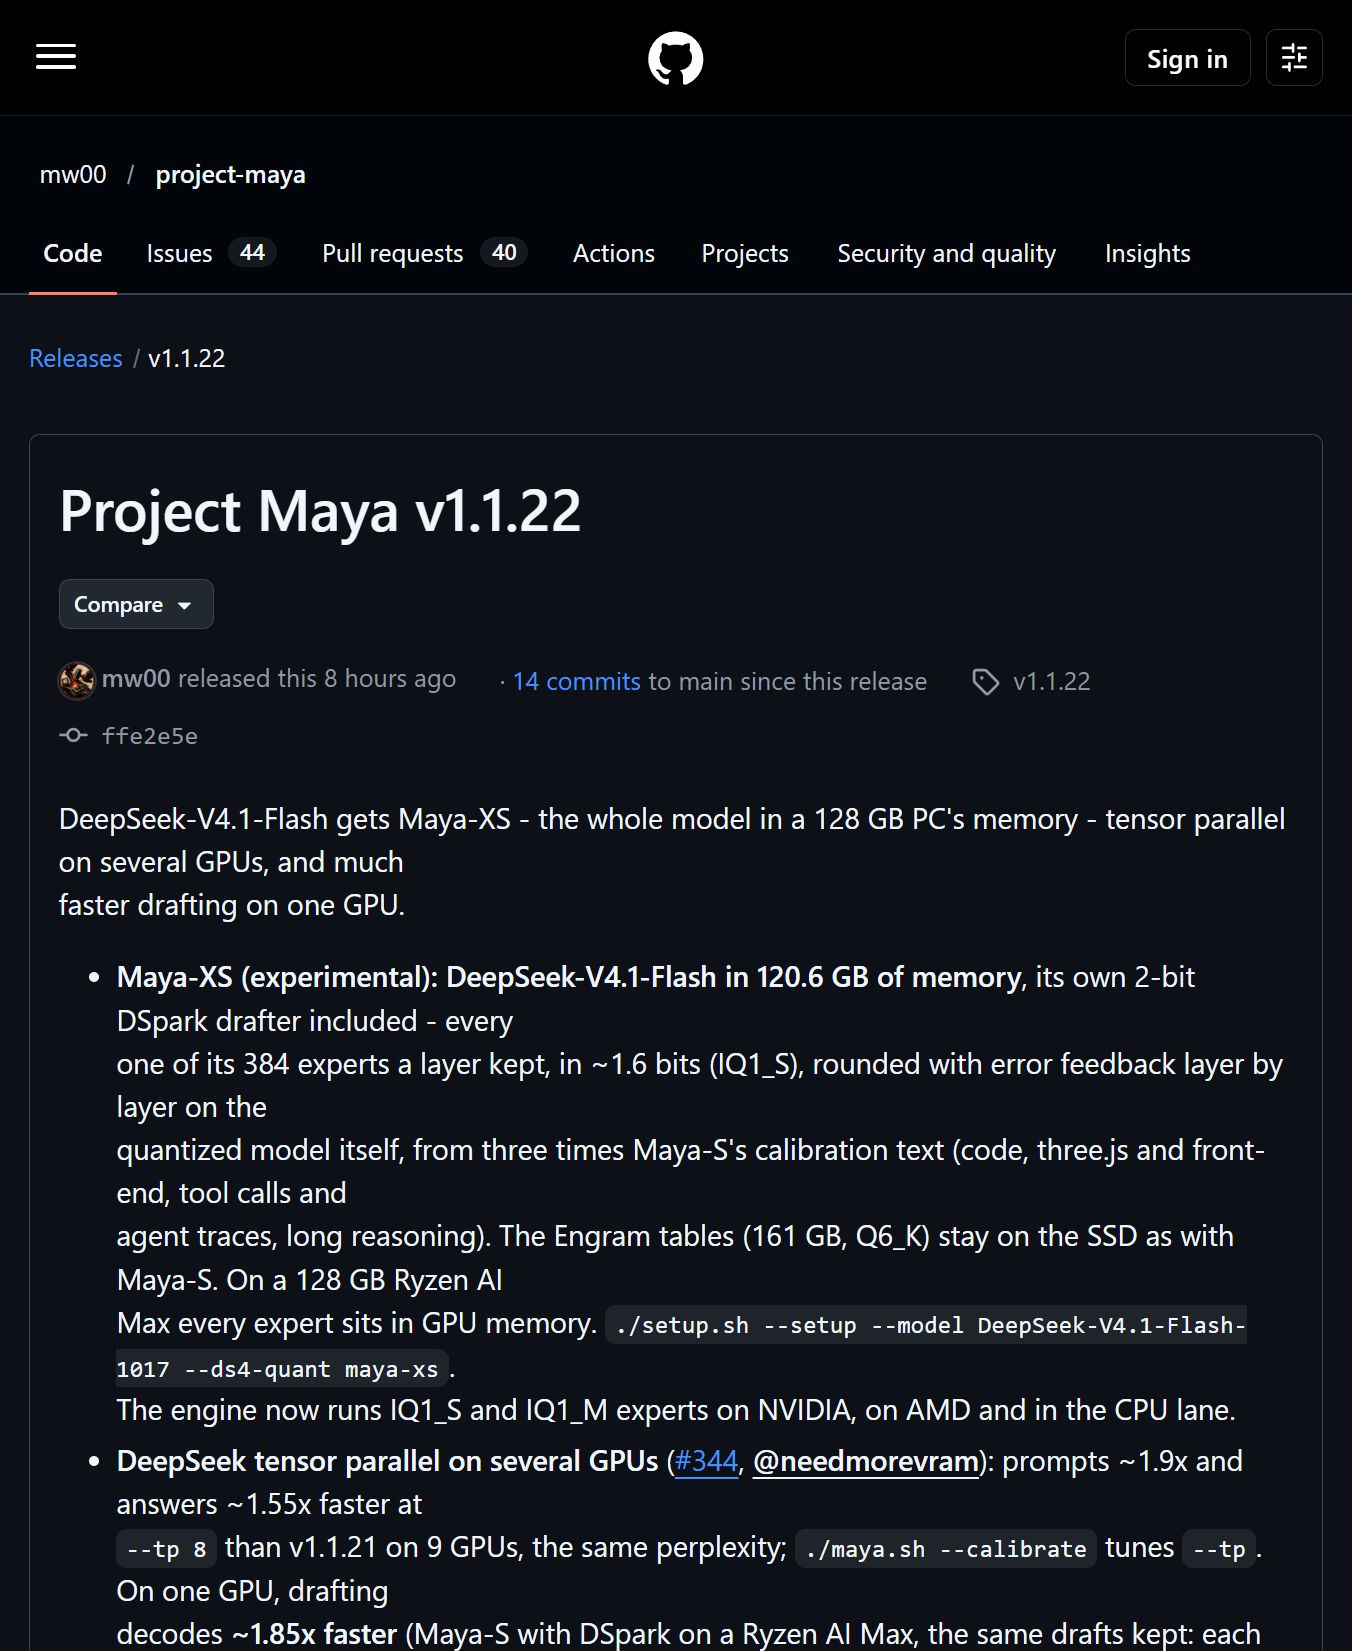
【大規模MoEモデル実行エンジン Project Maya v1.1.22リリース】 大規模Mixture-of-Experts(MoE)モデルのプライベートかつ高速な実行を支援するProject Mayaのv1.1.22が公開されました! 今回のハイライトは、DeepSeek-V4.1-Flash(748B MoE)向けに新規追加された実験的構成「Maya-XS」です。総数384のエキスパートを全層平均約1.6 bits(IQ1_S)で極限量子化し、誤差フィードバックを適用することで、128GBメモリを搭載したRyzen AI Maxなどの環境においてすべてのエキスパートをGPUメモリ内に常駐させることが可能になりました。Engramテーブル(161GB、Q6_K)はSSDに配置する仕組みです! また、パフォーマンス面では、9基のGPUを使用した `--tp 8`(テンソル並列)構成で前バージョン比プロンプト処理が約1.9倍、回答生成が約1.55倍に高速化されています。さらに、AMD環境でのhipBLASLtによるハング修正や、Windows環境での非バッファ型Engram読み込みの導入によるプロンプト処理の高速化など、マルチプラットフォームでの最適化も大きく進んでいますね。セットアップは `./setup.sh --setup --model DeepSeek-V4.1-Flash-1017 --ds4-quant maya-xs` から実行可能です。 #ProjectMaya #LLM