llama.cpp PR #28696 adds full DeepSeek V4.1 Flash support
The PR covers runtime graph and chat template, fixes FP8 scale blocks from [128,128] to [32,32], and adds block-quantized disk-backed memmap for ~393GB ENGRAM tensors; a 121GiB machine converted end-to-end under 8GB peak with 507.9GB Q8_0 output.
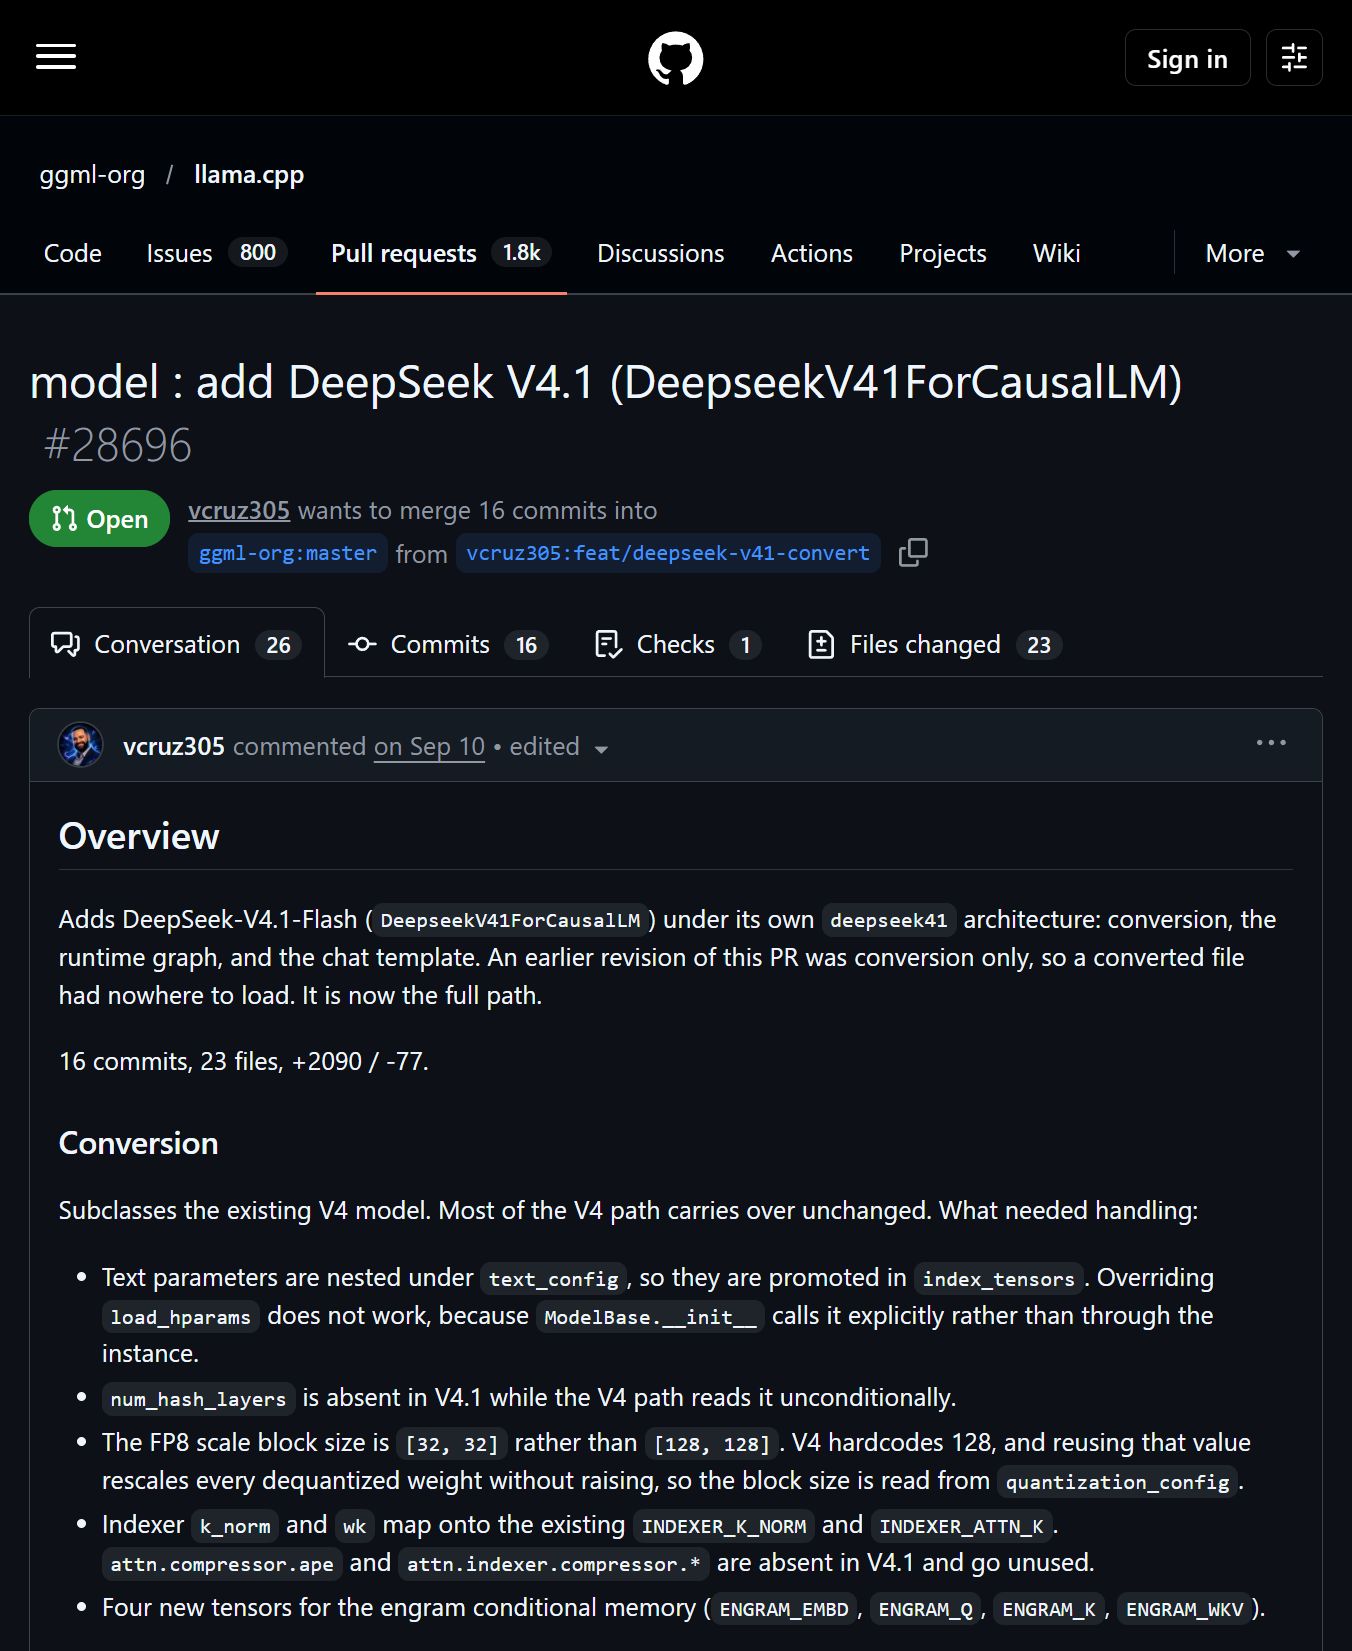
【llama.cppにDeepSeek-V4.1-Flashサポートが追加!】 llama.cppのPull Request #28696にて、新モデル「DeepSeek-V4.1-Flash」(内部クラス名:deepseek41)のフルパスサポートが提案されています! 単なるコンバーター追加ではなく、ランタイム計算グラフやチャットテンプレートまで網羅した実装になっているんです。 主な変更点や注目ポイントはこちらです! - FP8スケールブロックサイズがV4の [128, 128] から [32, 32] に変更されており、正しく読み込むよう修正されています! - 約393GBに達する巨大なエングラム条件付きメモリ(ENGRAM_EMBDなど4つの新テンソル)に対し、行ブロック単位で量子化してディスクバックドなmemmapへ蓄積する専用パスを実装しています! - スパースアテンションの圧縮率比率やヘッド正規化の仕様変更によるサイレントな失敗を防ぐため、ローダーが各レイヤーの役割を動的に導出する仕組みが組み込まれています! RAM 121 GiBの単一マシンによるエンドツーエンド変換テストも実施されており、ピークホストメモリ8GB未満で、Q8_0(MXFP4エキスパート込み)出力サイズ507.9 GBなどが実測されています。実務でのローカル推論検証において重要なアップデートですね! #llama.cpp #DeepSeek