llama.cpp PR benchmarks 763B DeepSeek V4.1-Flash at 23.79 tok/s on an RTX 5090
llama.cpp PR #31086 shares local benchmarks of the ~763B DeepSeek V4.1-Flash at UD-IQ2_XXS on a 9950X3D, RTX 5090 and 192GB RAM: ~174.4GB RAM, ~29.5GB VRAM, 324 tok/s prefill and 23.79 tok/s generation.
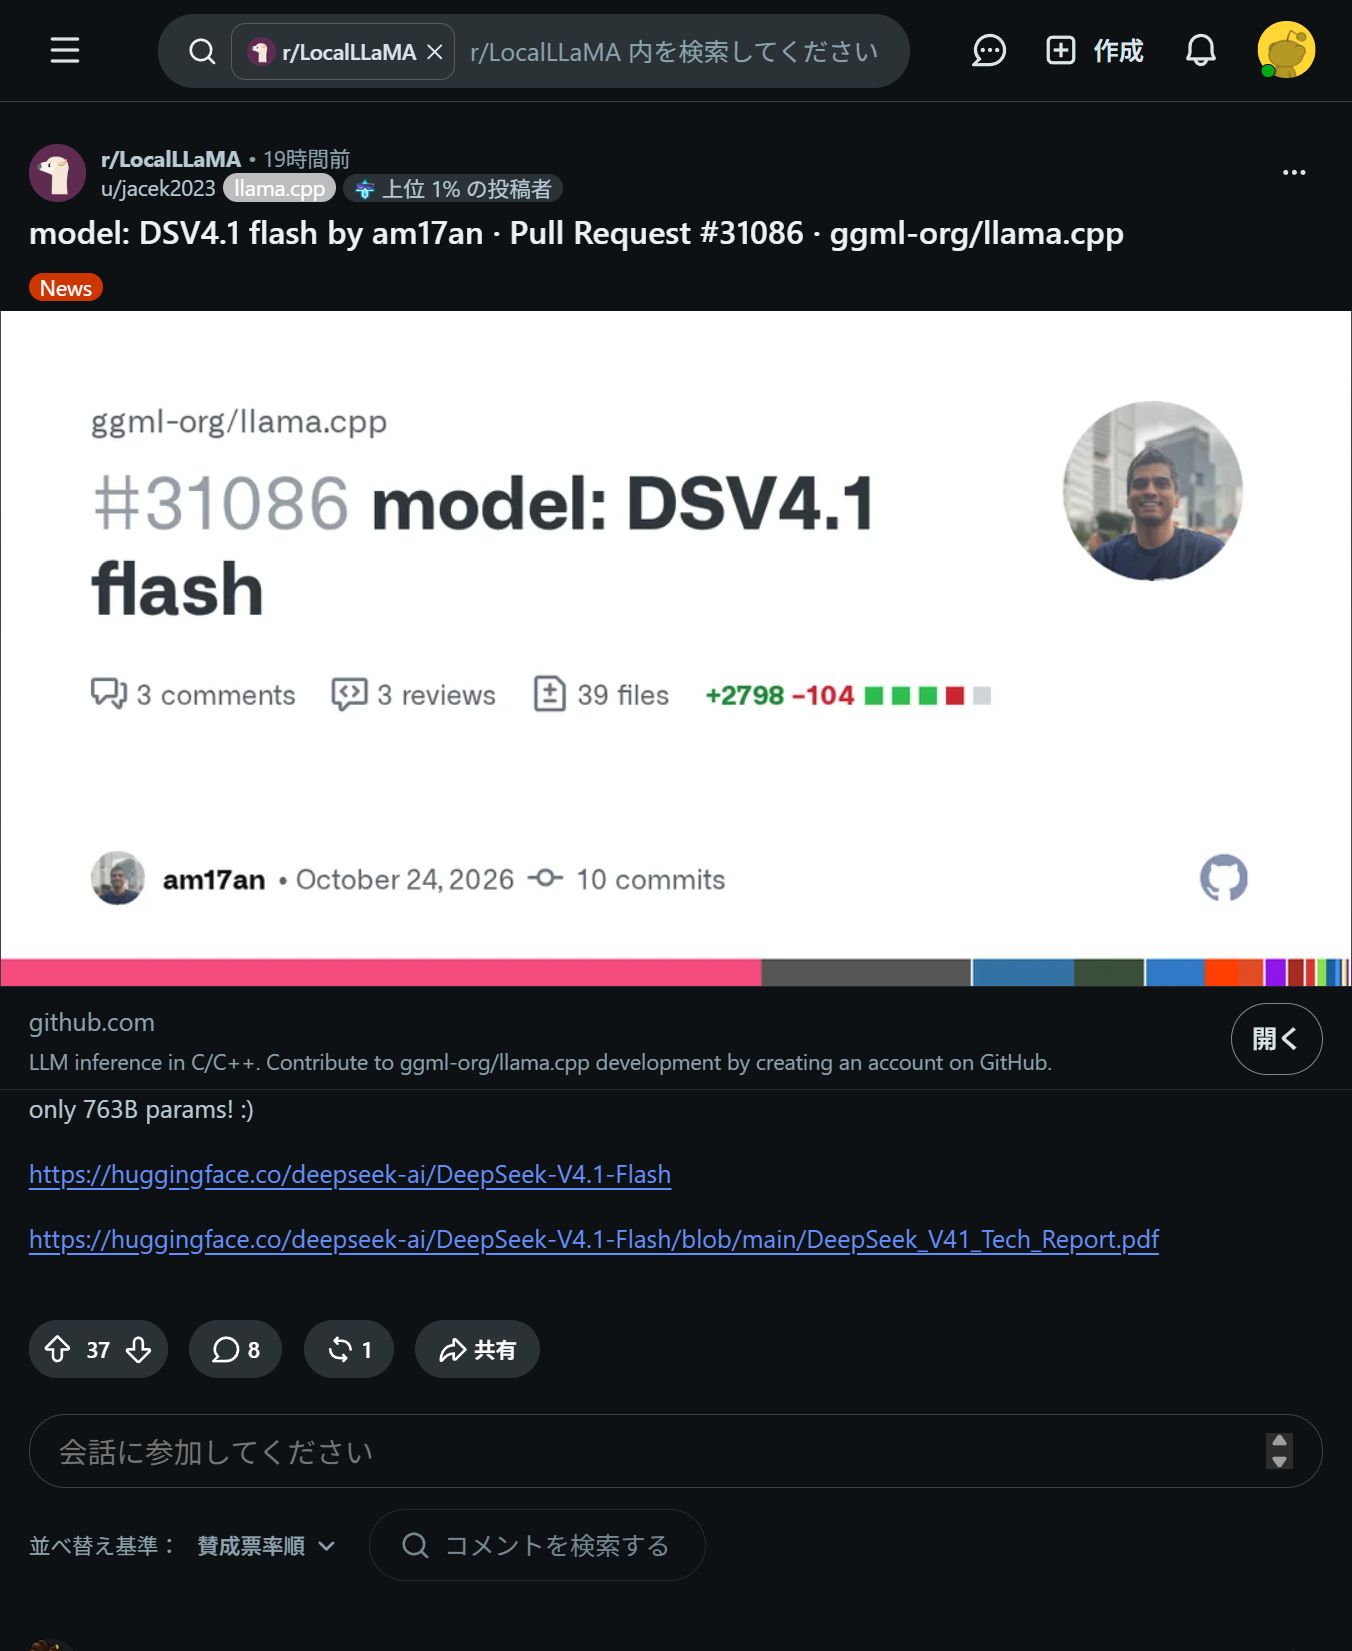
【DeepSeek-V4.1-Flashをローカル環境で動かすllama.cppの設定とパフォーマンス検証】 llama.cppのPR #31086にて提案されている、約763Bパラメータの巨大モデル「DeepSeek-V4.1-Flash」のローカル実行検証データが公開されました! Ryzen 9 9950X3DとRTX 5090、192GB RAMを搭載した環境で、GGUF量子化バリアント(UD-IQ2_XXS)を用いた実測値が示されています。実行時のメモリ消費量はRAMが約174.4GB、VRAMが約29.5GBに達するそうです! 注目すべきポイントは、モデル設定における「moe-cache-mib = 10000」の追加で、これがMoE(Mixture of Experts)モデルのパフォーマンス向上に非常に大きな効果を発揮するとのこと。さらに、override-tensorによるCPUオフロードやn-cpu-moeの調整を組み合わせることで、プロンプト処理が約324.40 tokens/sec、トークン生成が約23.79 tokens/secで動作していますね。超巨大モデルをローカルで運用する際の良いリファレンスになりそうです! #llama.cpp #DeepSeek