deepseek-v4.1IMAGE
DeepSeek V4.1 Flash low-bit GGUF: 2.00 bpw runs on a single 12GB GPU
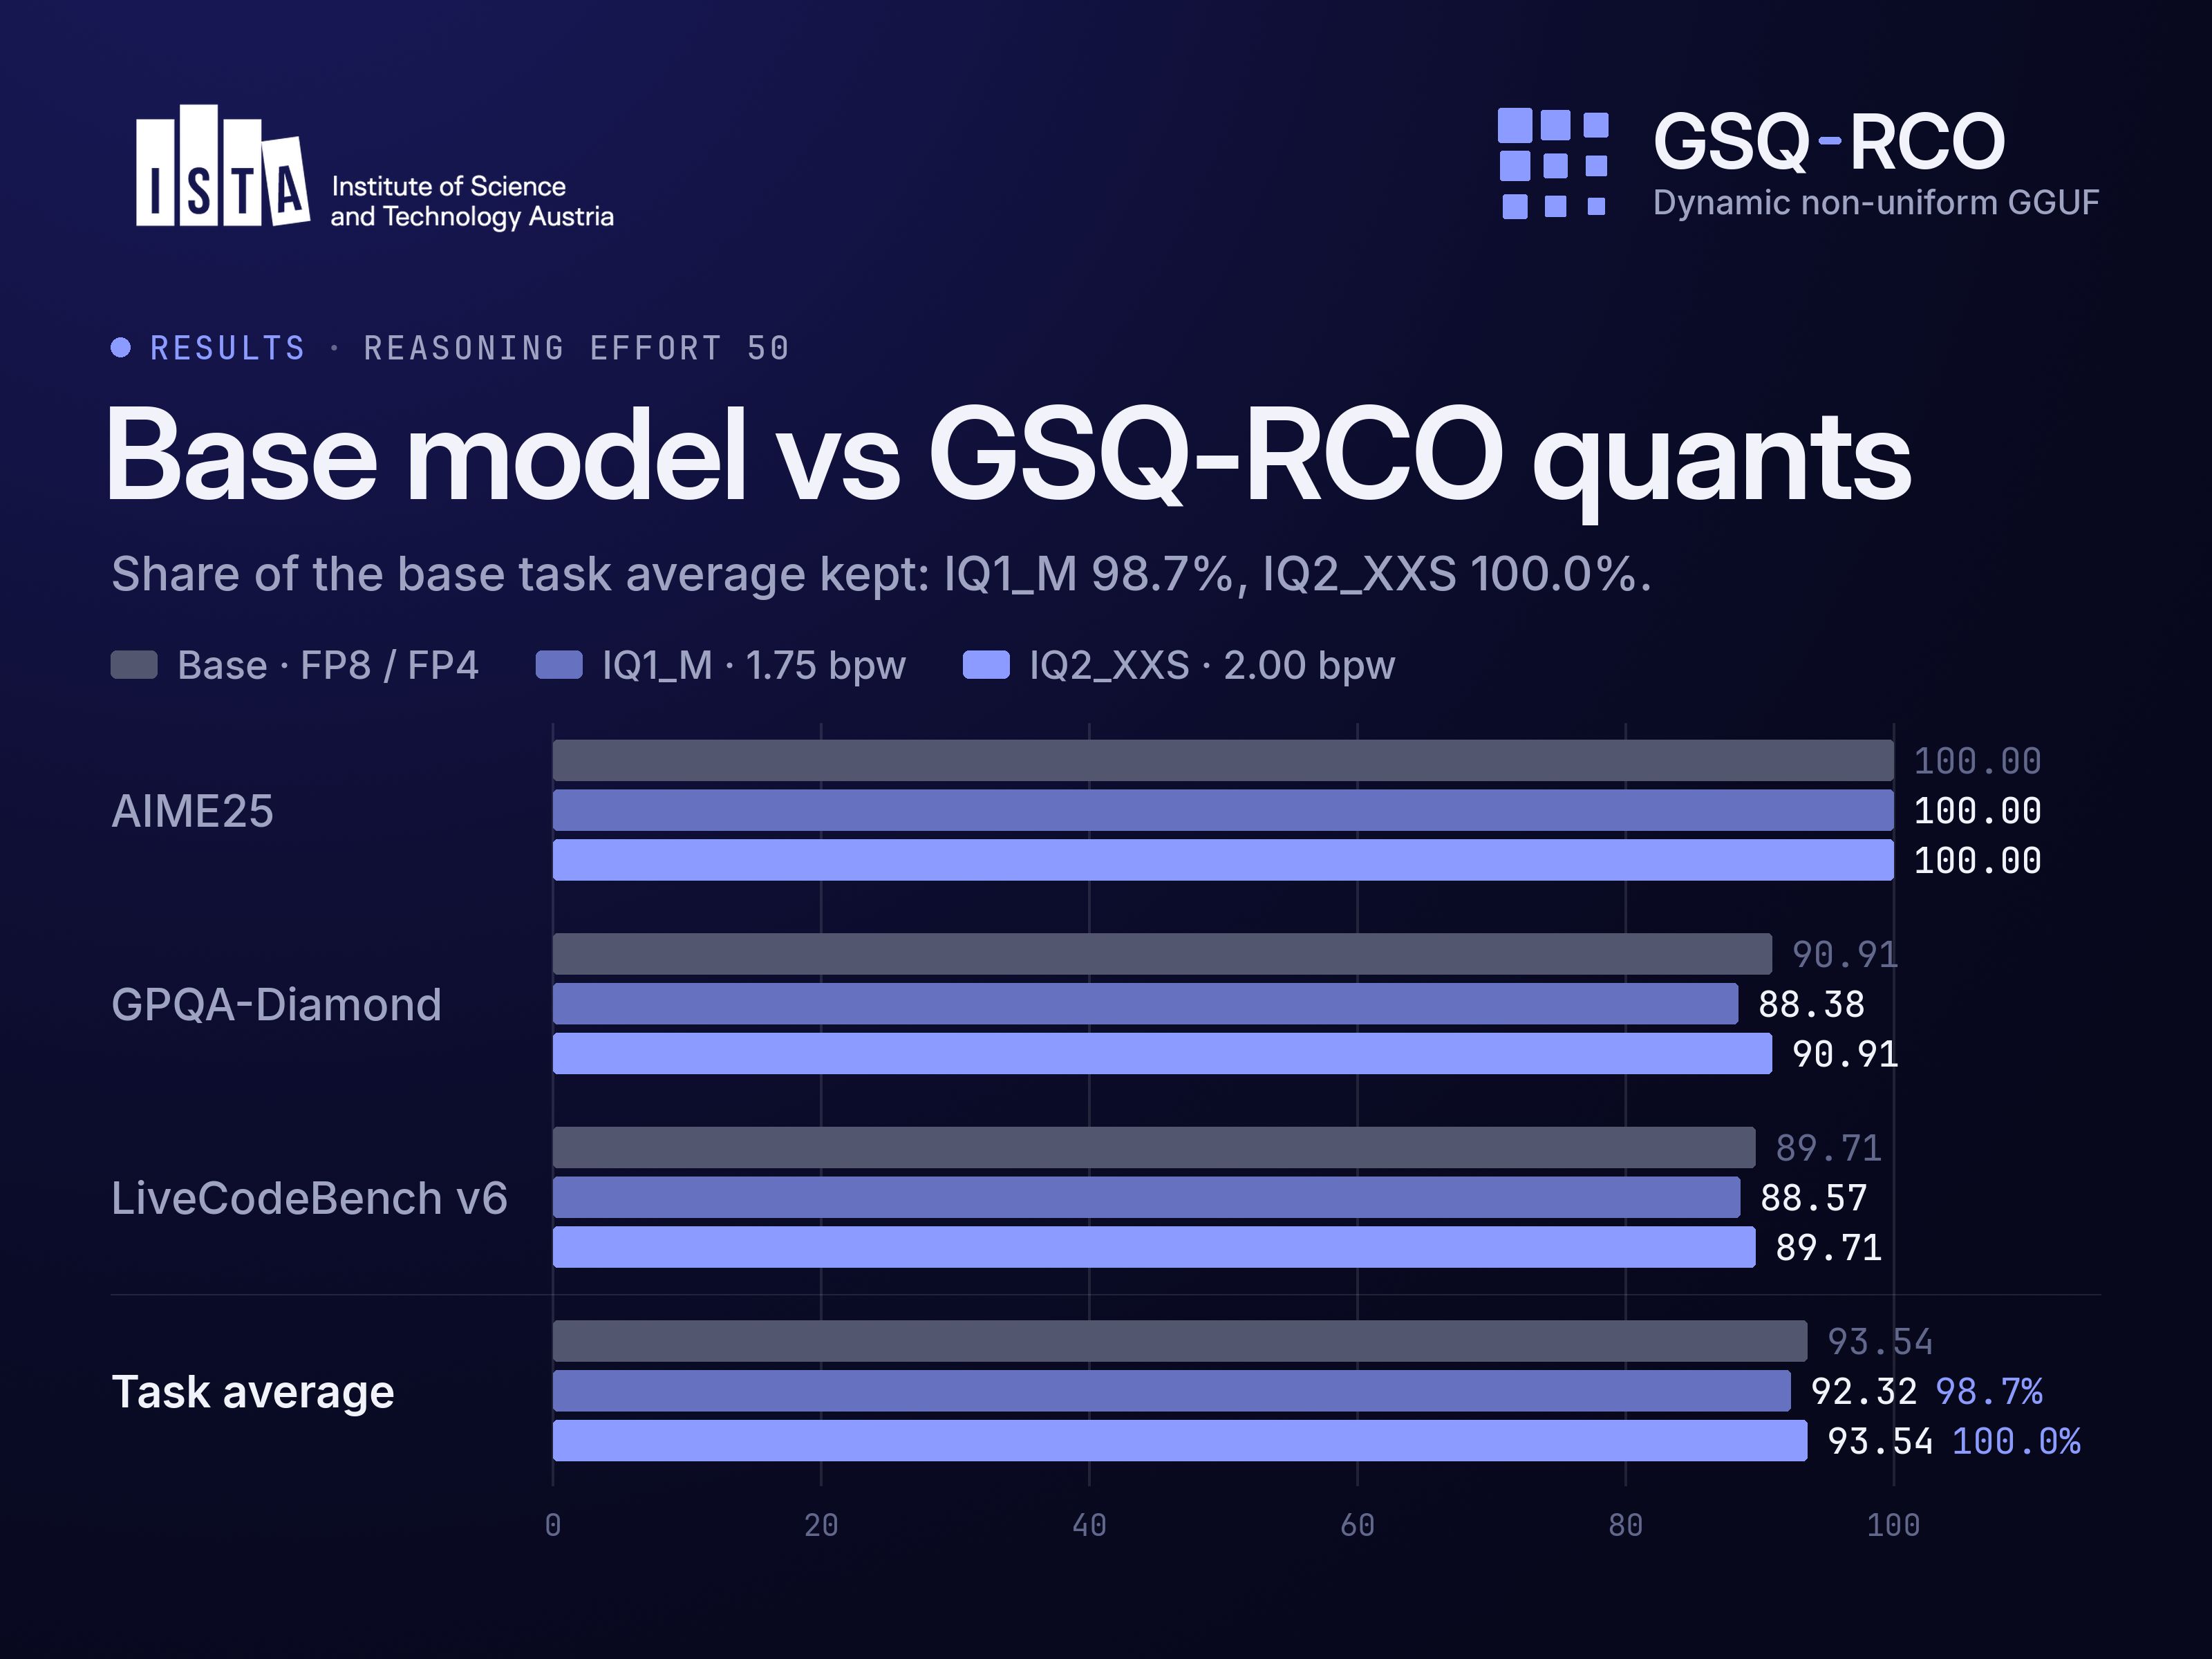
Austria's DASLab quantized the 763B-parameter MoE to 2.00 bpw (138.2GB), claims it matches the base model on AIME25 and GPQA-Diamond, and runs it on one 12GB GPU via a memory-mapped 110.6GB Engram file using a custom Strata runtime.
ハカセ アイ(Ai-Hakase)🐾生成AI・ComfyUI
@ai_hakase_Archived 3 days agoOriginally posted 2026.10.26
ハカセ アイ(Ai-Hakase)🐾生成AI・ComfyUI @ai_hakase_Originally posted 2026.10.26
【DeepSeek-V4.1-Flash-1017の超低ビットGGUFリリース】 オーストリア・インスブルック工科大学のDASLabチームが、7,632億パラメータの超巨大スパースMoEモデル「DeepSeek-V4.1-Flash-1017」を独自手法で量子化したGGUF形式を公開しました! 新手法の「GSQ」と「RCO」を用いることで、2.00 bpwの「IQ2_XXS」クラス(バックボーンサイズ138.2GB)において、数学や科学の評価ベンチマーク(AIME25やGPQA-Diamondなど)でベースモデルの性能を完全に再現しているんです!さらに、全モデルで共有する110.6GBの「Engram」ファイルをディスクからのメモリマップトで処理する設計により、12GB VRAMの単一GPUでも動作可能になっていますね! llama.cppは未対応のため、専用ランタイム「Strata」を利用する形になりますが、ローカルLLM運用のハードウェアの壁を大きく下げる画期的な成果ですね! #DeepSeek #ローカルLLM
x.com/ai_hakase_/status/2114553871318024670Archived 2026.10.26 12:03