deepseek-v4.1IMAGE
DeepSeek V4.1 Flash vs Sonnet 5.5 and Grok 4.7 on a finance module: ~80/100, ¥4 per task
In a controlled test building a finance module, DeepSeek V4.1 Flash (max) scored about 80/100, close to Sonnet 5.5 High and on par with Grok 4.7 in code, at roughly ¥4 per task versus 1% of weekly Claude quota.
C.X
@Brucelee0629Archived 7 days agoOriginally posted 2026.10.24
C.X @Brucelee0629Originally posted 2026.10.24
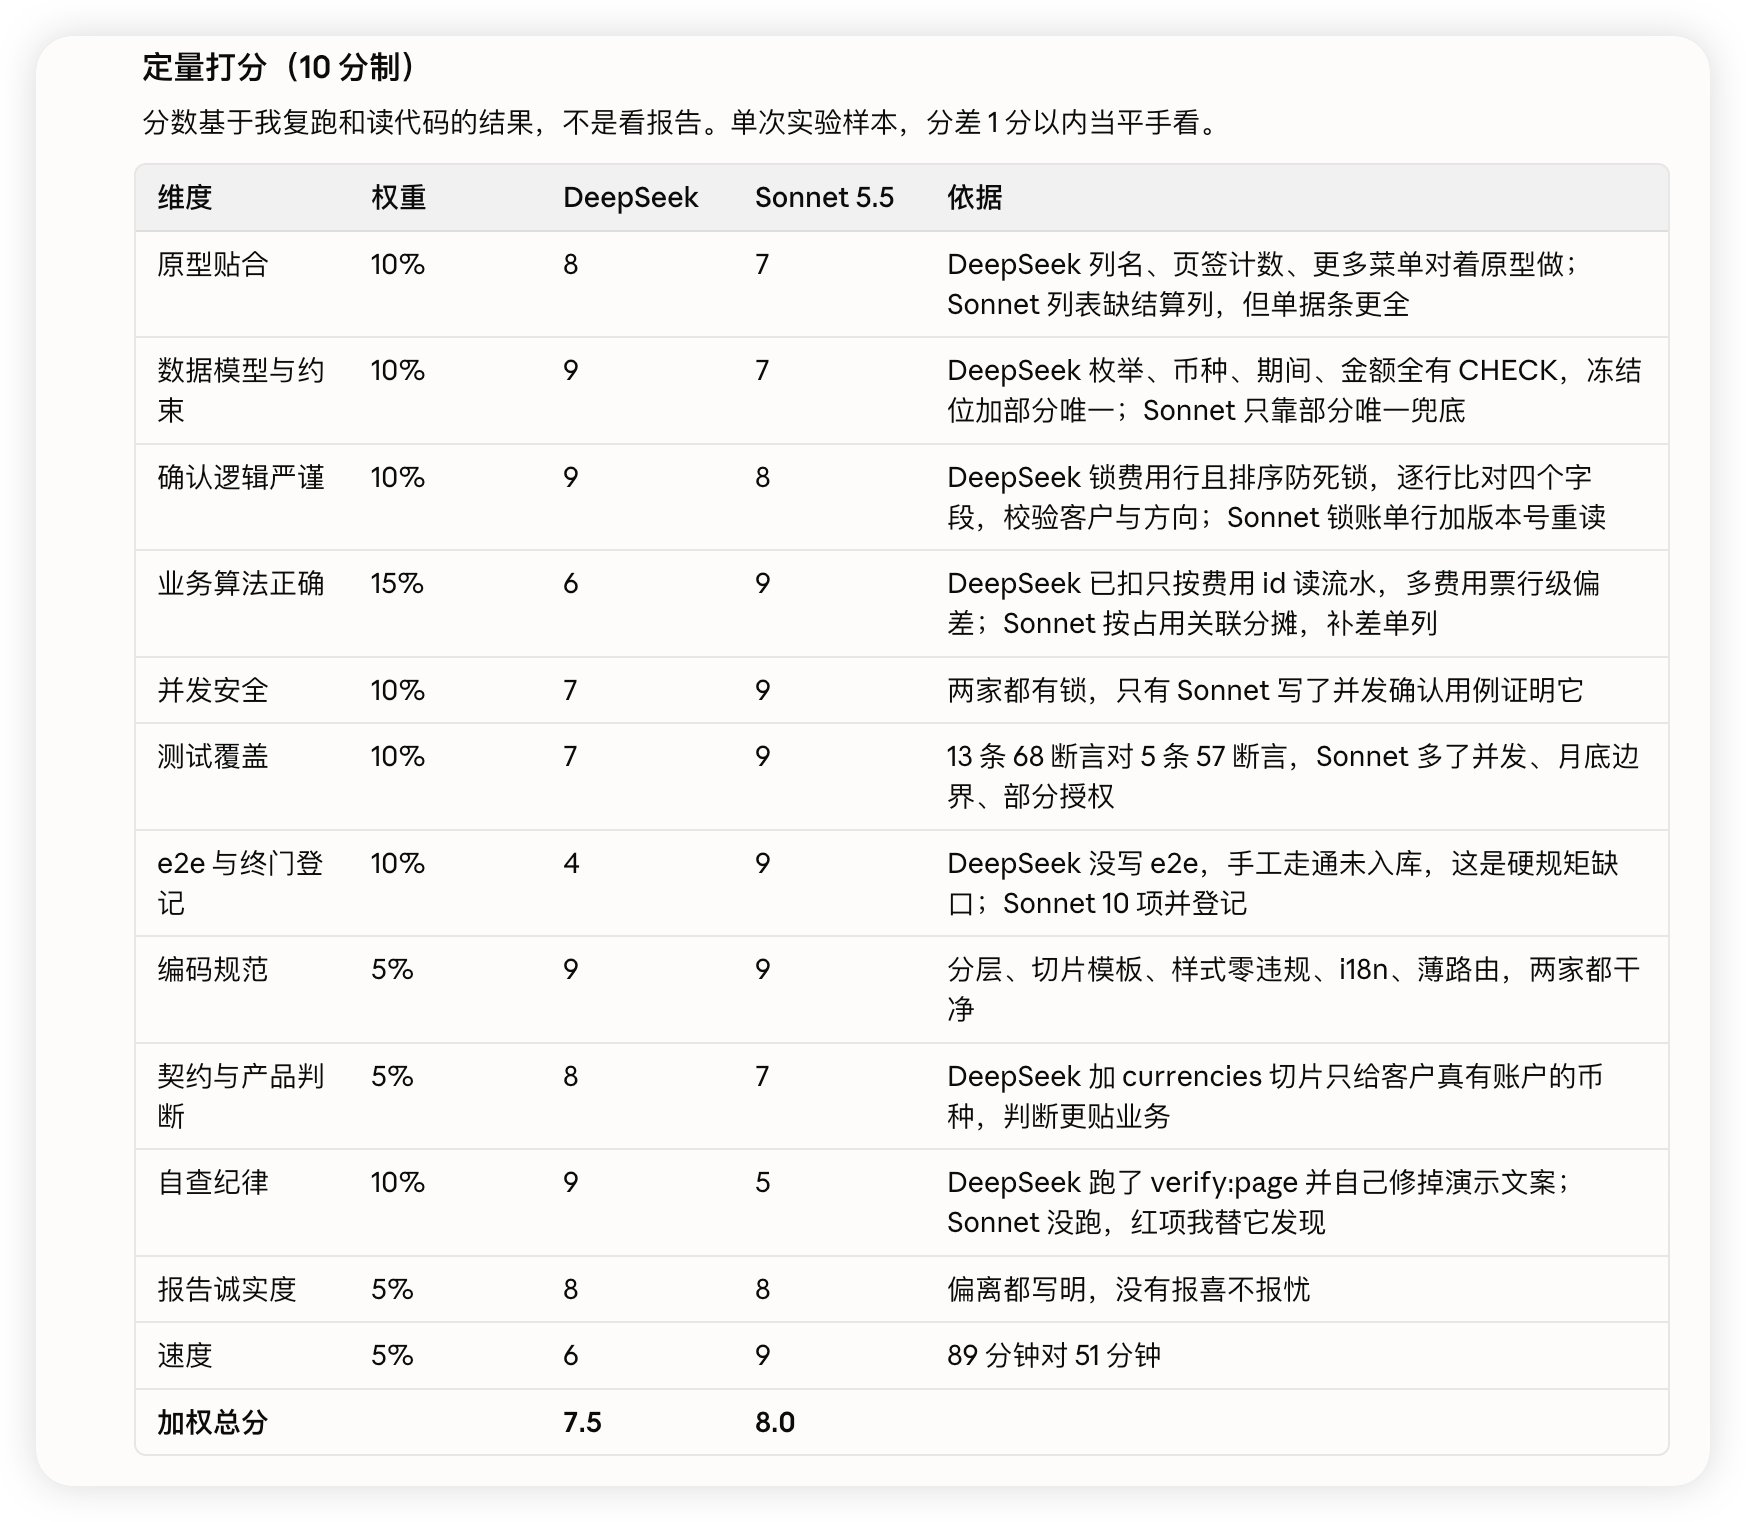
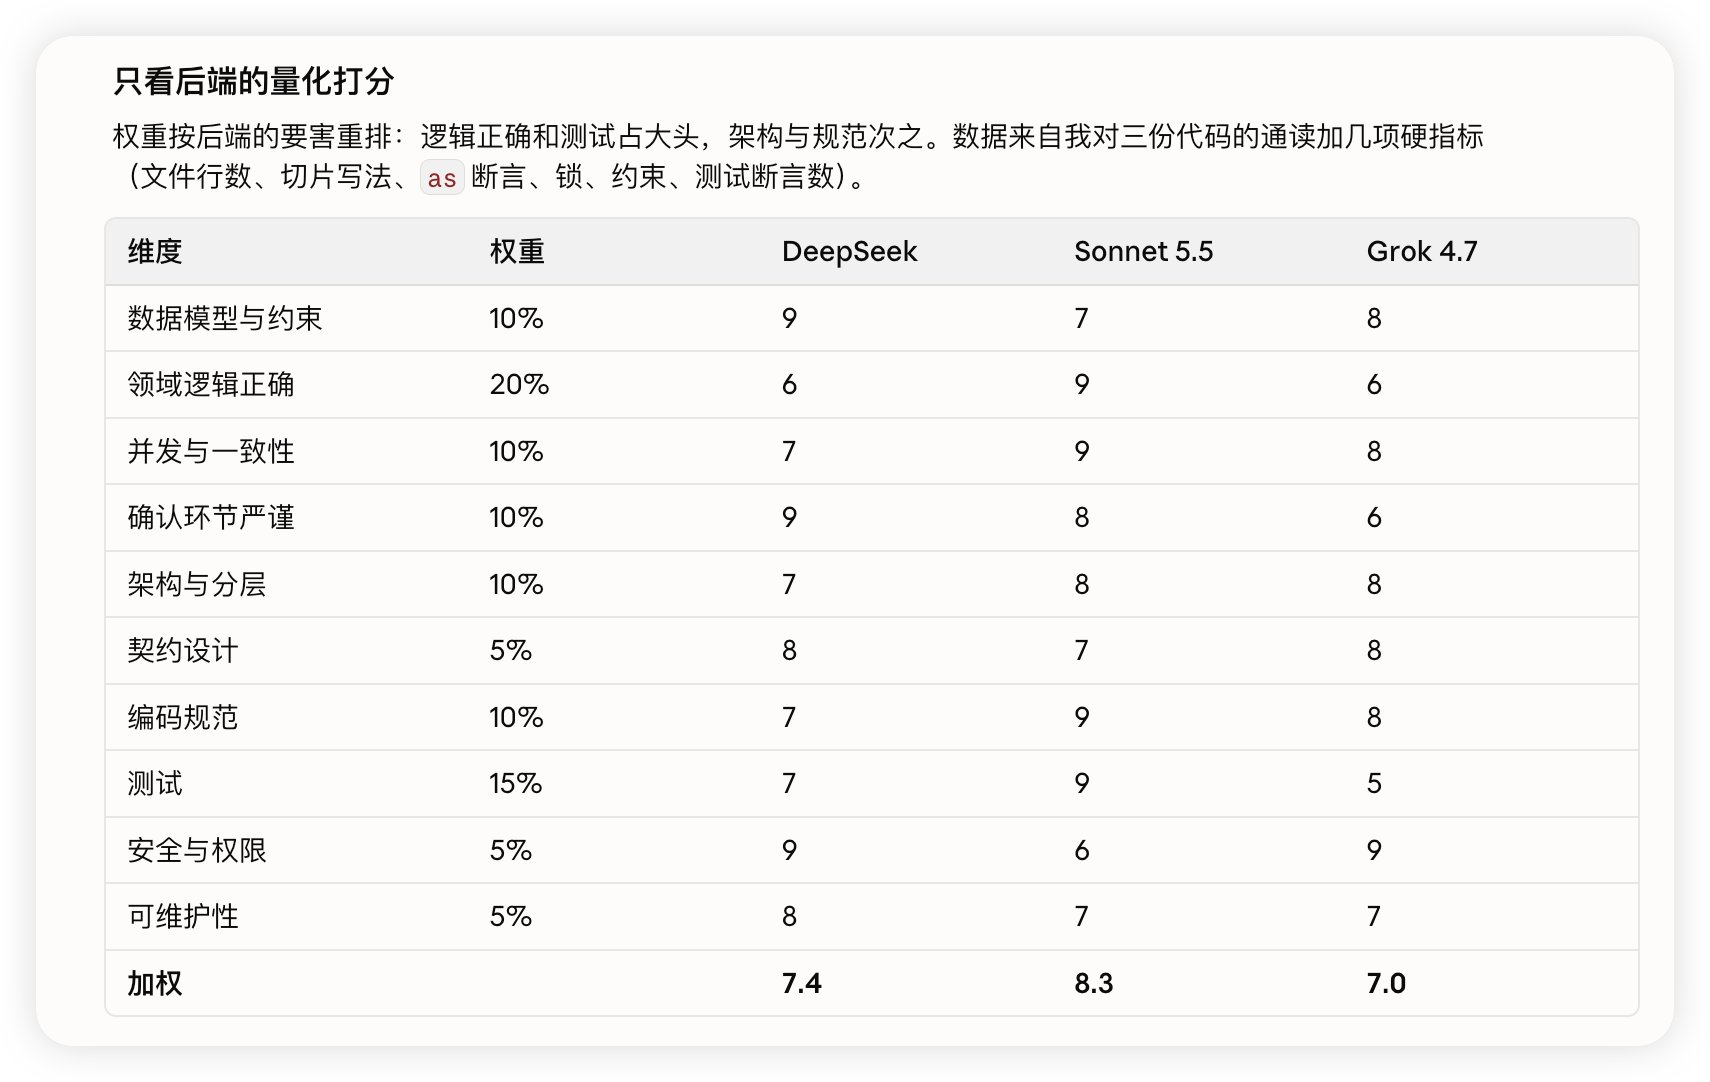
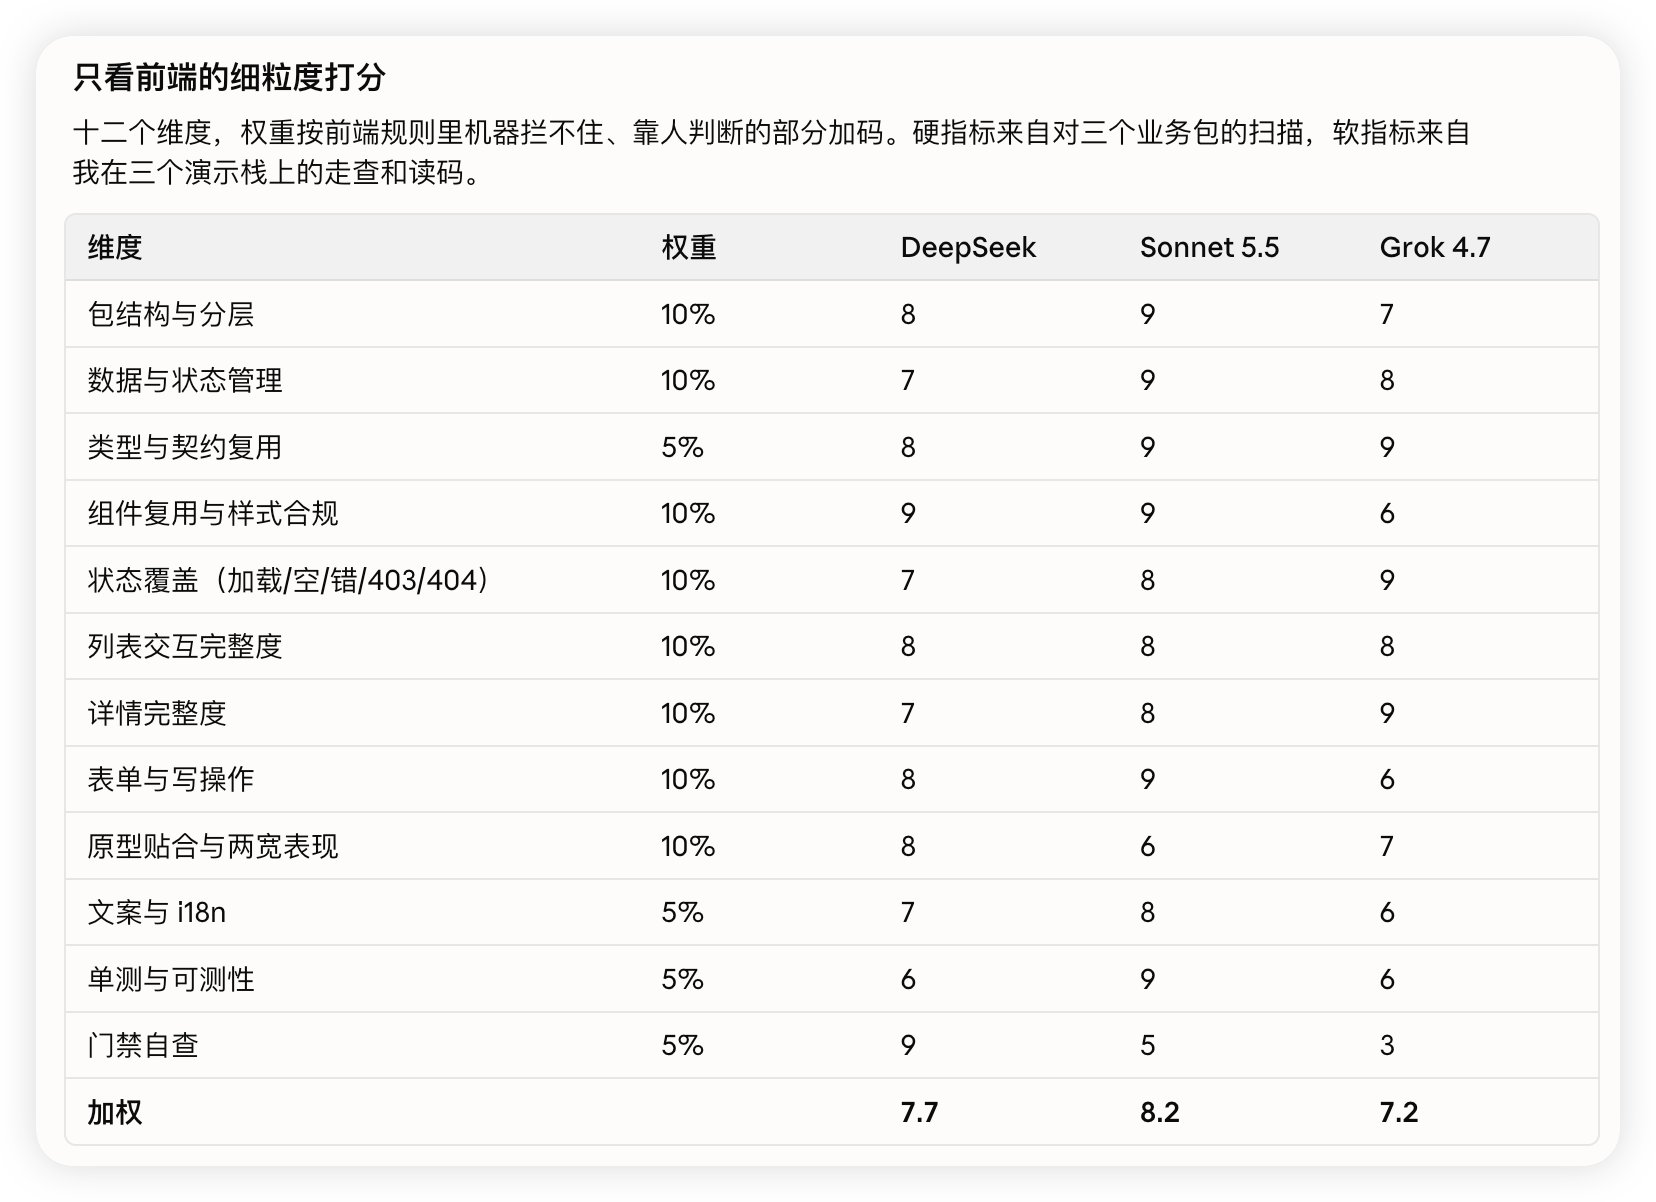
离了大谱了,Claude 居然是现在最具性价比的模型。。。 今天在一个中后台场景下,做了一个财务板块的功能。 在控制变量的情况下,测试下面 3 个模型: - DeepSeek V4.1 Flash(max) - Grok 4.7(xhight) Fast - Sonnet 5.5(high) 实测下来,DeepSeek 大概接近 Sonnet 5.5 High 的水平。综合用下来的体感,写出的代码和 Grok 4.7 差不多,但交互体感比 Grok 4.7 舒服一些。 体感上,如果量化打分: Opus 5.5 是 100 分的话,Sonnet 5.5 可能是 85 分,DeepSeek 可能是 80 分,Grok 4.7 70-80 分这样. 一个任务下来,大概 DeepSeek 要消耗 ¥4 左右;Grok 要消耗 Grok build 5% 左右的周额度(我是 Super Heavy 套餐);而 Claude 这边大概只消耗了 1% 的周额度。
x.com/brucelee0629/status/2113829731535826983Archived 2026.10.24 12:07