deepseek-v4.1IMAGE
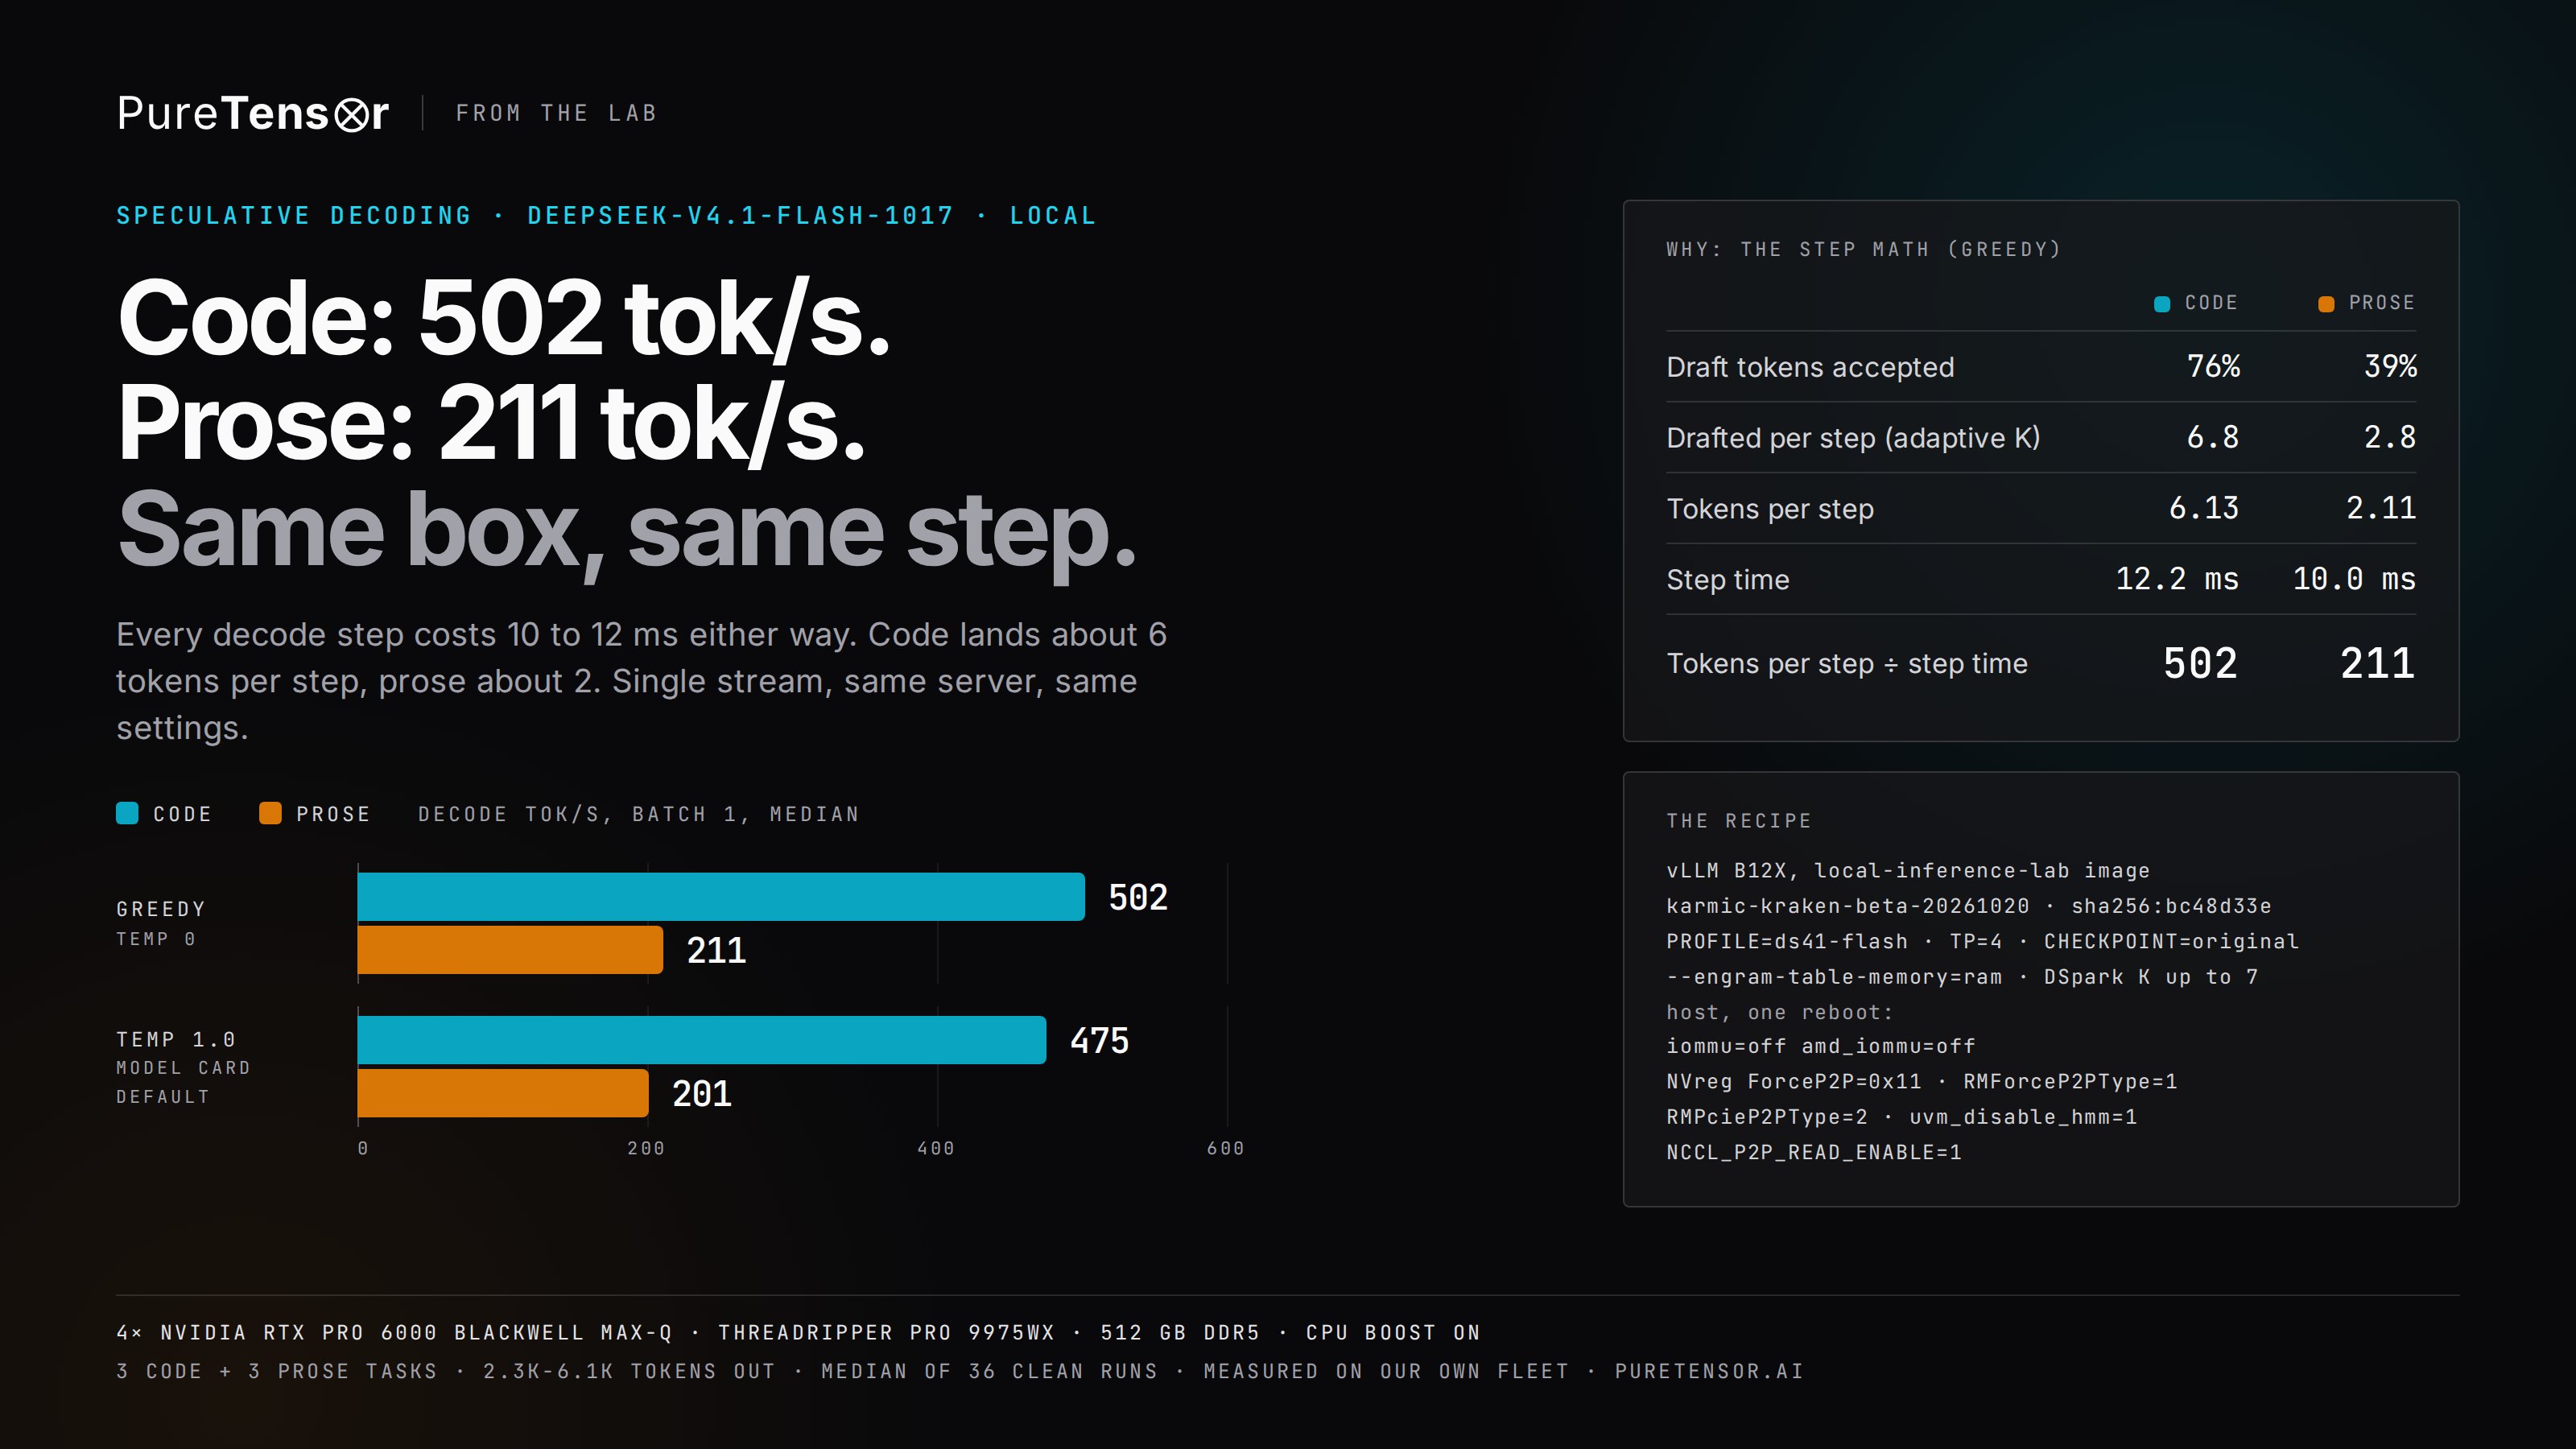
DeepSeek V4.1 Flash speculative decoding: 502 tok/s on code vs 211 on prose
On one workstation, code hits 502 tok/s with 6.1 tokens per step and 76% draft acceptance, while prose gets 211 tok/s at 2.1 tokens and 39%, showing spec-decoding numbers depend on prompt type.
Dataphile
@Dataphil3Archived 9 days agoOriginally posted 2026.10.23
Dataphile @Dataphil3Originally posted 2026.10.23
Same box. Same model. Code: 502 tok/s. Prose: 211. @deepseek_ai V4.1-Flash-1017, batch 1, one workstation: code lands 6.1 tokens per step (76% of drafts accepted) prose lands 2.1 (39%) step time: 12 vs 10 ms Spec decoding benchmarks measure your prompt. #DeepSeek #LocalLLM
x.com/dataphil3/status/2113441874241278439Archived 2026.10.23 12:06