Recounting 305k real calls: DeepSeek V4.1 Flash cheapest per million tokens at ¥0.1995
Recomputing 305,287 real agent requests at list rates, the author found DeepSeek V4.1 Flash 1017 costs ¥0.1995 per million tokens, below GPT-6 Luna's ¥0.3227 and GLM-5.3-Flash's ¥0.3634, contradicting the Artificial Analysis ranking.
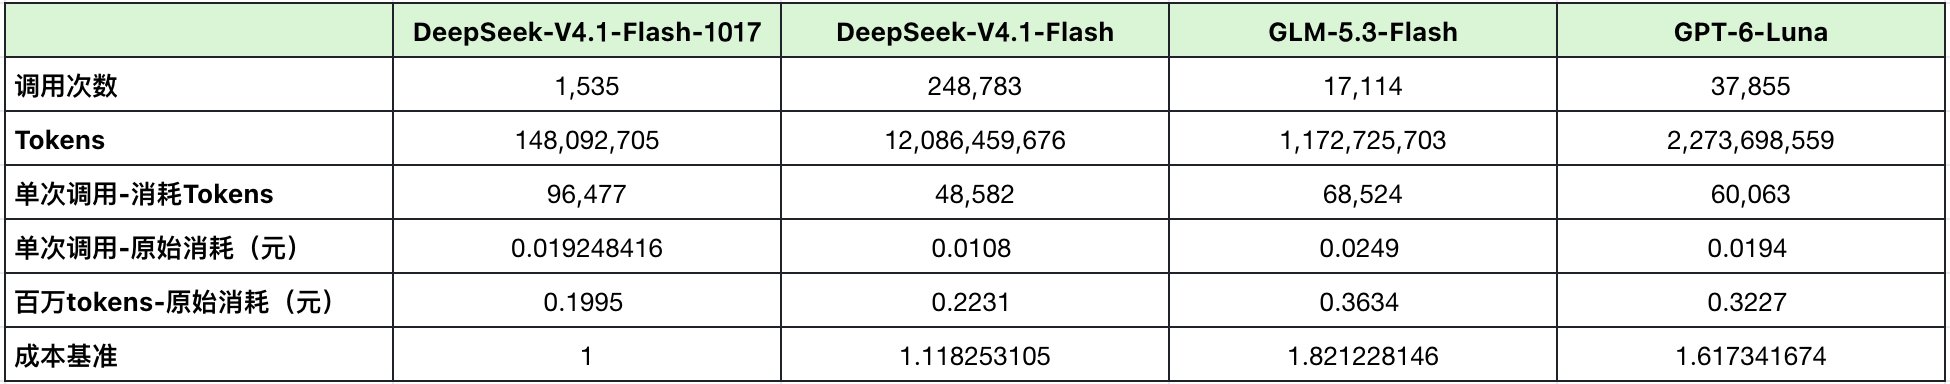
「性价比之王」实测:我拿 30 万次真实调用重算了 DeepSeek、GLM、Luna 先说结论,因为它和你在任何榜单上看到的都不一样。 按 OpenAI 的价目表: • GPT-6 Luna 最便宜,输入 $0.10、输出 $0.50,这一档里没有对手。按 Artificial Analysis 的独立评测,Luna 还是最便宜,每个 benchmark 任务 $0.07; • GLM-5.3-Flash 是 $0.25; • DeepSeek V4.1 Flash 是 $0.27。 然后我拉了我们自己的部分日志,共 305,287 次请求,逐条按 list rate 重算了一遍。DeepSeek 最便宜,GLM 最贵,Luna 卡在中间。 三份数据,两个答案。这个矛盾比任何一份排名都更有价值,因为它直接决定了你的路由该指向谁。 一、真实流量的百万 token 成本 DeepSeek V4.1 Flash 1017 0.1995 元 DeepSeek V4.1 Flash 0.2231 元 GPT-6 Luna 0.3227 元 GLM-5.3-Flash 0.3634 元 价目表解释不了这个差距。输入的单价三家差得不多,输出的单价都在 0.5 到 0.6 美元区间。钱不是花在单价上的。 花在 token 用量上。 二、第三方榜单为什么得出了相反的结论 Artificial Analysis 把三个模型放在同一套十项评测里跑,报的是每任务成本。 GPT-6 Luna 指数 38,0.07 GLM-5.3-Flash 指数 42,0.25 DeepSeek V4.1 Flash 指数 39,0.27 按这张表,Luna 比 DeepSeek 便宜将近 4 倍。按我的日志,DeepSeek 比 Luna 便宜 31%。两边都没算错。 AA 那套评测是十个固定任务:研究生水平的问答、SciCode、Terminal-Bench、GDPval 的办公交付物、长上下文检索。Luna 的设计目标就是答完就停,它花在这上面的成本极低。 我们的流量是 agent 型的。长长的工具调用链,失败的 shell 命令和重试,跨文件的改动。这种活儿不管你换哪个模型,输出都短不了,模型之间的差异被摊平了。 所以「最便宜」不是模型的属性。它是模型和负载组合起来的属性。任何不带负载说明的单一成本数字,本质上都是广告。 这句话值得多想一层:如果你只看榜单选型,你选的是「在 AA 的十个任务上最便宜」;如果你只价目表选型,你选的是「每 token 标价最低」。两个都不是你要的东西。你要的是「我这批活儿,谁最便宜」。 三、按输出形态选,别按价格列选 长链路 agent、终端操作、仓库级重构 → DeepSeek AA 测下来它吞吐最快,每秒 209 token 左右,agent 负载下的混合成本也最低。1017 这一版把 Terminal-Bench 4.0 从 31.2 拉到 42.3,Automation-Bench 到 60.5,这是 DeepSeek 自报的数据、Claude Code harness 跑的,别拿去和 AA 独立测出的 GLM 33% 直接比,harness 都不一样。 如果你的 agent 难点在「怎么把终端开起来」,而不是「怎么写出这段 diff」,从它开始。 要交付给人看的文档:PPT、表格、格式化报告 → GLM AutomationBench-AA 60%,GDPval-AA 1641 Elo,两项都在 Luna 和 DeepSeek 之上。这一档里它单价最贵,做文档活儿的时候这个溢价是值的。另外三家只有它收视频输入。 批量抽取、摘要、分类、RAG → Luna 短请求、规格明确、量大的场景,它确实是这里最便宜的。每任务 $0.07,每秒 128 token。如果你每天要跑几百万次那种「把这段文本里的字段抽出来」的调用,价目表上的优势是真的,它的排版弱点也根本不会露出来。 整本文档、整个代码库 → Luna 在 AA-LCR 上 83%,GLM 80% 三家都给 1M 上下文。DeepSeek 也一样,只是这项评测上落后。 四、榜单不会告诉你的四件事 Luna 那个 38 是 max 档的分数。 默认档位 medium 只有 29.9。八分的差距,来自你有没有按接口去设 reasoning_effort。但 max 档的首 token 延迟接近 90 秒,交互式场景直接用不了。这个参数要按接口调,不能全局设一个。 Luna 的长上下文加价是全单生效的。 输入一旦超过 272K token,整个请求按长上下文价格重新计价,不是只算超出部分。280K 的请求账单差不多是 270K 的两倍,多出来的输入只有 4%。该切块就切块。 GLM 没有关闭思考的开关。 每一分推理 token 都要进预算。你能做的最多是 reasoning_effort: low。 DeepSeek 1017版最省钱。 能力增强,输出变短,值得切换。