Infinite-parameter LLM writes new knowledge into weights mid-conversation
A small weight generator turns new facts into temporary in-model plugins during a chat, avoiding repeated long-context reads and beating standard prompting on accuracy and stability with complex material.

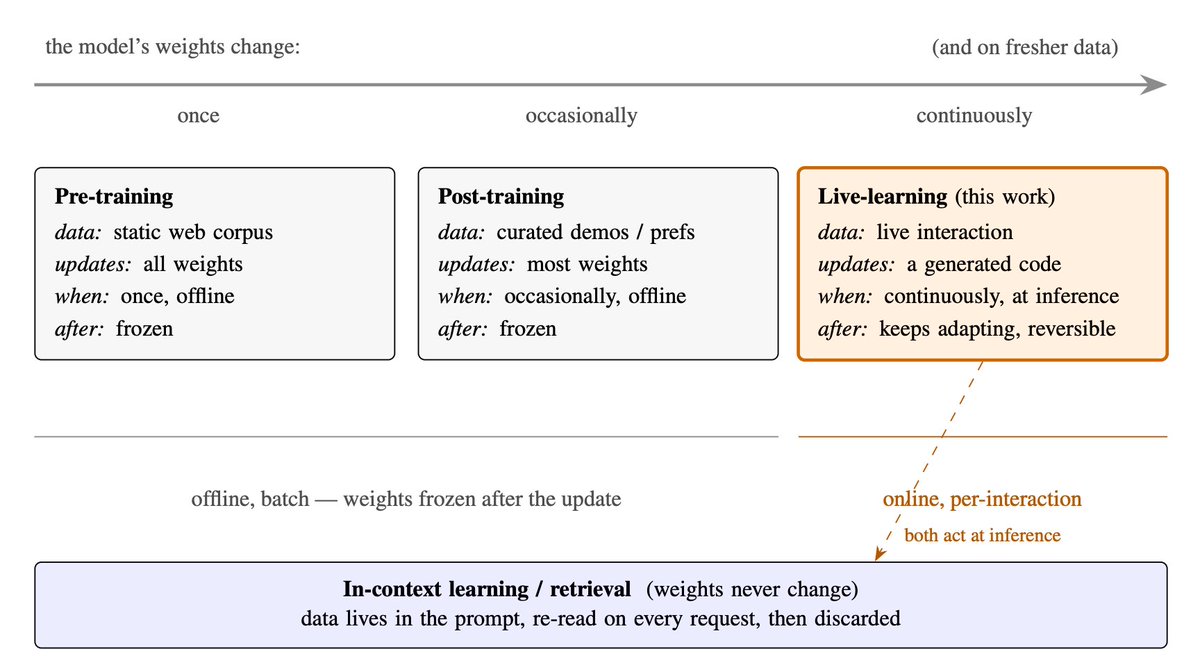
无限参数大语言模型:让AI在与人对话时能“边聊边学” 现在的AI模型一旦训练完成,它内部的“大脑结构”(也就是模型权重)就被彻底固定了。我们平时给AI补充资料、纠正错误,其实只是把这些文字硬塞进对话框里。AI每回答一句话,都得把这堆文字从头到尾重新读一遍,对话一关,这些新知识就被忘得一干二净。 这项研究换了个思路:既然每次塞进对话框太费事,不如直接把新知识实时写进AI的“临时大脑”里。 研究人员设计了一个体积很小的“权重生成器”。当你给AI发来新事实、新文档或者修正意见时,这个小模块会直接把这些内容快速转译成AI内部的一组临时小插件。这样一来,AI就不需要把厚厚的一叠参考资料一直摆在桌面上反复看,新知识已经变成了它脑子里自带的一部分。 整个机制主要有三个好处: · 越聊越聪明:随着对话深入,AI对当前话题的理解会持续积累,遇到含糊不清的问题也能准确理解。 · 运行更轻快:参考资料不用每次都占用宝贵的对话字数,每次生成回答都省去了反复阅读长文本的算力。 · 资源消耗极小:它不需要像传统微调那样花几小时重新训练模型,只需要一次极快的单向计算就能生成插件,占用的存储空间也从几十GB缩减到了几十MB。 虽然论文名字里带有“无限参数”,但它真正的意思不是AI的记忆力变得无穷大,AI的基础容量依然受本身大小限制。它指的是AI可以根据你提供的海量新数据,实时变化出无穷无尽的新解答状态,而且整个过程中AI本身的体积完全没有变大。 测试结果显示,如果只是读一段几十个字的小短文,直接在对话框里发给AI依然最省事;但只要面对多篇冗长、嘈杂或者需要反复推理的复杂资料,这种把知识直接变成模型权重的做法,准确率和稳定性都明显超过了传统的提问方式。 论文:https://t.co/P5jnTRYlxo