DeepSeek V4.1 Flash 1017 source roundup: official post, HF model card, pricing and Harness release
A link roundup of the official X post, Hugging Face model card, API announcement, pricing page, a third-party hands-on writeup and Harness v0.2.1-rc.2, noting all benchmarks are vendor self-reported and unreproduced.
参考文献 [1] DeepSeek 官方 X:https://x.com/deepseek_ai/status/2111375640717033777 [2] HF 模型卡:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017 [3] 官方公告:https://api-docs.deepseek.com/news/news261017 [4] 价格页:https://api-docs.deepseek.com/zh-cn/quick_start/pricing [5] 欧巴聊AI《实测DeepSeek V4.1 Flash新版本,比想象中凶猛太多了》:https://mp.weixin.qq.com/s/hHdEjo6q8RcPD4d56_fDBA [6] DeepSeek Harness v0.2.1-rc.2:https://github.com/deepseek-ai/deepseek-harness/releases 感谢「欧巴聊AI」公开分享实测过程,五个 demo 很值得一看,原文见 [5]。 说明:独立分析,非同行评审;所有跑分都是 DeepSeek 官方自测,我本人没有跑这些基准,也没有复现 demo,只是对公开数据做二次分析。
This post quotes another post: x.com/deepseek_ai/status/2111375640717033777
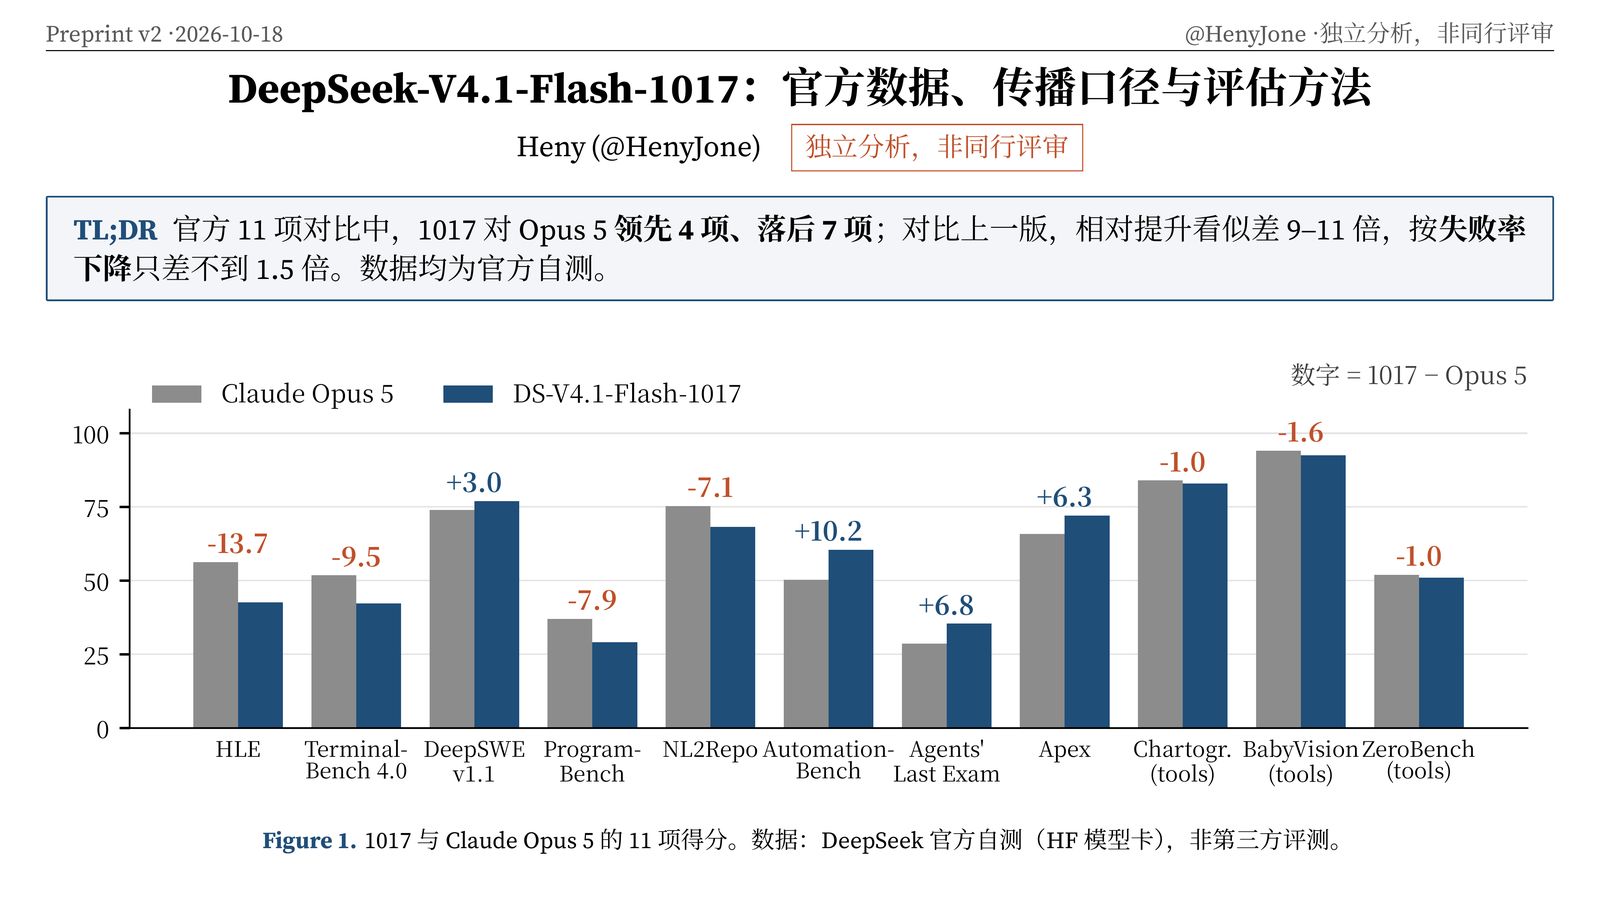
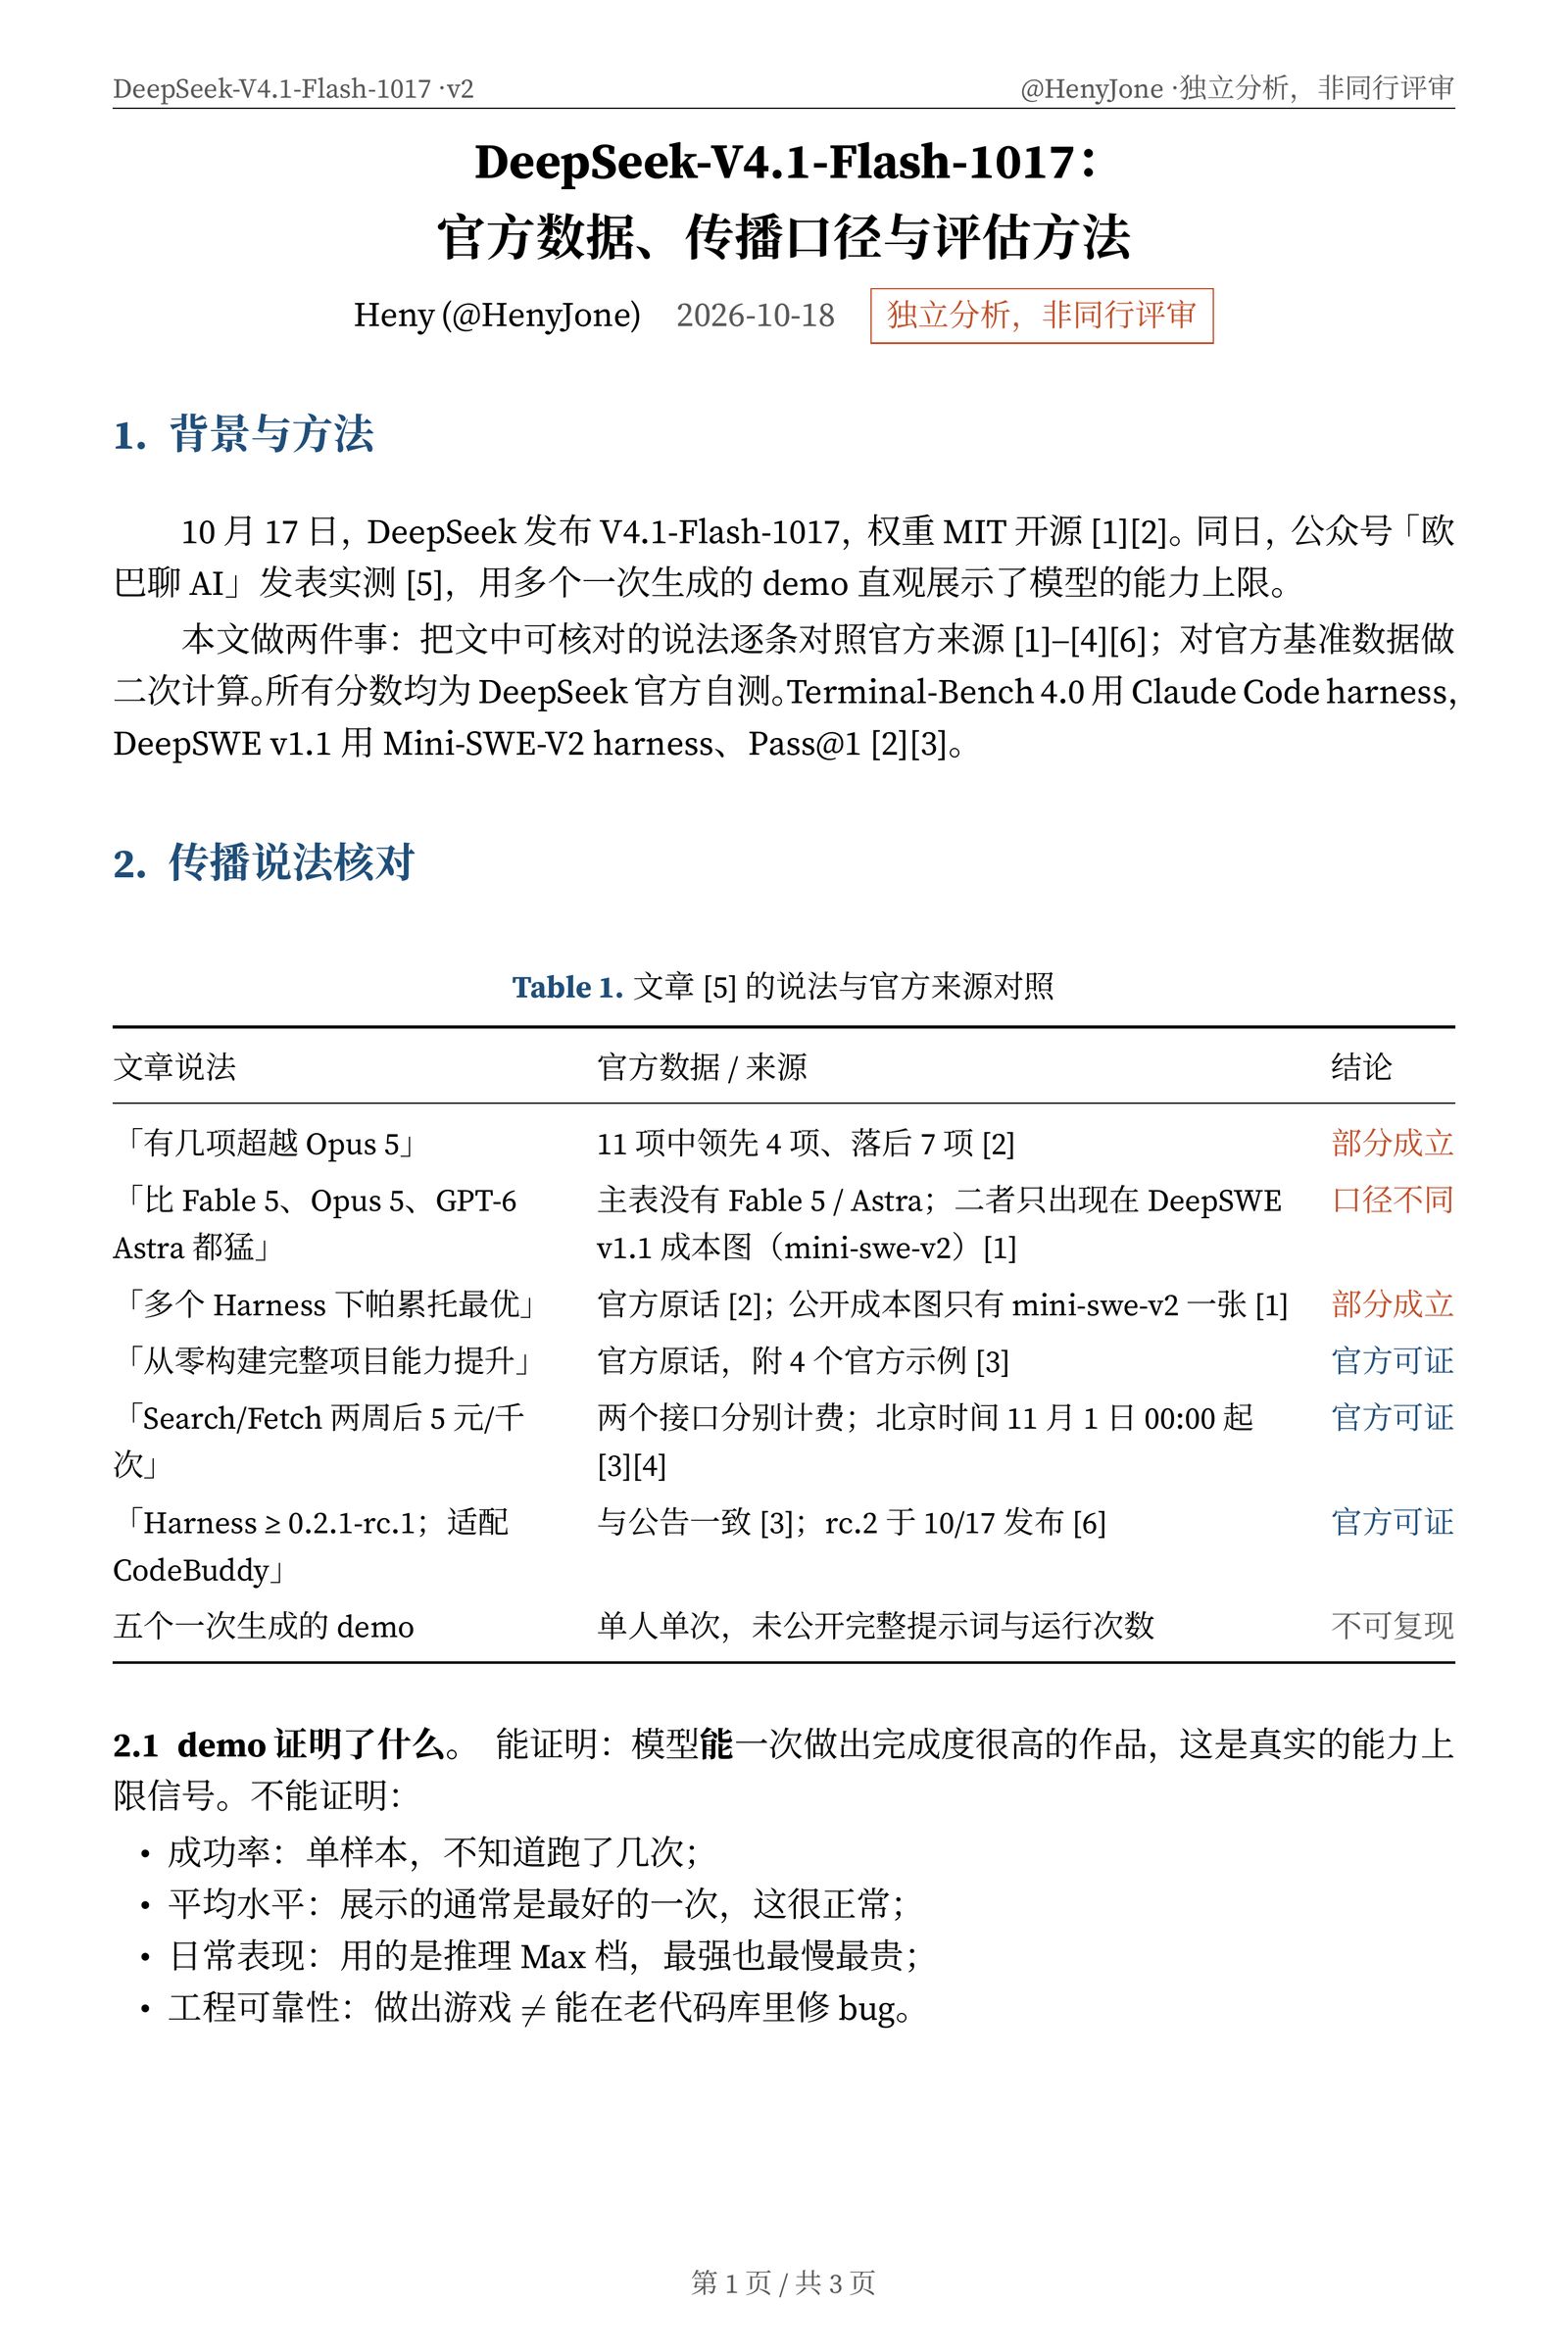
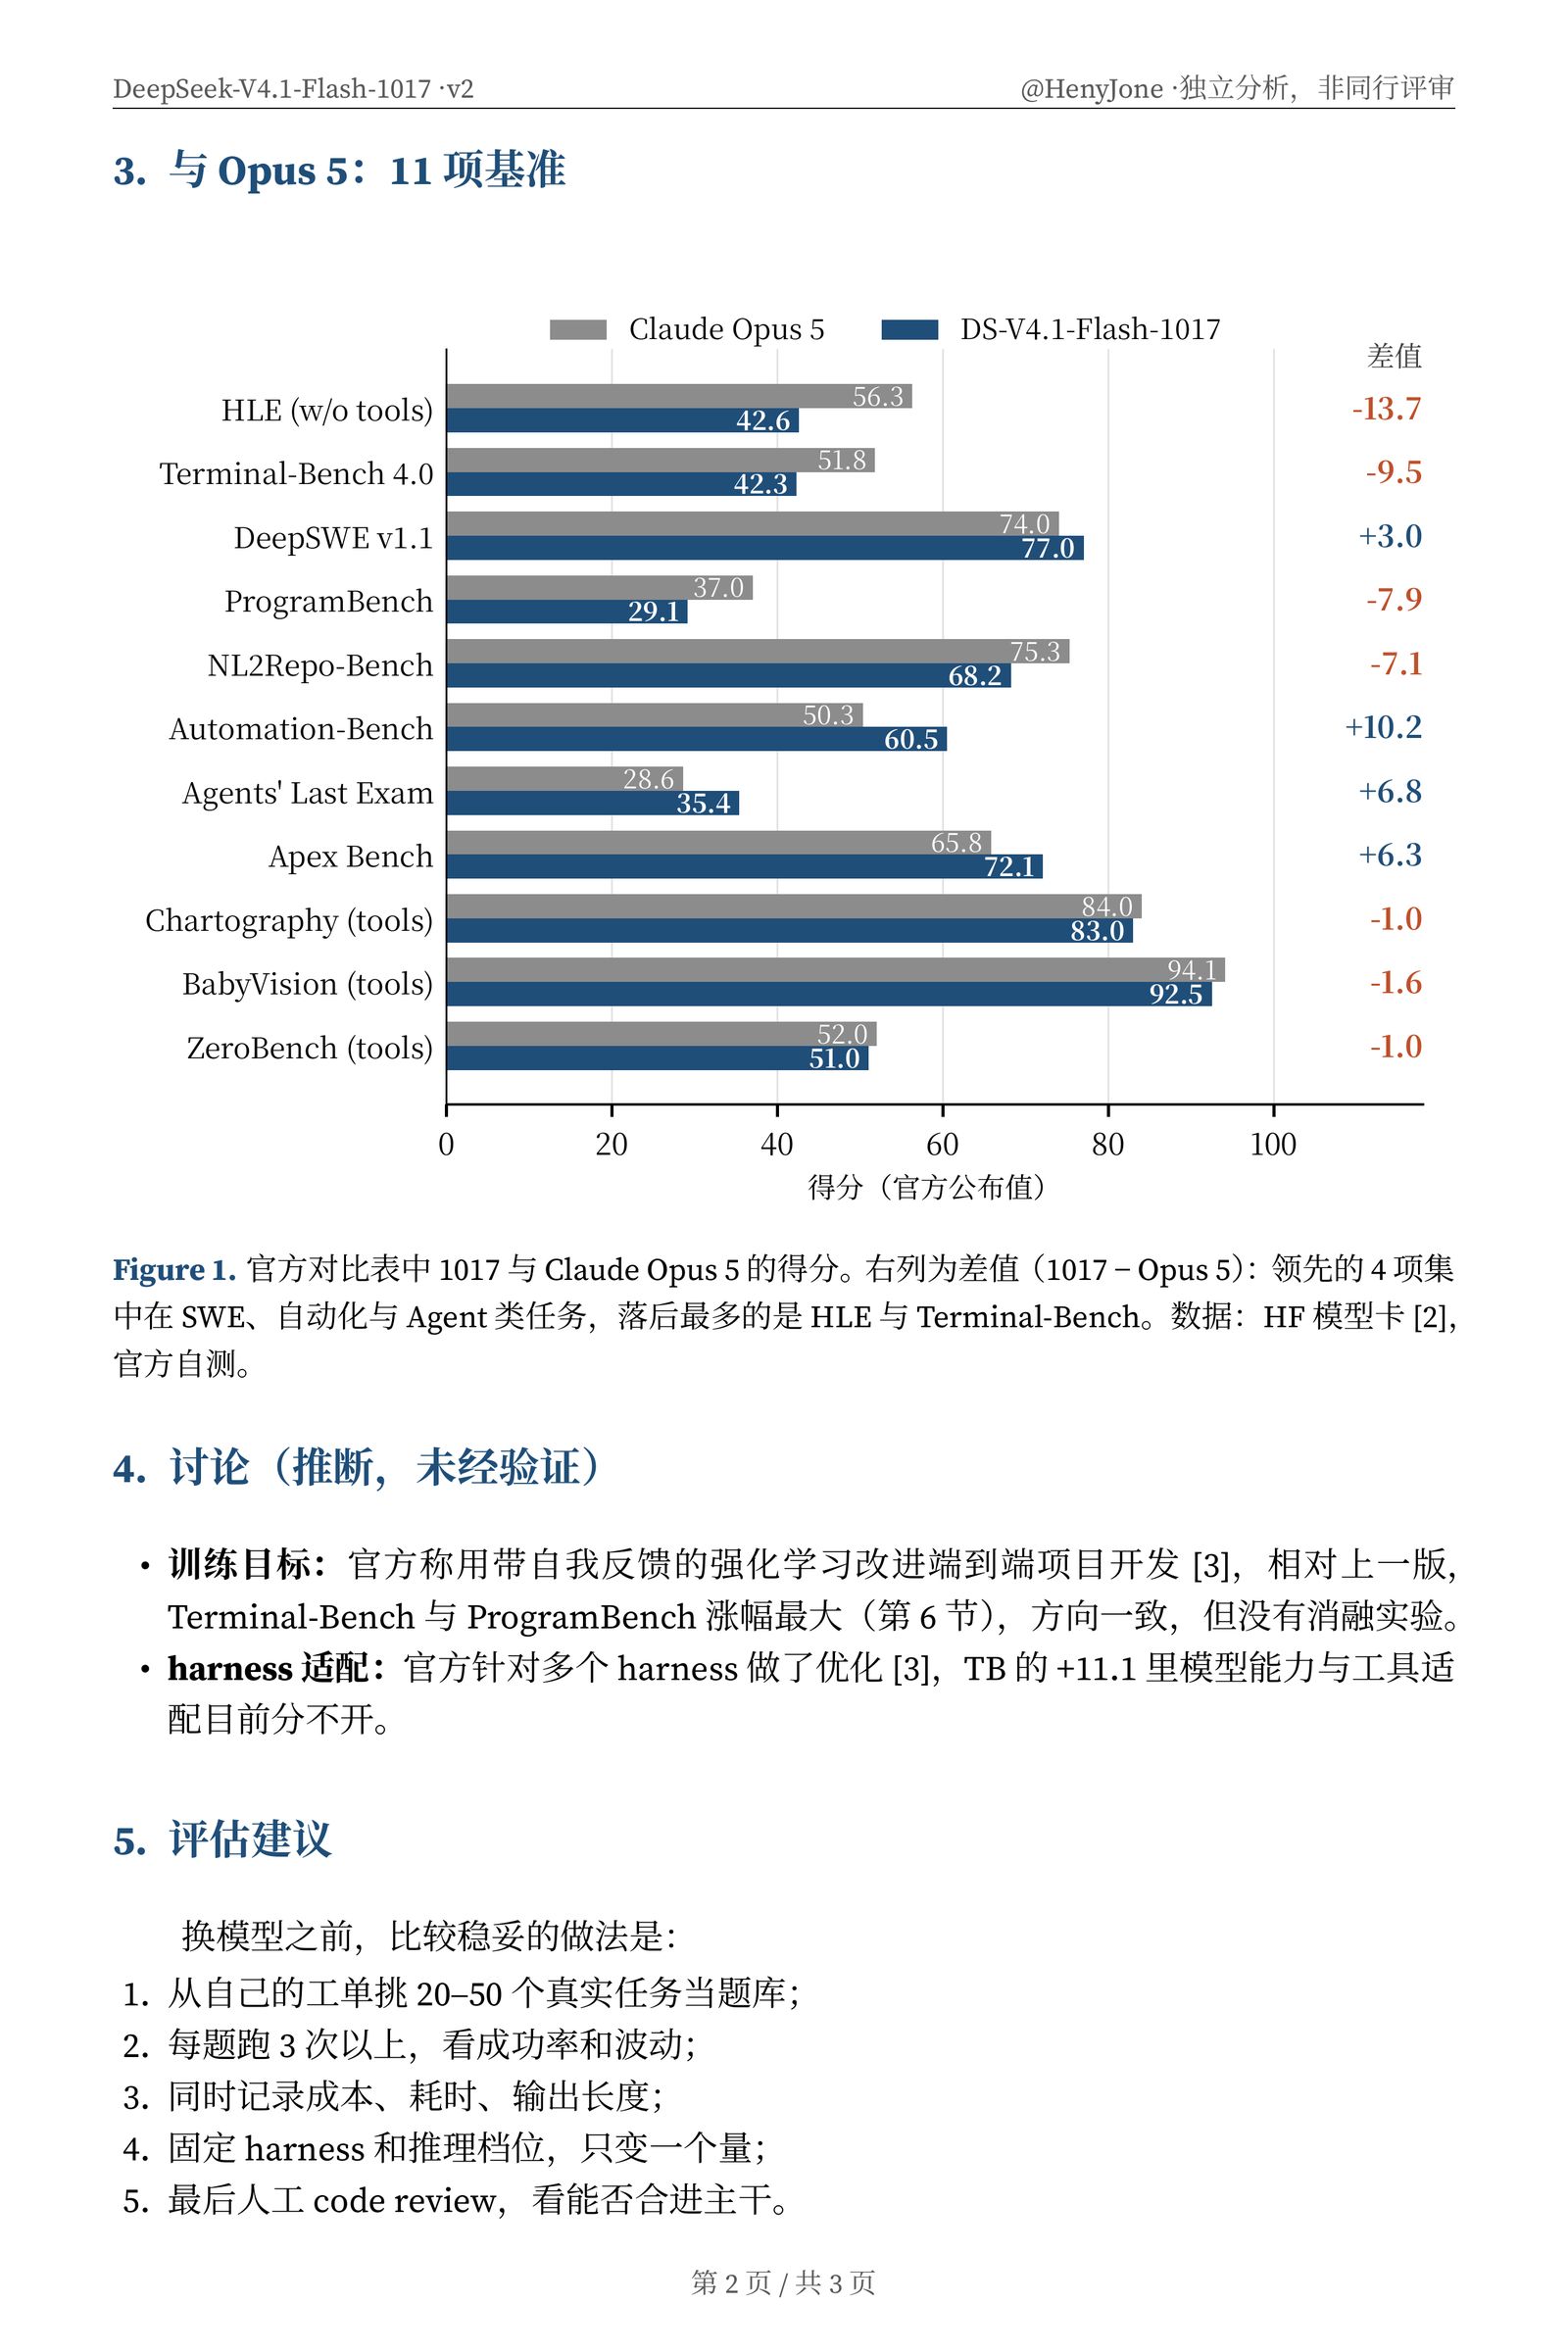
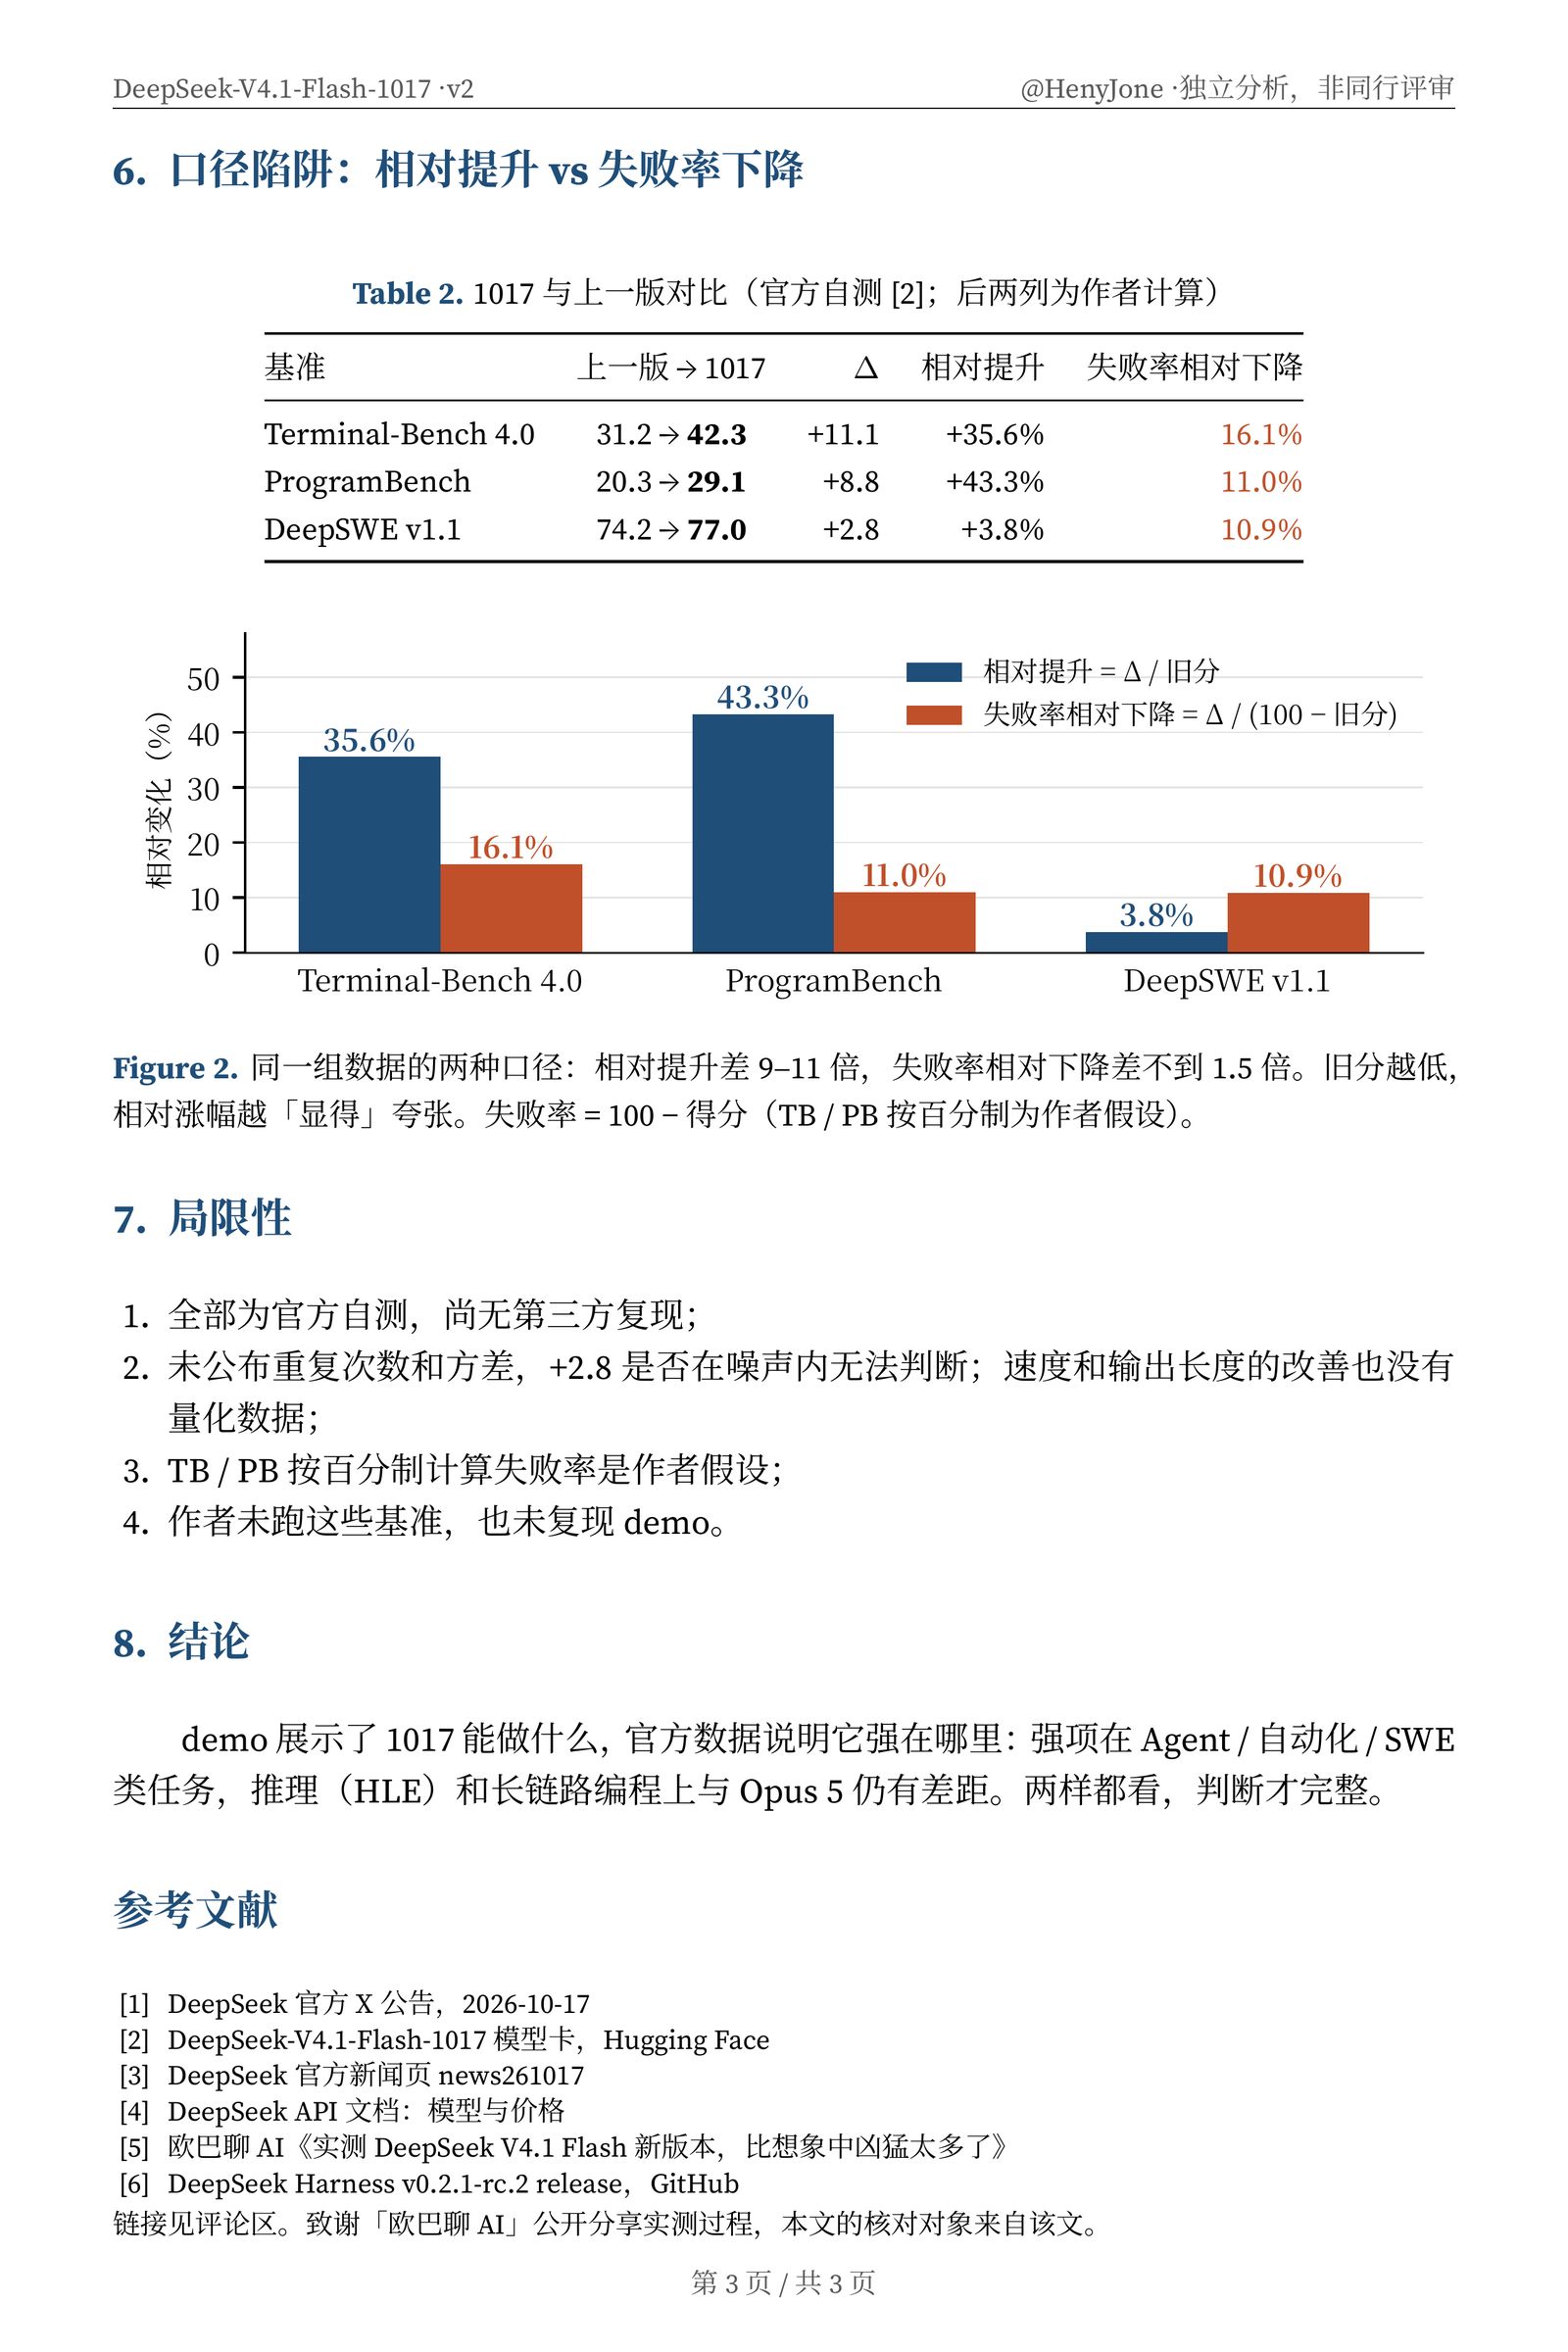
🚨 一篇公众号爆文说 DeepSeek 1017「比 Opus 5、Fable 5、GPT-6 Astra 都猛」。我把它的每一条说法和官方原始数据对了一遍。 结论:爆款实测告诉你它能做什么,数据告诉你它在哪里强。👇 TL;DR · 官方对比表 11 项基准里,1017 对 Opus 5 是 4 胜 7 负,不是「全面超越」 · Fable 5 和 GPT-6 Astra 不在官方主表里,只出现在 DeepSWE 一张成本图上 · Search/Fetch 收费、Harness 版本、CodeBuddy 适配这些说法,官方都能对上 · 对比上一版:看相对涨幅,三项差了 9 到 11 倍;换成失败率下降,差距不到 1.5 倍 · 数据全部是官方自测,没有第三方复现;我本人也没测 1. 背景 10 月 17 日 DeepSeek 发布 V4.1-Flash-1017。当天「欧巴聊AI」发了一篇实测,五个 demo 很有冲击力,值得一看。本文不评价 demo 好不好看,只回答一个问题:文章里的数字类说法,官方数据能不能撑住。 2. 官方数据 vs 传播口径(见配图 Table 1、Figure 1) ① 「有几项超越 Opus 5」⚠️ 部分成立 HF 模型卡对比表 11 项,1017 领先 4 项:DeepSWE 77.0 vs 74.0、Automation-Bench 60.5 vs 50.3、Agents' Last Exam 35.4 vs 28.6、Apex 72.1 vs 65.8。 落后 7 项:HLE 42.6 vs 56.3、Terminal-Bench 42.3 vs 51.8、ProgramBench 29.1 vs 37.0、NL2Repo 68.2 vs 75.3,视觉三项各差 1.0 到 1.6。「有几项」没说错,但另外 7 项也该一起看。 ② 「比 Fable 5、Opus 5、GPT-6 Astra 都猛」⚠️ 口径不同 主表里的对手是 Kimi K3、GLM-5.3、GPT-5.6 Sol、Opus 5,没有 Fable 5 和 GPT-6 Astra。这两个只出现在官方第二张图:DeepSWE v1.1 的「得分 vs 单任务成本」。图上 1017(max)77.0% 确实是最高点,成本也最低,但这只是一项基准、一个 harness。 ③ 「多个 Harness 下帕累托最优」⚠️ 部分成立 官方原话,但公开的成本图只有 mini-swe-v2 一张。 ④ 「从零构建完整项目能力提升」✅ 官方原话,附 4 个官方示例。 ⑤ 「Search/Fetch 两周后按 5 元/千次收费」✅ 两个接口分开计费,各自每千次成功请求 5 元;服务端工具调用北京时间 11 月 1 日 00:00 起收费。 ⑥ 「Harness ≥ 0.2.1-rc.1,适配 CodeBuddy / WorkBuddy」✅ 官方公告和 GitHub release 一致。 ⑦ 五个 demo:个人 demo,不做可复现评价 3. 顺带一个口径陷阱:相对提升 vs 失败率下降(见配图 Figure 2) 1017 对比上一版(官方自测): · Terminal-Bench:31.2 → 42.3,+11.1,相对 +35.6%,失败率相对降 16.1% · ProgramBench:20.3 → 29.1,+8.8,相对 +43.3%,失败率相对降 11.0% · DeepSWE:74.2 → 77.0,+2.8,相对 +3.8%,失败率相对降 10.9% 旧分越低,相对涨幅越「显得」夸张。两种口径放一起看才公平。 4. demo 证明了什么,没证明什么 能证明:这个模型「能」一次做出完成度很高的作品,这是真实的能力上限信号。 不能证明: · 单样本:不知道跑了几次、成功率多少 · 可能有挑选:发出来的通常是最好看的那一次,这很正常,但不等于平均水平 · 用的是推理 Max 档:效果最好,也最慢最贵 · 视觉惊艳 ≠ 工程可靠:能做出游戏,和能在你的老代码库里改 bug,是两种能力 5. 前硅谷工程师视角:团队该怎么评估一个新模型 比较稳妥的做法是: · 从自己的工单里挑 20 到 50 个真实任务当题库 · 每题跑 3 次以上,看成功率和波动,不看最好的那一次 · 同时记录成本、耗时和输出长度,1017 主打的「更快、更短」正好在这里验证 · 固定 harness 和推理档位,换模型时只变一个量 · 最后让人做 code review,看代码能不能合进主干 榜单决定要不要试,自己的题库决定要不要换。 6. 局限性 ① 所有跑分都是 DeepSeek 官方自测,没有第三方复现 ② 没公布重复次数和方差,+2.8 这种幅度是不是噪声无法判断 ③ ProgramBench、Terminal-Bench 按百分制算失败率是我的假设 ④ 我本人没有跑过这些基准,也没有复现文中的 demo 7. 结论 欧巴的文章展示了 1017 的上限,官方数据说明它的强项集中在 Agent / 自动化 / SWE 类任务,在推理(HLE)和长链路编程上和 Opus 5 还有距离。两样都看,判断才完整。 你看到一个新模型,会先看 demo 还是先看跑分? 完整论文见配图(封面 + 共 3 页)