Gemini 4 Argon hands-on: model catches the frontier, Antigravity lags behind
The author tests Argon across coding, writing, design and knowledge work, finding the model back at the frontier but not ahead of rivals, while its Antigravity app trails competitors by six months to a year.
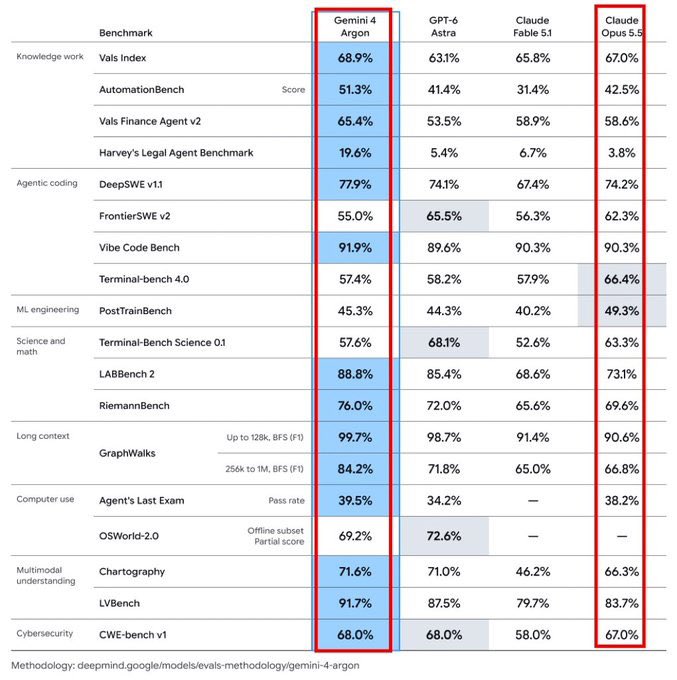
先说结论:Gemini 4 Argon 让 Google 的模型重新追上了第一梯队,但没有超越对手,而它的应用 Antigravity(Harness)还落后对手半年到一年,拖累了模型的表现!今天用日常任务简单测试了 Argon 的写作和知识内容组合能力,和 Dan Shipper 的这篇 Vibe Check 感知一致👀 帮大家总结下: 1. 编程:从零开始搭应用又快又好,低推理档就能达到 Opus 5.5 的水平;但审查自己的代码很敷衍,改造复杂的老代码库也很弱(Vibe Check 得分 21%,Claude 和 GPT-6 在 81% – 85% 的对比)需要配上严格的自动化测试,或者让另一个模型来审查; 2. 写作:让它一次写完整篇,文字太密、太难读(可读性约 10.6 年级,其他前沿模型在七到八年级);但当编辑伙伴来梳理结构、打磨比喻非常出色,Dan Shipper 现在最喜欢用它写作;我觉得 Opus 5 水平均衡,适合表达事实类写作,Gemini flash 文采很好但太飘,Argon 的问题就是啰嗦了; 3. 设计:排名第二,仅次于 Opus 5.5。默认风格太繁杂、堆砌功能,推理档位越高越乱;不过很好调教,给出明确的简报或设计稿就能交出干净的作品; 4. 知识工作:分析和提炼洞察的能力强,做数据仪表盘、写报告时优于 Fable 5.1;但一次处理很多文件时会丢掉细节,查事实时会很自信地答错(这个和代码需要复查逻辑一样) 对于整个公司都用 Google Workspace 的大量用户来说,Argon 是一次巨大的跃升,意味着他们第一次在工作中用上了前沿级别的模型。 对于能自由选择工具的进阶用户,Argon 适合在写作时当结构和思路上的搭档,或者用来快速做原型、出设计,但还不能当主力。 Google 已经补上了模型上的差距,接下来要把应用层也带进 2026 年。官方已经预告了自动安全分类器、云端执行和 max 推理档位,这些更新会决定 Argon 能不能从“回到第一梯队”变成真正可以作为主力的选择🤔