Comparing how Anthropic and OpenAI disclose their math results
The author compares Anthropic's Lean formalization of Fermat's Last Theorem with OpenAI's September and October math announcements, criticizing the latter for declining disclosure quality and vague time definitions.
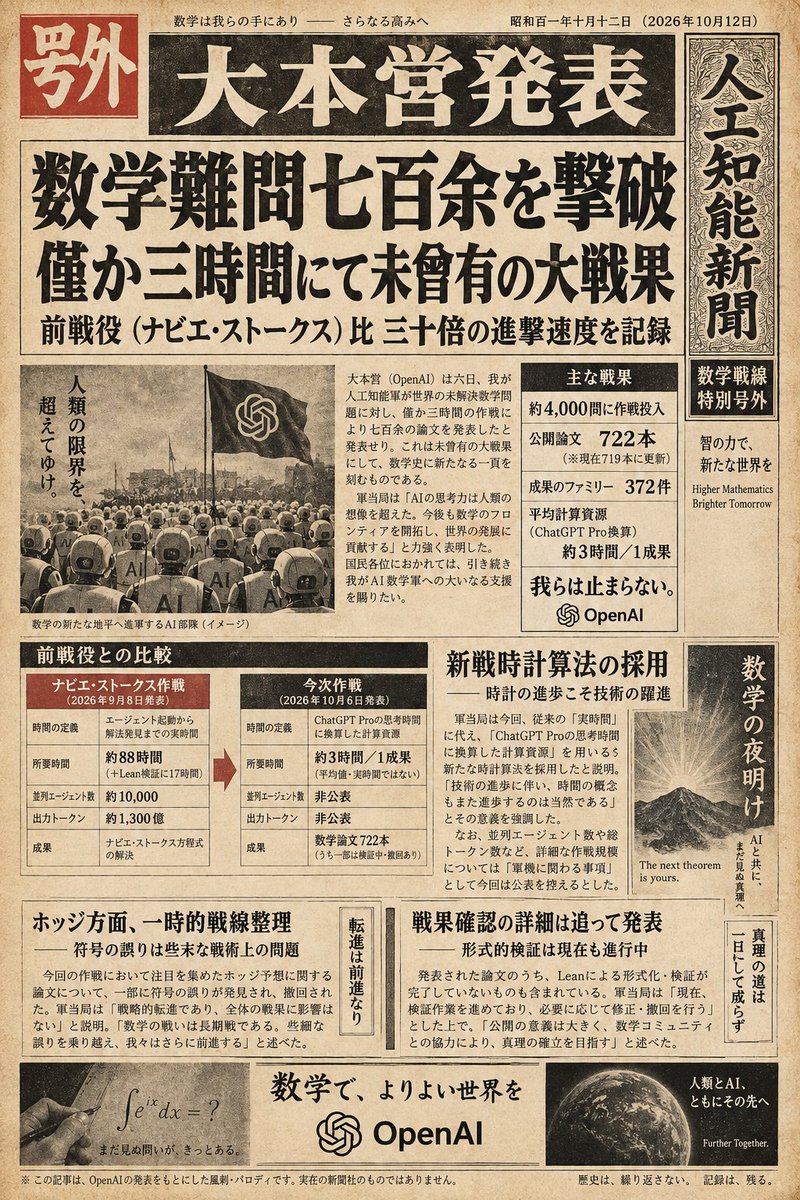
これを機に改めて9月4日のAnthoropicの「フェルマーの最終定理のLeanによる形式化」の内容を改めて読んでみたが、学術的な誠実さを感じる内容で非常に印象が良い。https://www.anthropic.com/news/formalizing-fermats-last-theorem この中では9月8日のOpenAIの発表の様式と同様に ・所要時間は現実世界で11日間 ・時間の定義はプロジェクトの経過時間 ・エージェントは数十体 ・出力トークンは約60億トークン ・人間の関与は時折の数学的指示 と前提条件をしっかりと明記した発表になっている。 特にプロジェクトの試行錯誤や最後の人間の関わり方などについて明記している点が好印象で ・初期の試行ではエージェントが全体像を把握できなくなり失敗を繰り返した。その部分のコードはこの成果物のうち7%を占めている ・(おそらく数学者の)Tianyi Peng研究員が時々エージェントに対して研究方針の方向性を促す指示を与えた などの記述があることから、ある意味超人的なAIの数学能力を前提にしても、やはり「一定の数学的素養のある人間の補助」なしにはなかなか「完全自走」は難しいといった現状についても赤裸々に記述していると言える。 なお、9月8日のOpenAIの発表もこの時点ではある程度「実際の試行錯誤」を赤裸々に記述しており https://openai.com/ja-JP/index/navier-stokes-solution/ ・8/28 新しい内部モデルの訓練を開始 ・9/1 ミレニアム問題が2問解決されたという噂を聞き、すべてのミレニアム問題への探索を開始 ・9/1-5 約100体のエージェントを用いてEuler方程式に関する成果を得る。それを研究チームが把握し、ナビエストークスが有望と判断し他のミレニアム問題からナビエストークスにエージェントを集中 ・9/5 更に訓練が進んだ社内モデルが利用可能になりモデルを更新。最初のエージェント起動から約88時間後に証明に至る ・9/5-6 GPT-6 Astraを用いて追加17時間でLeanによる形式化を完成 という流れだった。これらも勿論「人類史に残る驚異の結果」ではあるものの、思考プロセスやエージェントが得た結果を活かす方向づけにおけるOpenAI内部の数学者の役割も不可欠なように見え、ある意味で「人間とAIの共同作業」を感じさせる内容であった。 そして、この時点で未解決問題の発表における様式としてこういった「試行錯誤のプロセス」「使用トークン数」「人間の関与度合い」などを記述するコンセンサスへの期待が形成されつつあったと言えるだろう。 にもかかわらず、10月6日の発表からOpenAIの開示情報のクオリティは千賀のお化けフォーク並の落差を示し ・公開したのは700本超の数学の証明だけで、それぞれの試行錯誤のプロセスはほぼ非開示(372系列のうち10系列のみ要約がある) ・なぜかLean化されていない証明も含まれており、既に一部は早期にミスが発見され撤回 ・投入したエージェント数/トークン数/実世界での時間数などすべて非開示 ・定義が不明瞭な新たな「時間概念」を主張し、1問あたりの解いた時間が3時間という数値を強調 などという中の人でも変わったのかと思わせるようなものに変化している。最初の方は「700本超の証明(これは確かに凄い)」や「1問あたり3時間(これは定義が怪しいと人々も気づき始めた)」といったパワーワードによってただただ衝撃を受けていた人々も、ようやく不自然な発表様式の変化に気づき始めて「大本営発表っぷり」を感じ始めているのが現状ではなかろうか。 そもそも、9月1日の時点で「すべての」ミレニアム問題に取り組んでいると自ら述べているわけで、10月に取り組ませた4000問の中にその中に繋がっていたものがないわけがなかろう。 普通に考えればそれらの問題は「現実時間で1ヶ月以上取り組んでいるが解けていない」という状態になるが、一方でここで「平均3時間(定義不詳)で解けた未解決問題の証明が700問も出てくる」というのはなかなかピンとこない説明だ。 実際にはこれらの問題を解くために既に何か月も内部モデルを繰り返し動かし試行錯誤しているが、その時間が経過しすぎて素人目にインパクトのある内容ではなくなってしまったが故に、時間の定義を変更し、このような著しい情報開示の劣化を起こしたのではないか。 そう解釈すれば「平均3時間(定義不詳)で700問超の未解決問題を解けるはずの物凄いAIが、その発表から1週間の間にその勢いを殆ど感じさせない程度のアップデートしかできていない不思議」にも納得がいってしまう。 ただまあ、これらは全部不思議な現状から推測に推測を重ねただけの話に過ぎないし、世界を代表するスーパーAI企業のOpenAI様がIPO前なのになかなか売上も思うように上がってないからといってそんなシャバい話の盛り方をしだすとはとても考えづらいため🤪 単純に忙しくて手が回ってへんかっただけじゃボケェ‼️😄👊くらいの勢いで、従来の基準で今回のそれぞれの証明に対するしっかりとした情報開示をやってくれると期待してます😄✋
This post quotes another post: x.com/infinity_topoi/status/2109506336035942541