jevIMAGE
LangChain tests Jev as an agent-eval judge against GPT-5.6 and Claude Sonnet 4.6
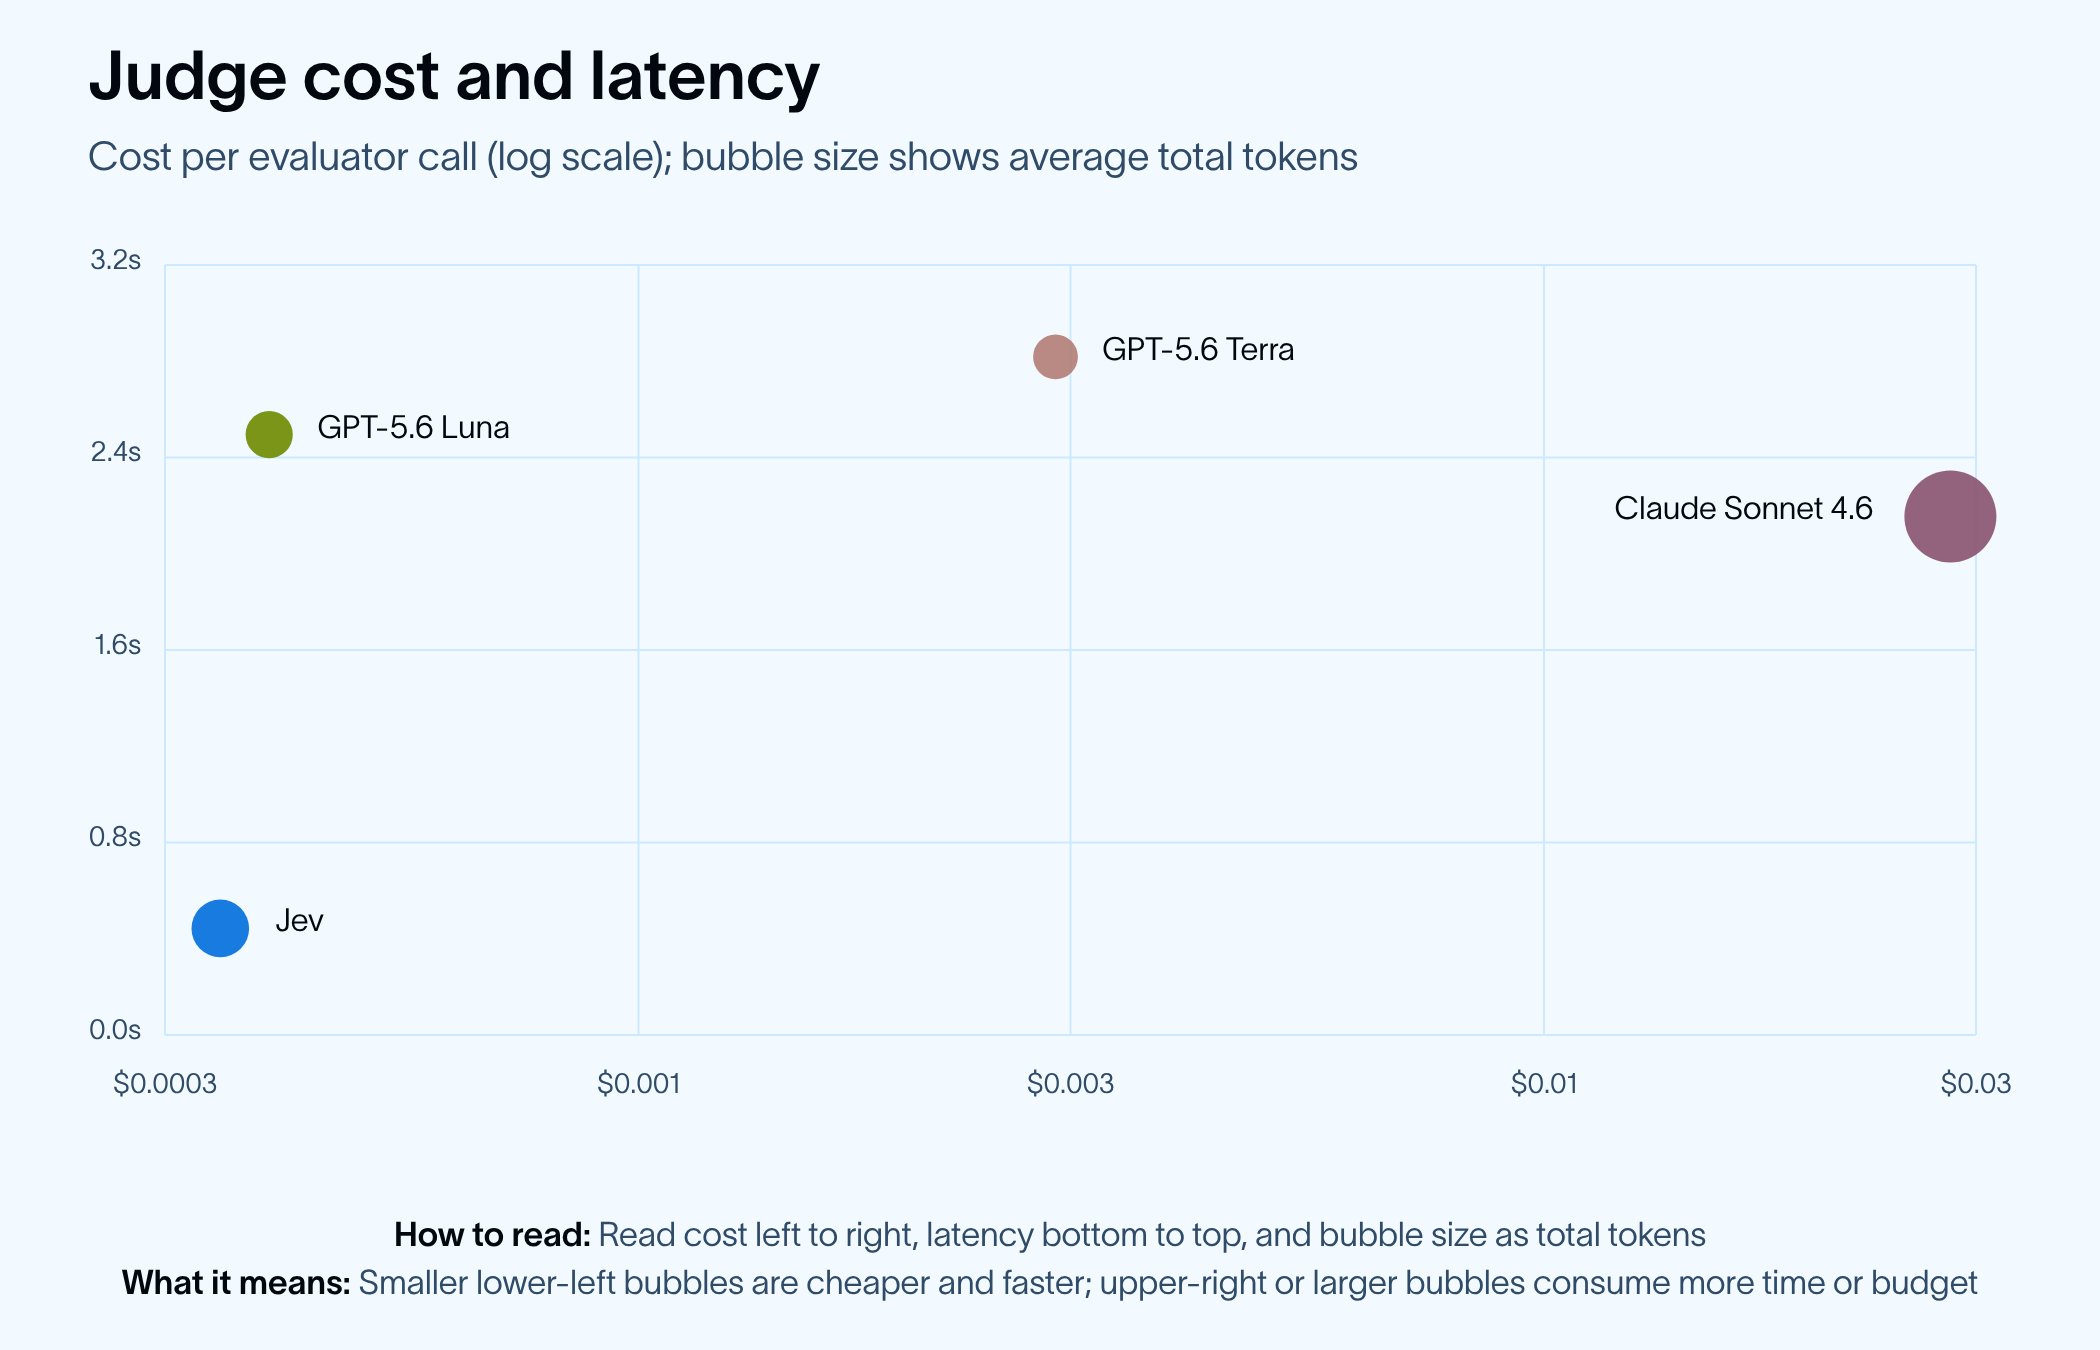
LangChain compared Jev with GPT-5.6 and Claude Sonnet 4.6 as agent-eval judges: Jev matched the human reviewer on every call, with up to 913x lower variance and 0.44s per call, for a full-run cost of $0.34.
LangChain
@LangChainArchived 2026.09.22Originally posted 2026.09.22
LangChain @LangChainOriginally posted 2026.09.22
We tested Jev against GPT-5.6 Luna, GPT-5.6 Terra, and Claude Sonnet 4.6 as agent-eval judges. ✅ Jev matched a human reviewer on every call, with up to 913x lower variance, at 0.44s per call vs 2.16-2.83s for the LLMs. ✅ Cost for the full run: $0.34 with Jev. $28.17 with Claude Sonnet 4.6.
x.com/langchain/status/2102081157332353131Archived 2026.09.22 10:18