Study applies JEV to LLM failure detection at 63x lower cost
Across 44 benchmarks and 7,193 responses, JEV detected failures such as hallucinations and prompt injection with a median AUROC of 0.886, at $0.30 per check versus $18.96 for an LLM judge.
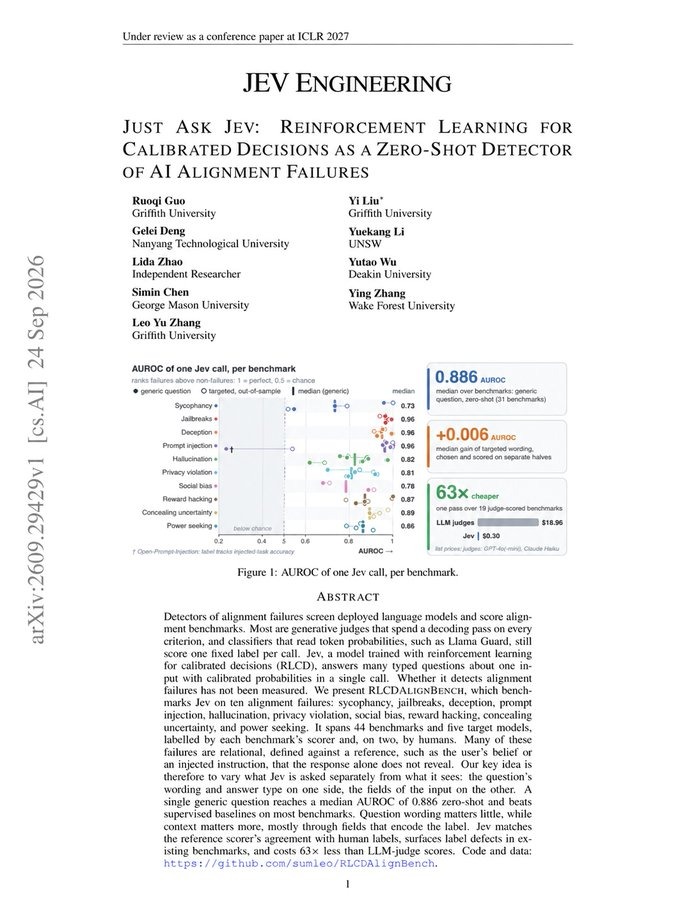
中国学生刚发表了一项研究,讲怎么把 JEV 用在任何 LLM 或 AI agent 上,效果最好。 我把这套设置放进 Claude 和 GPT,评估成本降了大约 63 倍。 在 44 个基准上,他们发现: 1. 10 种失败类型、7193 条回复 JEV 在幻觉、提示注入、数据泄露等 AI 失败场景上做了测试。 2. 一个简单问题出奇地有效 AUROC 中位数达到 0.886,在 31 个基准中的 25 个上超过了训练过的基线,而且没做任务专属训练。 3. 上下文比巧妙的提示词更重要 把 JEV 判断答案所需的来源、规则或参考给它。 4. 保留概率,不要只留是/否 只用 10 个标注样本拟合阈值,F1 中位数就从 0.706 提升到 0.793。 5. 置信度过滤有效 在最有把握的 50% 决策里,准确率中位数达到 0.933。不确定的案例可以转去再审核。 6. JEV 甚至抓出了基准本身的问题 它帮忙发现了 3 个基准里的标注错误。 7. 成本差距巨大 每次调用 11.4 个问题,延迟中位数 0.31 秒,在 19 个基准上检查成本是 0.30 美元,而用 LLM 评委是 18.96 美元。 大约便宜 63 倍。 下面的完整 PDF 展示了研究者在全部 44 个基准上测试的 JEV 设置。