deepseek-v4.1IMAGE
DeepSeek V4.1 Flash on one 48GB RTX 4090: Project Maya hits 65–72 tok/s
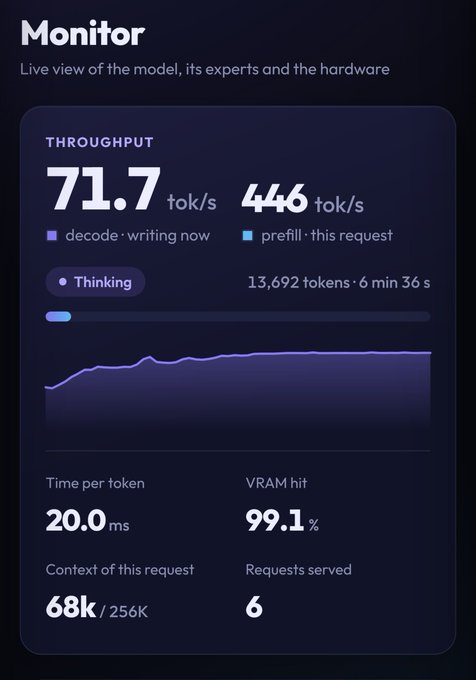
Maya-XS compresses the 748B model to about 120.6GB with ~1.6-bit quantization and tiers experts across VRAM, RAM and SSD, lifting speed from 17 to 65 tok/s, with three V100s reaching 71.7 tok/s at 68K context.
大數軟體LargitData
@LargitData1Archived 8 days agoOriginally posted 2026.10.23
大數軟體LargitData @LargitData1Originally posted 2026.10.23
用魔改版的單張 RTX 4090,就能以 70 tokens/s 的速度跑最新的 DeepSeek-V4.1-Flash-1017?! 開源專案 Project Maya 針對 MoE 架構設計動態 Expert Caching,將高頻使用的專家保留在 GPU VRAM,其餘分層存放於系統 RAM 與 NVMe SSD,依照推論需求動態載入,不必將完整模型塞進 VRAM。 新版 Maya-XS 更透過約 1.6-bit 極低位元量化,將 DeepSeek-V4.1-Flash-1017(748B) 的主要模型權重壓縮至約 120.6GB,搭配 DSpark 推測解碼、Tensor Parallel 與自動硬體校準,進一步提升推論效率。 實測驚人,有使用者用一張 48GB 的魔改 4090,搭配原版 Maya-XS 引擎,將 DeepSeek 生成速度從 17 提升至 65 tokens/s,最高值達 72.4 tokens/s! 另有實測用三張 Tesla V100 32GB 也能在 68K 的 Context 下達到 71.7 tokens/s 的驚人速度。
x.com/largitdata1/status/2113635915713396809Archived 2026.10.24 12:08