Explaining V4.1-Flash-1017's self-feedback RL and KV cache compression
A breakdown of the release: self-feedback RL lets the model debug and fix its own bugs with fewer interaction rounds, while KV cache compressed to 890 bytes per token cuts prefill compute nearly in half, making 1M context cheaper.
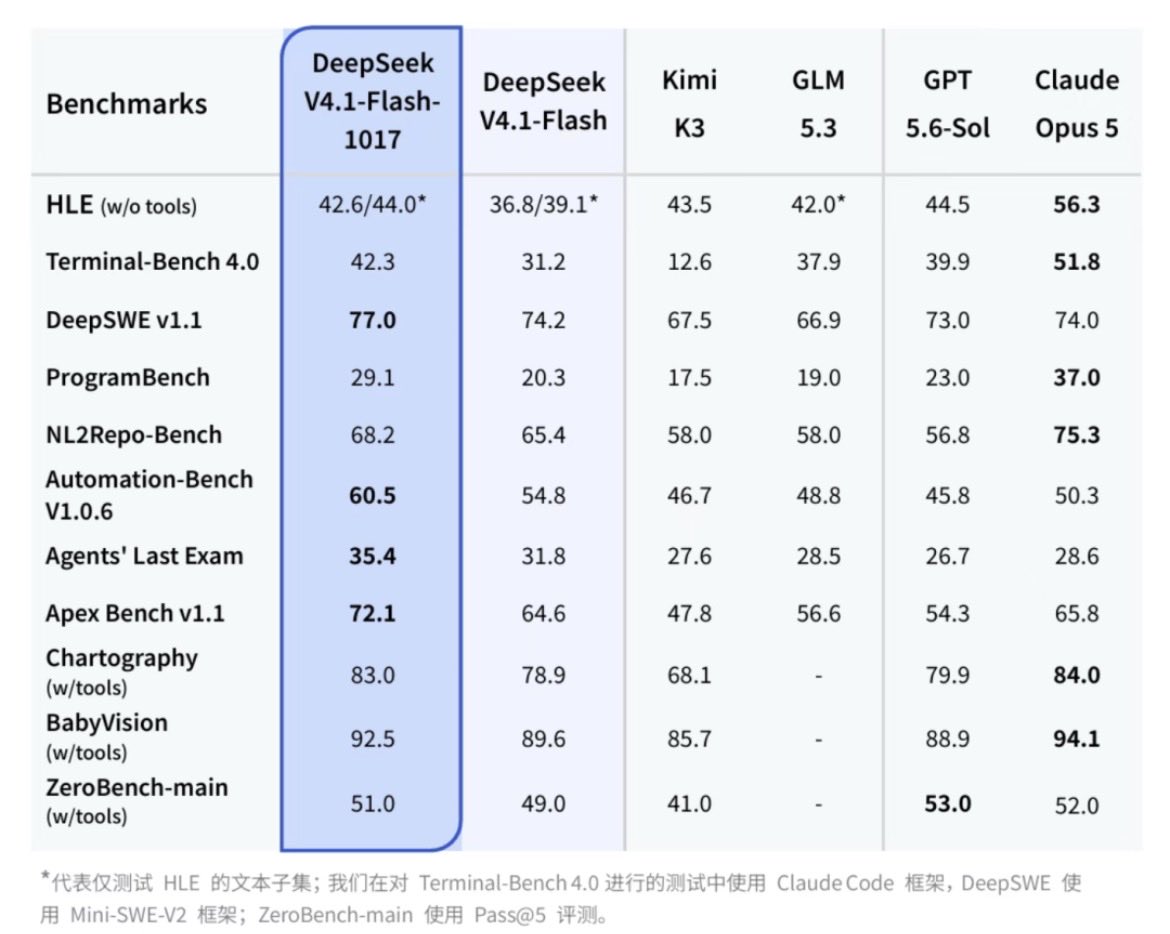
国产大模型DeepSeek率先炸场🚀🚀🚀 DeepSeek 这波又是熟悉的突袭风格,不声不响直接把 V4.1-Flash-1017 推上了线。 Web 端和 App 悄悄全切了,API 接口名字都没改,大家在用的 deepseek-v4-flash 直接无痛升级。 这次有两件特别实在的事。 1、从“人肉监工”到“许愿式交付” 以前让模型写个稍微复杂点的全栈小项目,或者搓个带交互的 3D 小游戏,过程有多折磨做过的都懂。 你提个需求,它写崩一段;你把报错粘回去,它修了前头坏了后头。 一整个下午,你不是在写代码,而是在给 AI 当全职报错搬运工。 这次他们给模型上了基于自反馈的强化学习(Self-Feedback RL)。 翻译成大白话就是:它在后台学会了自己跟自己互搏、自己跑调试、自己修 Bug。 你给一句极简的需求提示词,在官方沙箱里跑,交互轮次肉眼可见地降了下来。 它不再需要你寸步不离地在边上当监工了。 那种给个想法就能直接端出一个完整可运行工程的感觉,手感确实顺滑了太多。 2、把多轮 Agent 的显存账单砍到了脚脖子 官方公告里写了一堆生僻词,什么因果编码器-解码器(CED)、压缩稀疏注意力(CSA2)。 其实就是死磕一个致命痛点:多轮长上下文的开销。 做智能体或者长文档分析的朋友都知道,Token 跑多了,显存账单能把人看哭。 以前多轮调用就像出差搬家,每走一轮都得把全部家当打包雇个大卡车拉着;而这次他们把每个 Token 的 KV 缓存硬生生压缩到了 890 字节。 这就相当于原本一卡车的东西,现在被他收拾得干干净净,直接塞进了一个随身登机箱。 预填充算力省了将近一半,多轮 Agent 跑起来轻快得多,百万上下文(1M)这下才算真正能便宜、稳定地跑进业务里。 说实话,每次看他们悄悄发版都有个很深的感触: 大模型卷到现在这个阶段,早就不单单是比谁在测试集上刷高了 0.5 分,而是看谁能把真实开发环境里的那堆脏活、累活、显存瓶颈给彻底抹平。 权重已经在老地方开源了,配套的沙箱 Harness 工具也上了。 还没上手的朋友直接去网页端或者调 API 跑一跑你的日常任务,最明显的感受就是:少了很多来回扯皮的废话,手感变得格外利索。 技术跑得太快,咱们边用边看,好玩的还在后头。
This post quotes another post: x.com/deepseek_ai/status/2111375640717033777