gpt-6IMAGE
Astra and Opus 5.5 differ by 5 benchmark points but feel 20 apart, user says
A Korean user notes Artificial Analysis scores of 58 for Opus 5.5 and 53 for GPT-6 Astra, but says real-world use feels like a 20+ point gap, questioning aggregate benchmarks.
루샨 lucian
@lucian__03Archived 13 days agoOriginally posted 2026.10.16
루샨 lucian @lucian__03Originally posted 2026.10.16
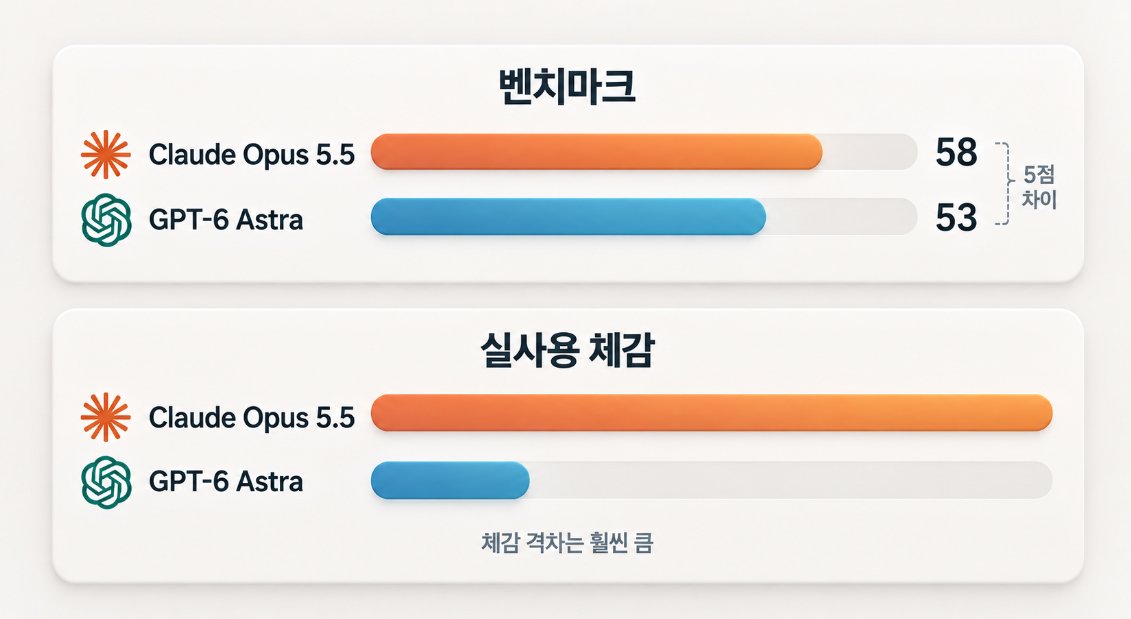
진짜 이제 LLM 벤치마크.. --> 그냥 99% 의미가 없는 것 같습니다. LLM 종합 벤치마크 기준으로 클로드 Opus 5.5: 58점 GPT-6 Astra: 53점 📌 고작 5점 차이입니다. (Artificial Analysis 기준) 근데 실제로 써보면... 진짜 이게 5점 차이인게 진짜 믿겨지지 않습니다. 요즘 저는 하루에 아스트라를 한 3시간, 클로드Opus 5.5를 대략 4시간 정도 쓰고 있는데요. 두 모델의 체감 성능 차이가 정말 너무 큽니다... 제 기준으로는 과장 조금 보태서 20점 이상 차이가 나는 것 같아요. 물론 벤치마크가 모델의 모든 성능을 평가할 수는 없겠지만, 이렇게 실제 사용 경험과 점수가 크게 다르면 종합 점수에 얼마나 의미를 둬야 할지 모르겠습니다.
x.com/lucian__03/status/2110943314258403721Archived 2026.10.18 16:01