deepseek-v4.1IMAGE
Report: DeepSeek V4.1 Flash hits 97.3% cache rate, cutting real cost to ~6.2% of list price
A report finds DeepSeek V4.1 Flash reaches a 97.3% cache hit rate, bringing real cost to about 6.2% of list price, making it a common pick paired with GLM 5.3 Flash for coding agents.
铁锤人
@lxfaterArchived 12 days agoOriginally posted 2026.10.19
铁锤人 @lxfaterOriginally posted 2026.10.19
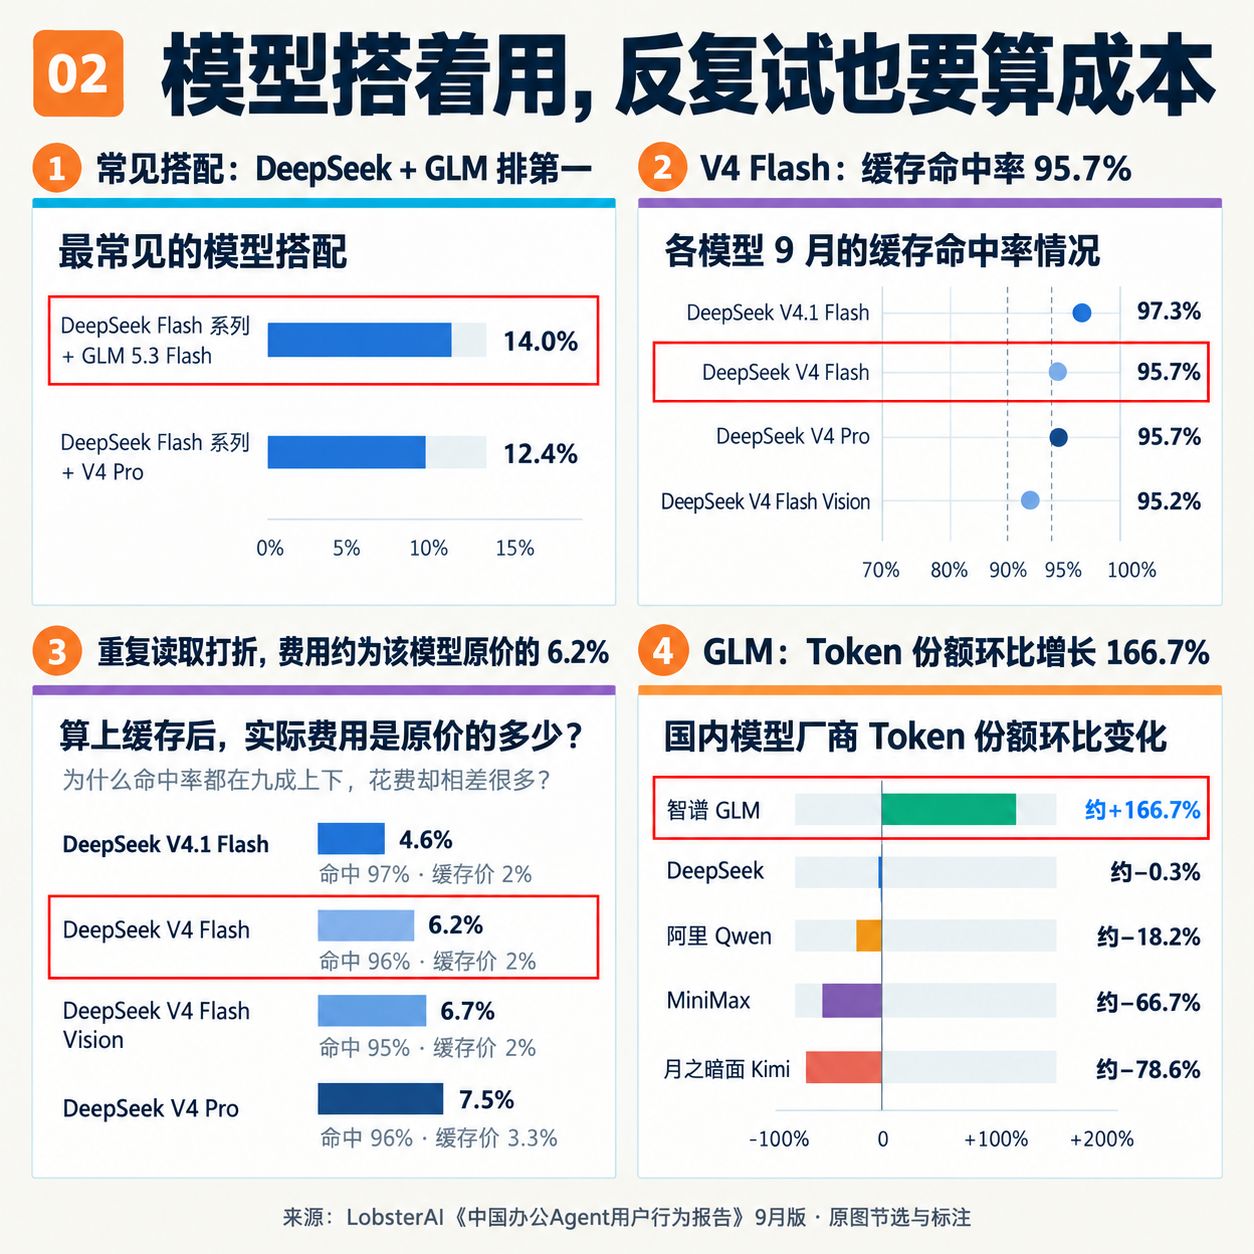
报告列出的常见模型组合里,排在第一的是 DeepSeek Flash 系列搭配 GLM 5.3 Flash DeepSeek 有个很实在的优势,缓存便宜 Agent 做任务,经常要反复读取之前的要求和输入 缓存就相当于把读过的内容记下来,下次再读,给你打折 报告里,DeepSeek V4.1 Flash 的缓存命中率达到 97.3% 算上缓存后,实际费用约为该模型原价的 6.2% 写代码要反复沟通、修改、调试,这个就很省了 但为什么GLM 的使用份额也在涨? 9 月,它在 LobsterAI 平台上的国产模型 Token 份额,环比增长约 166.7% 原来是因为他们做了一波“牛来”模型的营销!! 在这里我们看到一个大趋势👇
x.com/lxfater/status/2112000880878801396Archived 2026.10.19 12:02