DeepSeek V4.1 Flash: official benchmark table and API pricing breakdown
Korean analysis of DeepSeek's own comparison table: 77.0 on DeepSWE vs Opus 5's 74.0, but 42.6 on HLE vs 56.3; API at $0.15/$0.60 per million tokens, roughly 1/16–1/32 of GPT-5.6 Sol.
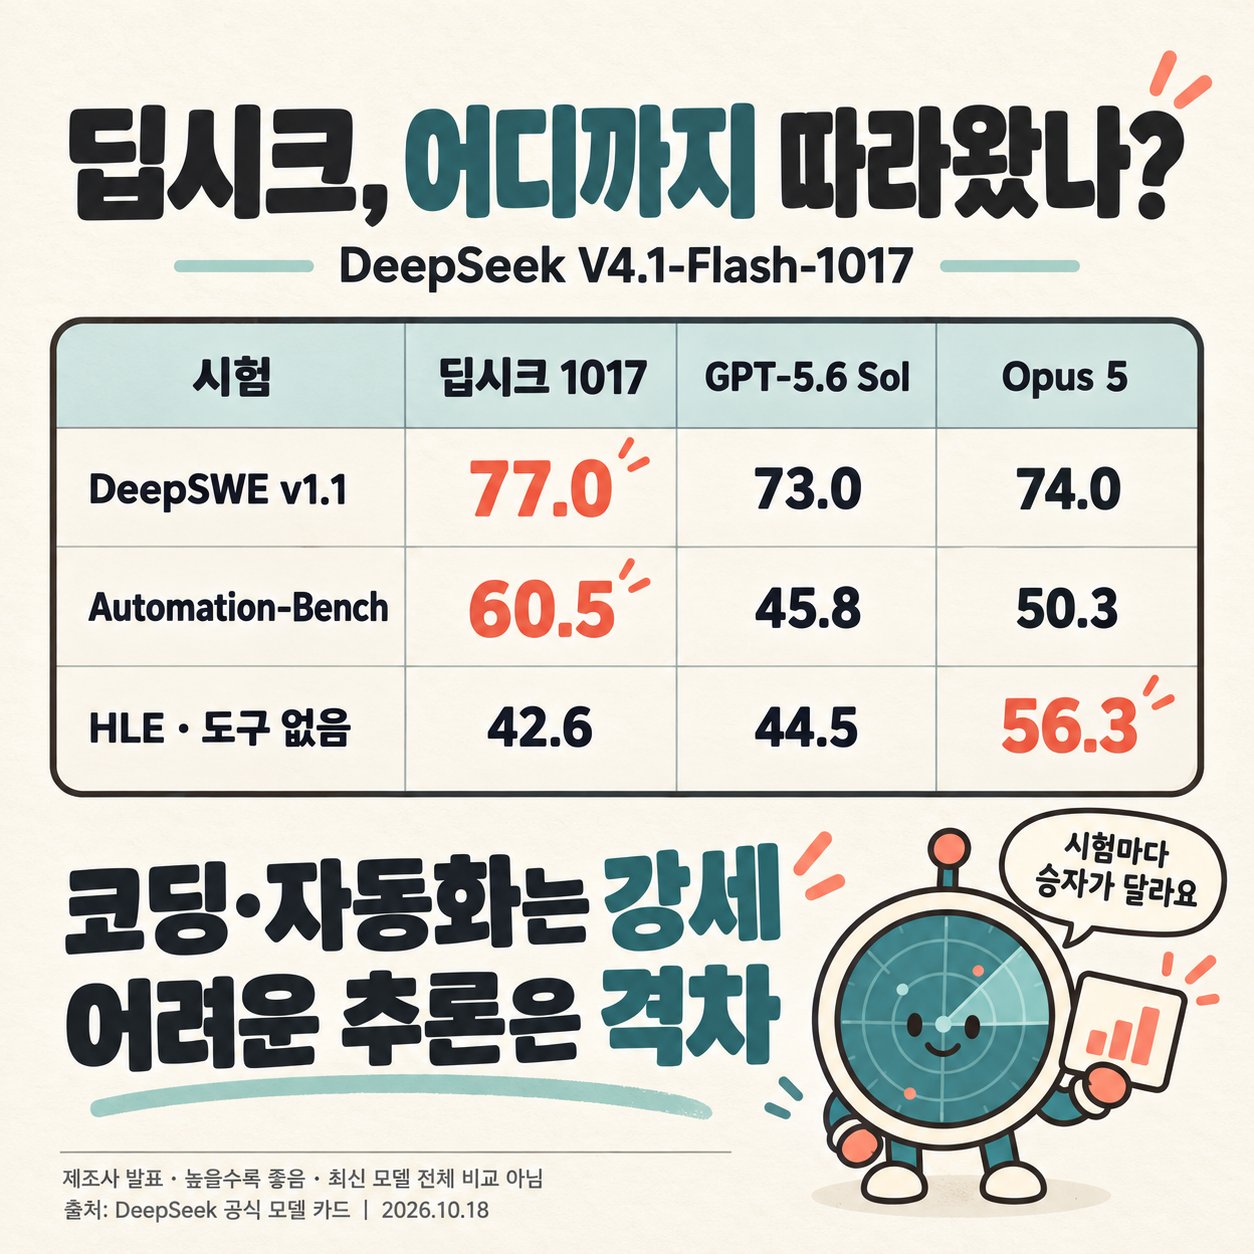
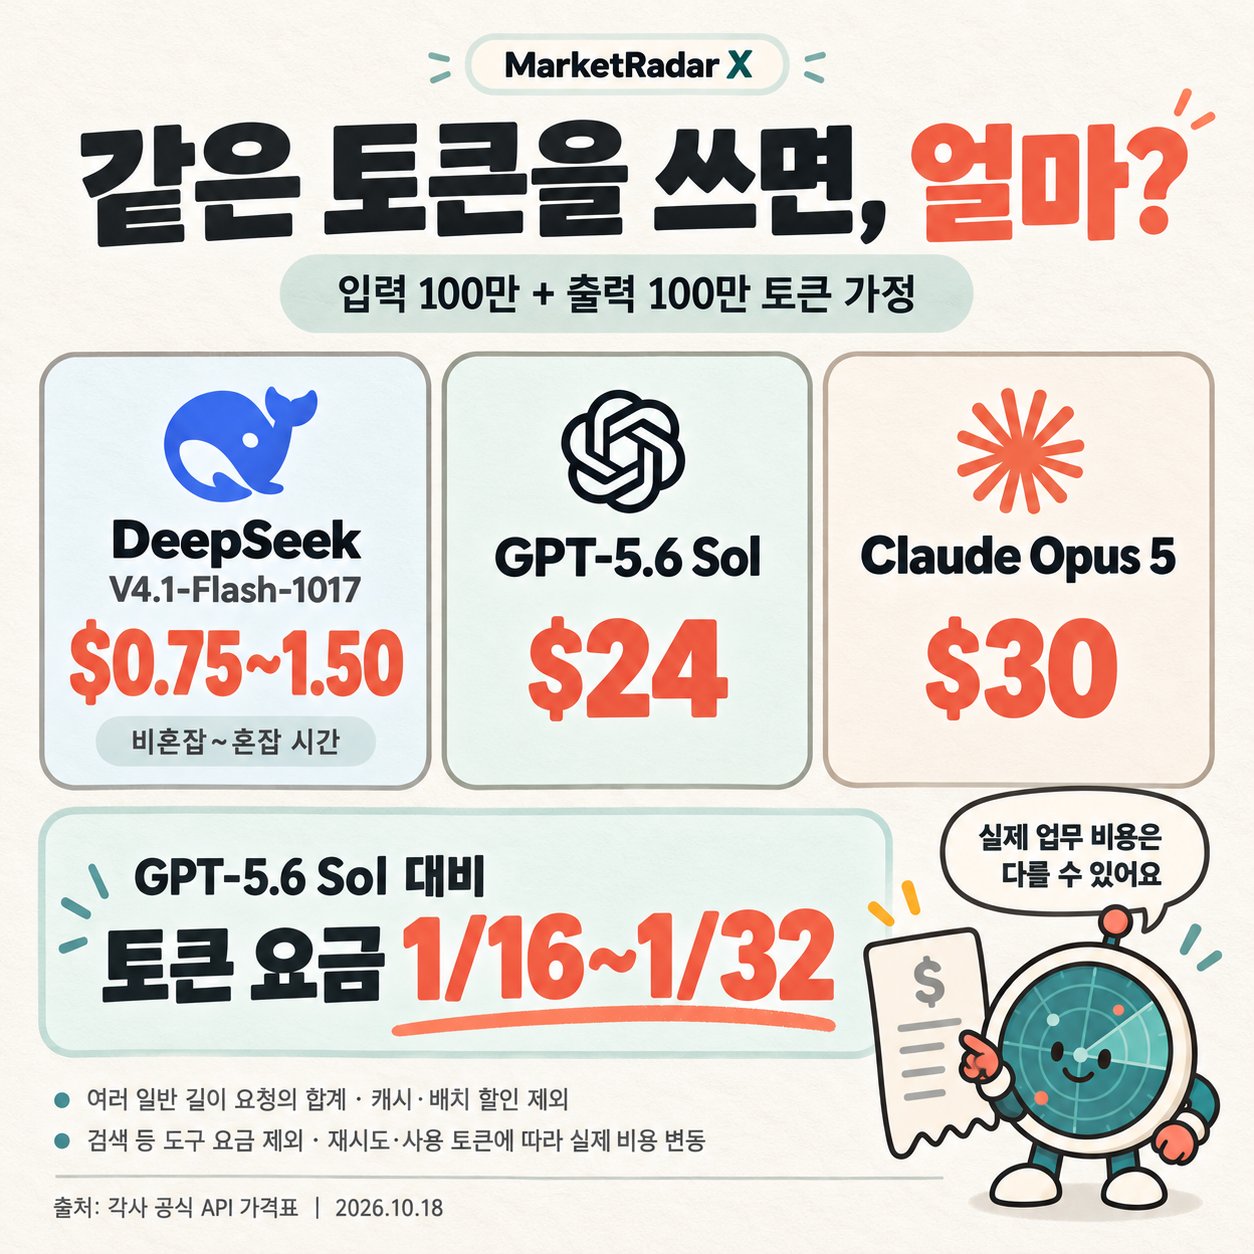
딥시크가 또 싸고 센 모델을 냈습니다. 그런데 이번엔 ‘GPT를 이겼다’보다 가격표 옆에 붙은 성적표를 봐야 합니다. 비싼 AI를 모든 일에 써야 하는 이유가 얼마나 남았을까요? 10월 17일 공개된 DeepSeek V4.1-Flash-1017. 핵심은 세 가지입니다. ① 일부 코딩·자동화 시험에서는 상위 모델과 경쟁합니다. 딥시크가 공개한 비교표입니다. 숫자는 각 시험 점수이며, 높을수록 좋습니다. 순서: 신형 딥시크 / GPT-5.6 Sol / Claude Opus 5 • DeepSWE v1.1: 77.0 / 73.0 / 74.0 • Automation-Bench: 60.5 / 45.8 / 50.3 • Agents’ Last Exam: 35.4 / 26.7 / 28.6 코드를 고치거나 도구를 써서 일을 수행하는 일부 시험에서는 꽤 강한 성적입니다. 이 범위에서는 ‘최상위권과 경쟁하는 성능’이라고 할 만합니다. 다만 ‘세계 최고 AI’라고 읽으면 틀립니다. 어려운 문제를 푸는 HLE에서는 딥시크 42.6, GPT-5.6 Sol 44.5, Opus 5 56.3입니다. 터미널 작업 시험도 딥시크 42.3, Opus 5 51.8로 차이가 납니다. 무엇보다 이 표는 딥시크 자체 발표이고, 비교 대상에 GPT-6 계열이나 Opus 5.5는 없습니다. 일부 시험의 우세와 최신 모델 전체를 이겼다는 주장은 전혀 다른 얘기입니다. ② 가격 차이는 확실히 큽니다. API에서 글을 읽는 입력과 답을 만드는 출력, 각각 100만 토큰당 달러 기준입니다. 앱 월 구독료가 아닙니다. • 딥시크 비혼잡 시간: 입력 $0.15 / 출력 $0.60 • 딥시크 혼잡 시간: 입력 $0.30 / 출력 $1.20 • GPT-5.6 Sol: 입력 $4 / 출력 $20 • Claude Opus 5: 입력 $5 / 출력 $25 감이 안 오니 같은 양으로 계산해 보겠습니다. 여러 일반 길이 요청을 합쳐 입력 100만·출력 100만 토큰을 썼다고 가정하면, 딥시크는 $0.75~1.50, GPT-5.6 Sol은 $24, Opus 5는 $30입니다. 이 가정의 토큰 요금은 GPT-5.6 Sol의 1/16~1/32 수준입니다. 캐시·배치 할인과 검색 같은 별도 도구 요금은 제외했습니다. 여기서 ‘실제 업무 비용도 32분의 1’이라고 말하면 안 됩니다. 모델마다 쓰는 토큰이 다르고, 실패해서 다시 시키거나 사람이 고치는 시간도 들어가기 때문입니다. ③ 그래서 바뀔 수 있는 것은 AI를 쓰는 방식입니다. 가령 매일 자료 수백 건을 읽고 분류하는 서비스라면, 모든 단계를 가장 비싼 모델에 맡길 필요가 있을까요? 반복 작업은 저렴한 모델에 맡기고, 애매한 판단이나 마지막 검증에만 강한 모델을 쓰는 방식이 더 매력적일 수 있습니다. 사용자에게 중요한 숫자는 ‘문제 몇 점’에 더해 ‘쓸 만한 결과 하나를 얻는 데 얼마가 드느냐’입니다. 투자 관점에서도 이 둘을 나눠 봐야 합니다. AI 서비스 기업에는 원가를 낮출 기회가 될 수 있지만, 모델을 파는 기업에는 비싼 가격을 정당화해야 하는 압력이 될 수 있습니다. 그렇다고 곧바로 ‘GPU 수요 감소’로 연결되지는 않습니다. 단가가 내려가서 사용량이 늘어날 수도 있고, 이번 API 가격표만으로 실제 연산 원가를 알 수도 없기 때문입니다. 제 판단은 이렇습니다. 이번 딥시크에서 볼 것은 ‘가장 똑똑한 AI가 바뀌었나’만이 아닙니다. ‘이 정도 일을 이 가격에 할 수 있다면, 비싼 모델은 어느 단계에 남겨야 하나’입니다. 다음으로 확인할 것은 독립 평가와 실제 업무 성공률입니다. 싼 답을 많이 만드는 것과, 싸게 일을 끝내는 것은 다릅니다. 출처: DeepSeek 공식 모델 카드·API 가격표, OpenAI·Anthropic 공식 가격표. 10/18 확인. 벤치는 제조사 발표, 비용 예시는 동일 토큰량 가정 계산.