DeepSeek model tops GPT-6 Astra on DeepSWE at 1/20 the cost
A Japanese thread breaks down a new DeepSeek model: 77.0% on DeepSWE versus GPT-6 Astra's 74.1%, about $0.2 per task (roughly 1/20 of Astra), and runnable on a single desktop machine.
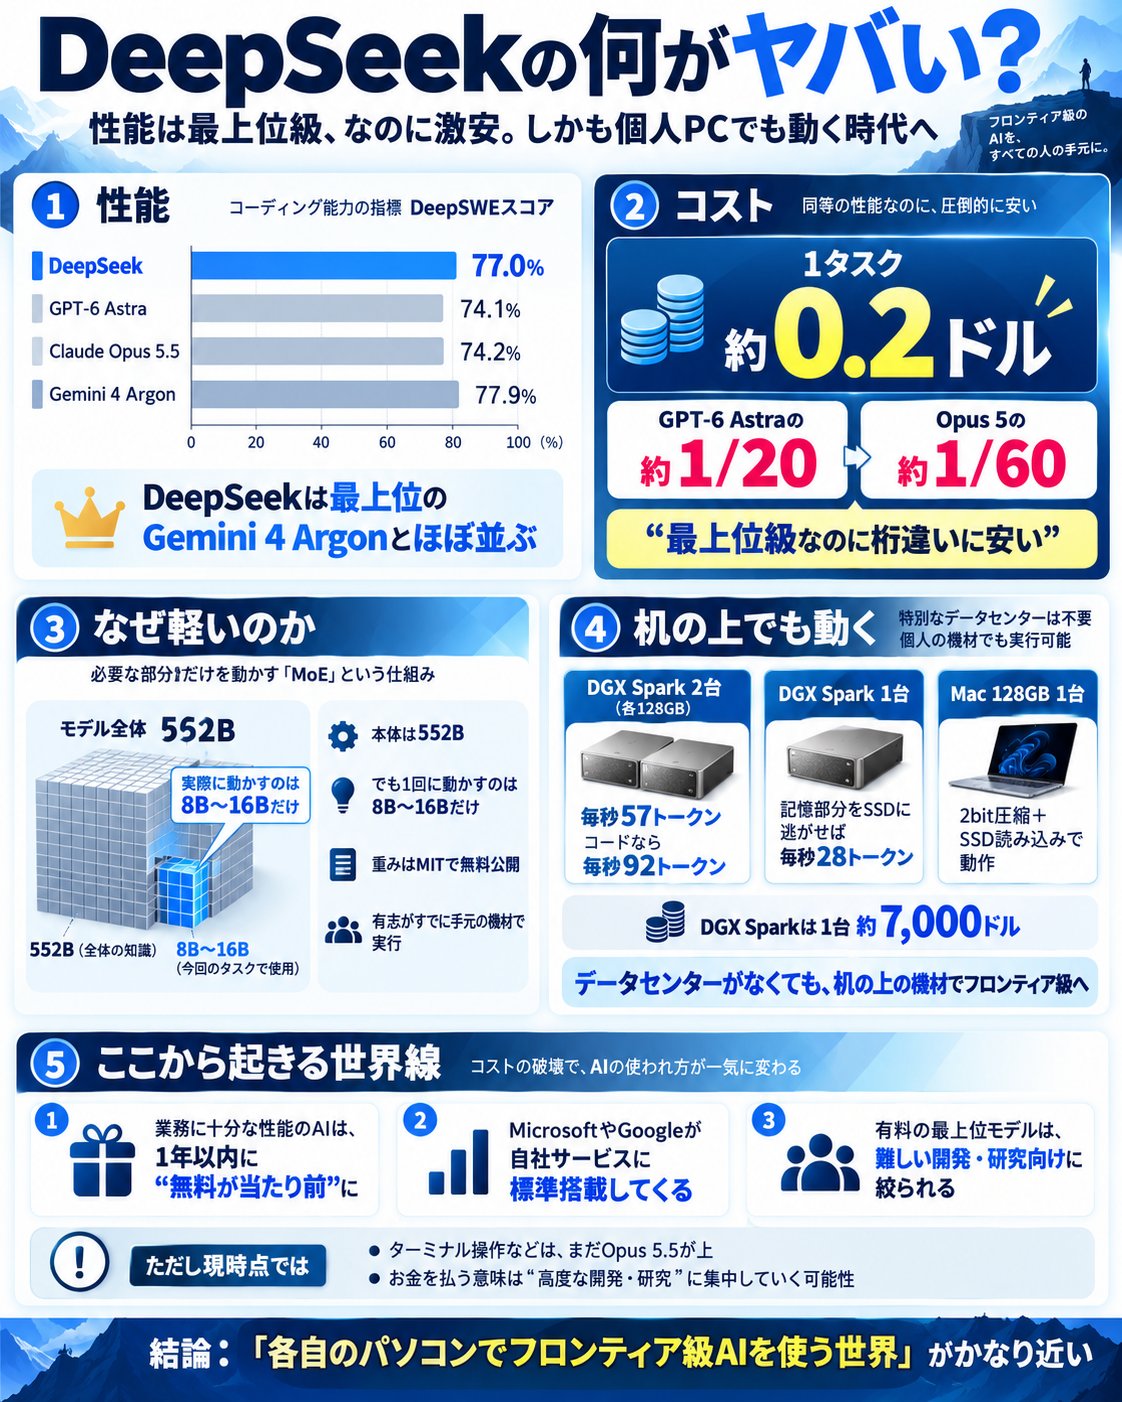
DeepSeekの何がヤバいのか、もう少し詳しく解説します。 まず性能。開発力を測るDeepSWEで77.0%。GPT-6 Astra(74.1%)やClaude Opus 5.5(74.2%)を上回り、最上位のGemini 4 Argon(77.9%)とほぼ並びました。 なのにコストは桁違い。同じ問題を解く費用は1タスク約0.2ドルで、GPT-6 Astraの約20分の1、Opus 5の約60分の1。 しかも軽い。本体は552Bありますが、1回に動かすのは8B〜16Bだけ。重みもMITで無料公開されていて、すでに有志が手元の機材で動かしています。 ・NVIDIA DGX Spark(メモリ128GB)2台で毎秒57トークン、コードなら92トークン ・DGX Spark 1台でも、記憶用の部分をSSDに逃がせば毎秒28トークン ・Macならメモリ128GBの1台でも、2bitに圧縮してSSDから読みながら動く DGX Sparkは1台約7,000ドル。データセンターがなくても、机の上の機材でフロンティア級が動く時代です。私がずっと言ってきた「各自のパソコンでフロンティア級のAIを使う」世界がかなり近づきました。 ここから見える世界線はこうです。 ・業務に十分な性能のAIは1年以内に無料が当たり前に ・MicrosoftやGoogleが自社のサービスに標準で載せてくる ・有料の最上位モデルは難しい開発や研究をする一部の高度人材だけ 実際、ターミナル操作などはまだOpus 5.5が上。最上位にお金を払う意味はそこに絞られていくと思う。
This post quotes another post: x.com/masahirochaen/status/2111495080796406204