deepseek-v4.1IMAGE
DeepSeek V4.1 Flash inference speed race: Fireworks hits 1,521 tok/s
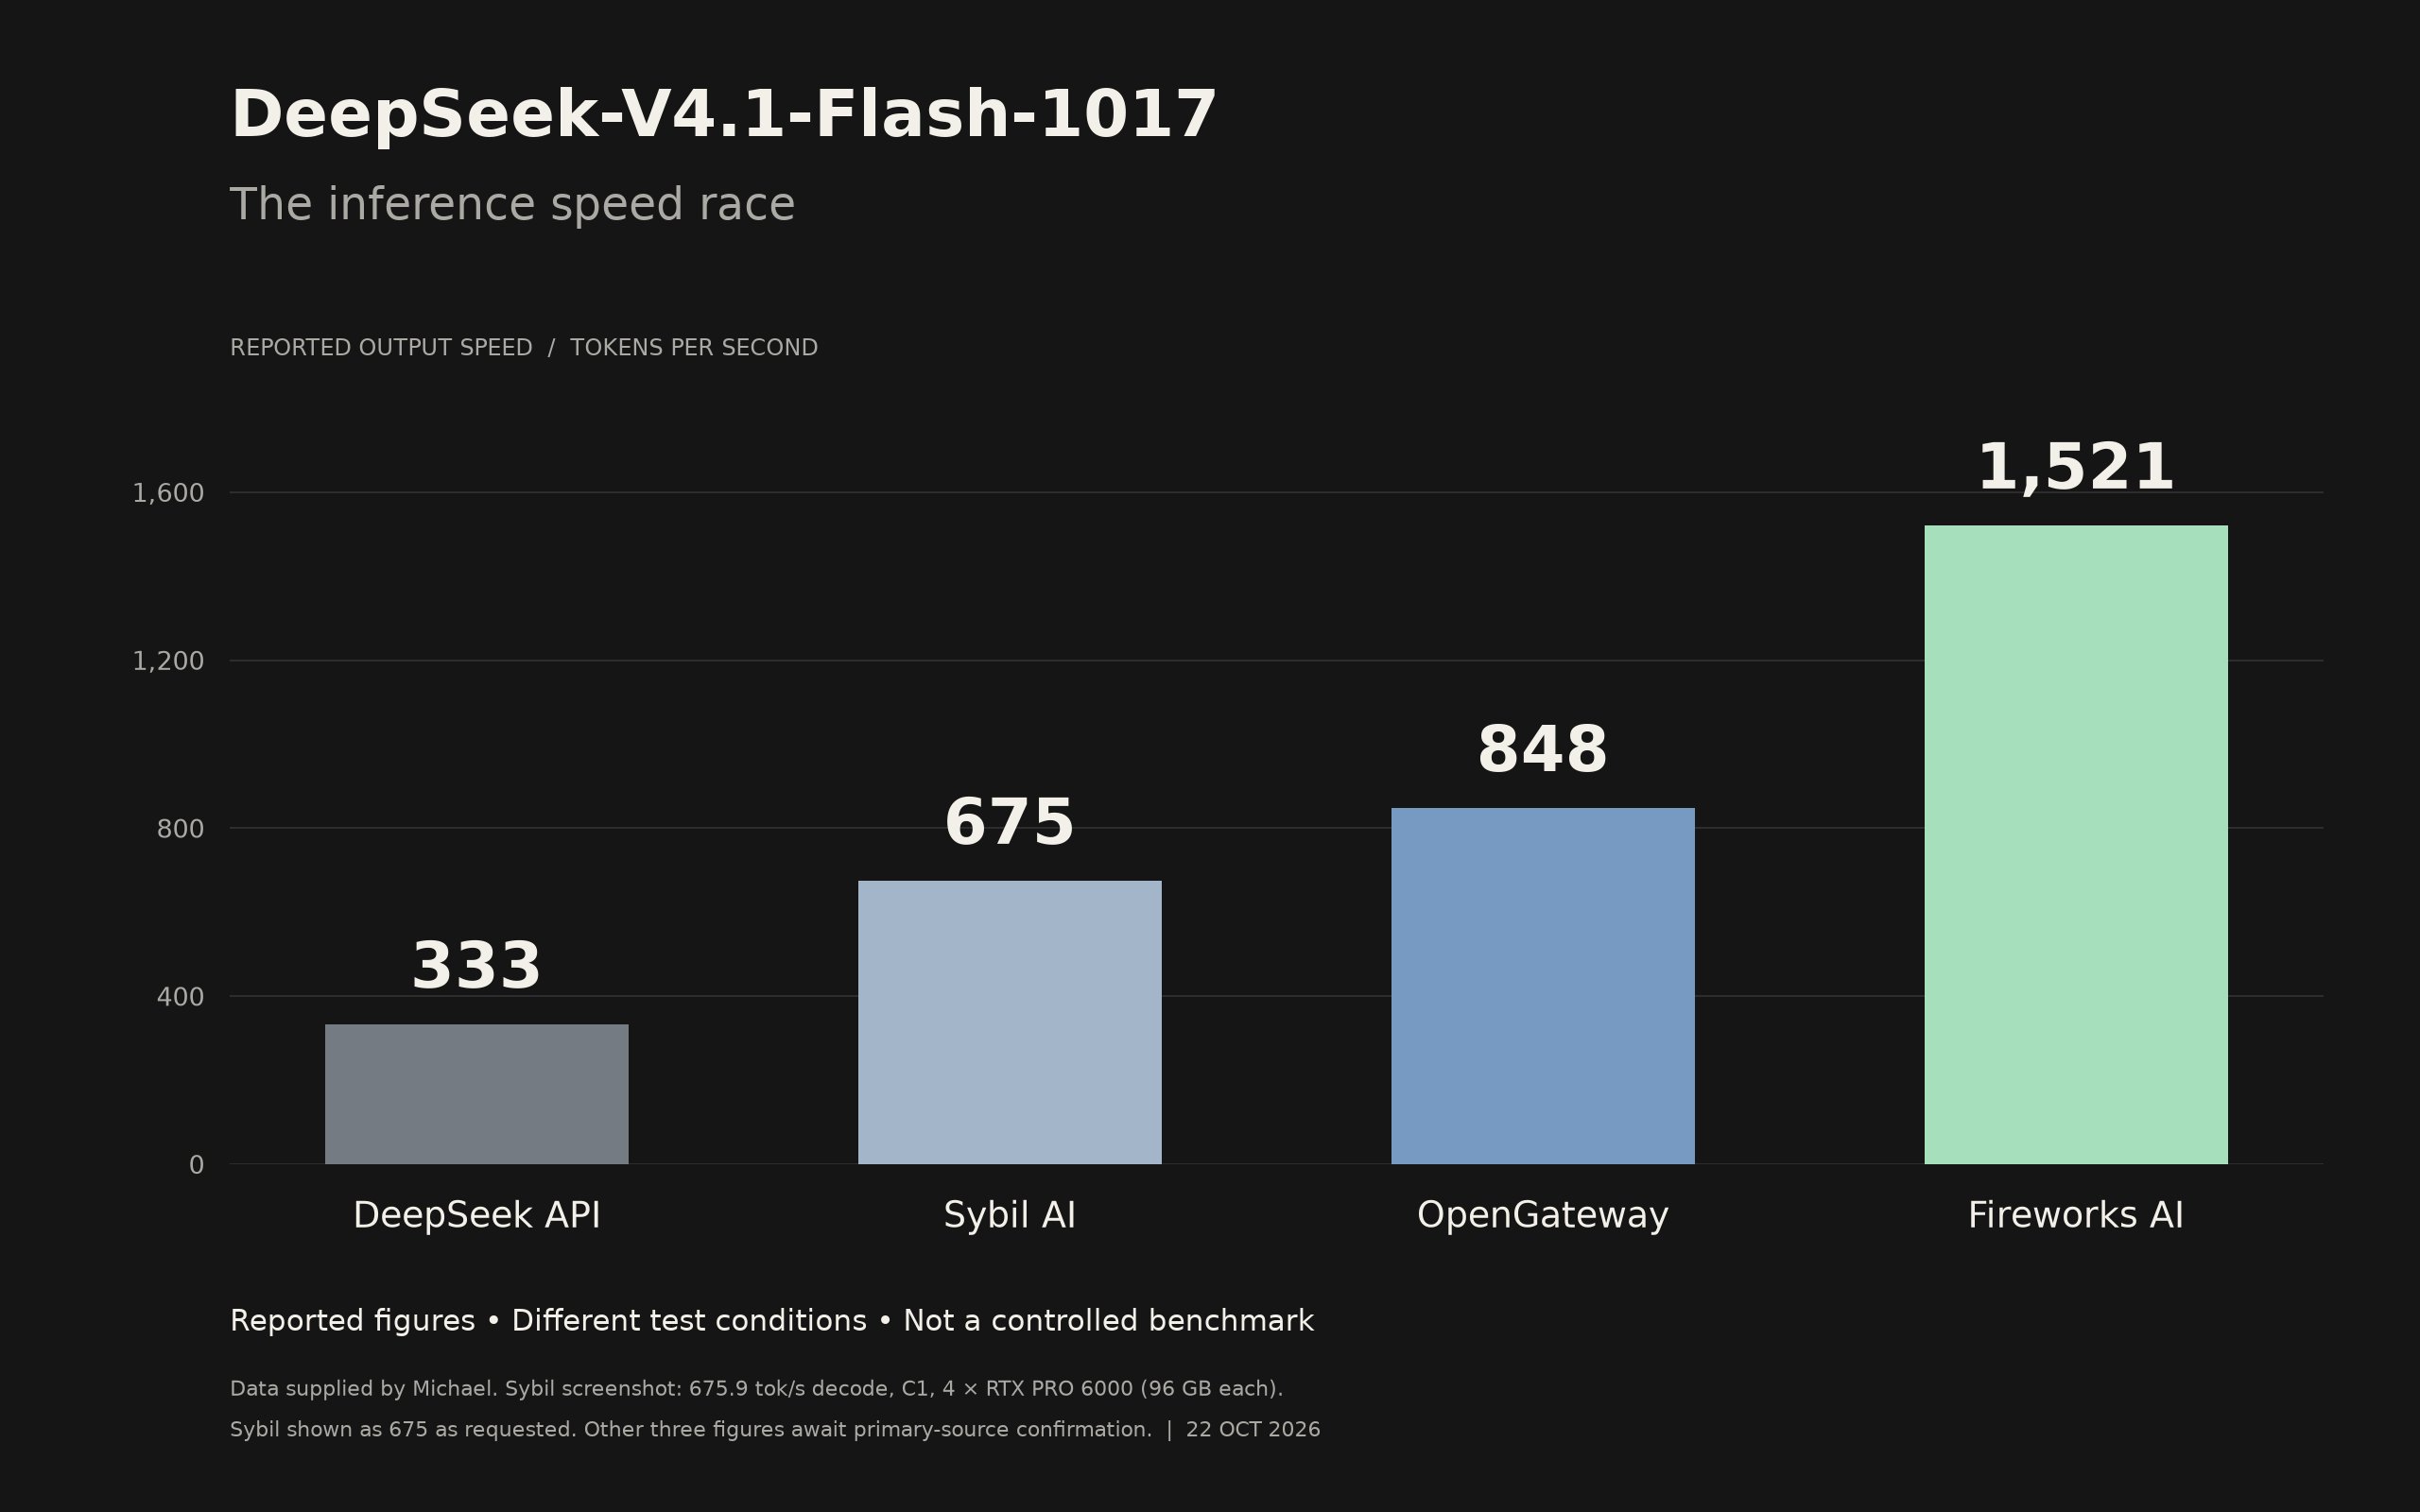
Infra providers are racing to speed up V4.1 Flash 1017, from DeepSeek's official 333 tok/s to Fireworks AI's 1,521 tok/s, enabled by open weights and DSpark speculative decoding.
Michael Guo
@MichaelzsguoArchived 9 days agoOriginally posted 2026.10.23
Michael Guo @MichaelzsguoOriginally posted 2026.10.23
这几天,几家 AI 基础设施公司围绕 DeepSeek V4.1 Flash 1017,展开了一场推理加速竞赛。 目前看到的输出速度: DeepSeek 官方:333 tokens/s Sybil AI:675 tokens/s OpenGateway:848 tokens/s Fireworks AI:1,521 tokens/s 为什么 DeepSeek V4.1 Flash 这么适合做推理优化?为什么各家都在争相加速它? 关键在于开放权重,让基础设施公司有机会深入优化整个推理过程。具体到 V4.1 Flash,DSpark 推测解码提供了一条直接提升输出速度的路径;而 MoE 架构中的专家调度、访存和跨卡通信,又给不同团队留下了充分发挥优化能力的空间。 同一个模型,在不同的推理基础设施上,速度竟然可以相差数倍。这场竞赛比拼的已经不只是模型本身,更是底层推理工程的实力。
This post quotes another post: x.com/rlaope/status/2113213018662371710
x.com/michaelzsguo/status/2113415328944300285Archived 2026.10.23 12:05