Sonnet 5.5 criticized as poor value against Opus and Astra
A breakdown of cost data from FrontierCode, Terminal Bench, Cursor Bench and other benchmarks argues Sonnet 5.5 is more expensive than Opus 5.5 and GPT-6 Astra at most levels.
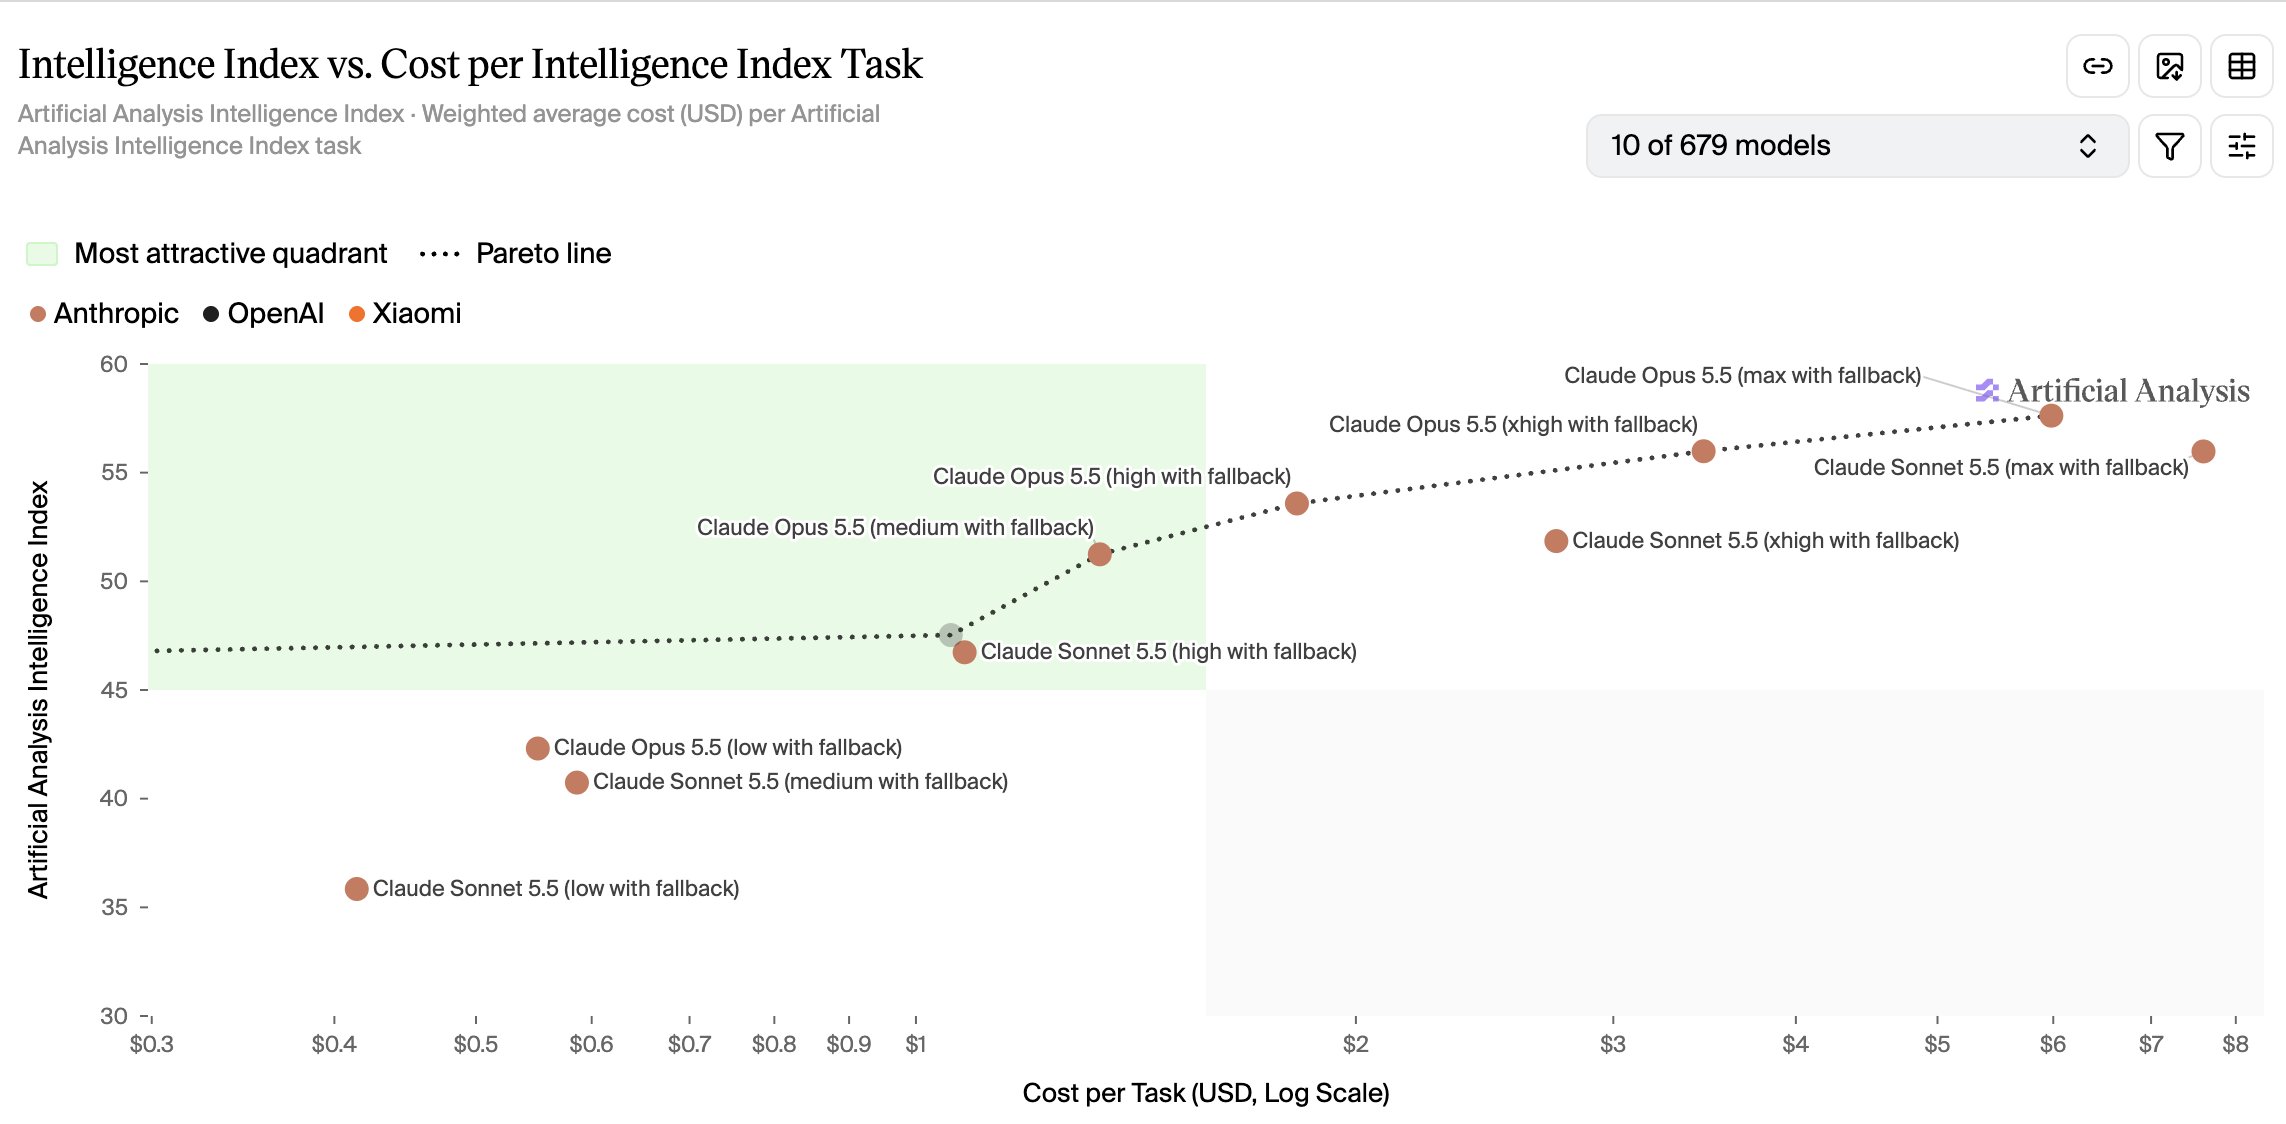
Dostaliśmy właśnie Claude Sonneta 5.5. I wygląda na to, że to kolejny bezużyteczny model tej klasy. Dlaczego? Opus 5.5 został tak dobrze wyceniony przez Anthropic, że Sonnet 5.5 na pierwszy rzut oka nie ma sensu. W większości benchmarków, które udostępniło samo Anthropic przegrywa kosztowo per poziom inteligencji z Opusem. We FrontierCode dzieją się rzeczy niezrozumiałe - nie dość, że okazuje się na większości poziomów rozumowania mniej efektywny kosztowo niż Opus 5.5, to na poziomie Max wydaje od Opusa prawie 3.5x więcej per zadanie (!). Jakby tego było mało, przejście z poziomu xhigh na max oznacza wzrost kosztu aż o 13x (!!!). W Terminal Bench 4.0 przegrywa pod kątem efektywności kosztowej na każdym poziomie myślenia, poza Max - na którym to jest od Opusa droższy. W Cursor Bench 4.0 ponownie obrywa od Opusa pod kątem efektywności na niemal każdym poziomie efektywności. Podobnie wygląda szeroko rozumiana praca umysłowa w AA-Briefcase, gdzie również Opus 5.5 okazuje się przynajmniej podobny pod kątem efektywności. Problem z poziomem Max jest też widoczny w meta benchmarku Vals AI - gdzie Sonnet 5.5 jest niemal 2x droższy niż Sonnet 5 - a nawet droższy niż GPT-6 Astra. Z kolei w meta benchmarku Artificial Analysis na poziomie Max jest o prawie 30% droższy od Opusa 5.5. Warto przy tym pamiętać, że Sonnet to mniejszy model, zazwyczaj przepuszczony przez mocniejszy reinforcement learning. W konsekwencji - można się spodziewać, że będzie popełniał więcej głupich błędów niż Opus 5.5, gorzej rozumiał intencje użytkownika i dawał mniej dopracowane wyniki pracy - nawet jeżeli nie widać tego od razu w benchmarkach. Oczywiście jak zawsze, należy go przetestować na swoich zadaniach. To co na pewno mogę już teraz Wam podpowiedzieć, to że jak ognia należy wystrzegać się ekstremalnie nieefektywnego kosztowo poziomu Max. Wygląda na to, że low-high to jedyne poziomy myślenia, na których ten model może mieć jakikolwiek sens. Natomiast patrząc na koszty per zadanie - wygląda na to, że Anthropic ponownie wypuszcza Sonneta jako konia trojańskiego w swoim ekosystemie. Sonnet wykorzystywany jest automatycznie jako subagent - mały, stosunkowo drogi dla użytkownika model, który oferuje stosunkowo niewiele w swojej klasie cenowe - ale dzięki niskim kosztom serwowania, podbija Anthropic marże. Do czasu aż porządnie przetestujecie go na swoich zadaniach (lub poczekacie +/- tydzień na moją recenzję), zachęcam profilaktycznie wymusić w Claude korzystanie z Opusa 5.5 low/medium jako subagenta i całkowicie zakazać korzystania z Sonneta. Co sądzisz o Sonnecie 5.5? Miałeś już okazję go testować?