Essay: the name GPT no longer fits today's models
The author unpacks what GPT originally stood for and argues that pre-training plus Transformer no longer describes multimodal, reinforcement-learning and continually learning models, with Astra now just a brand name.
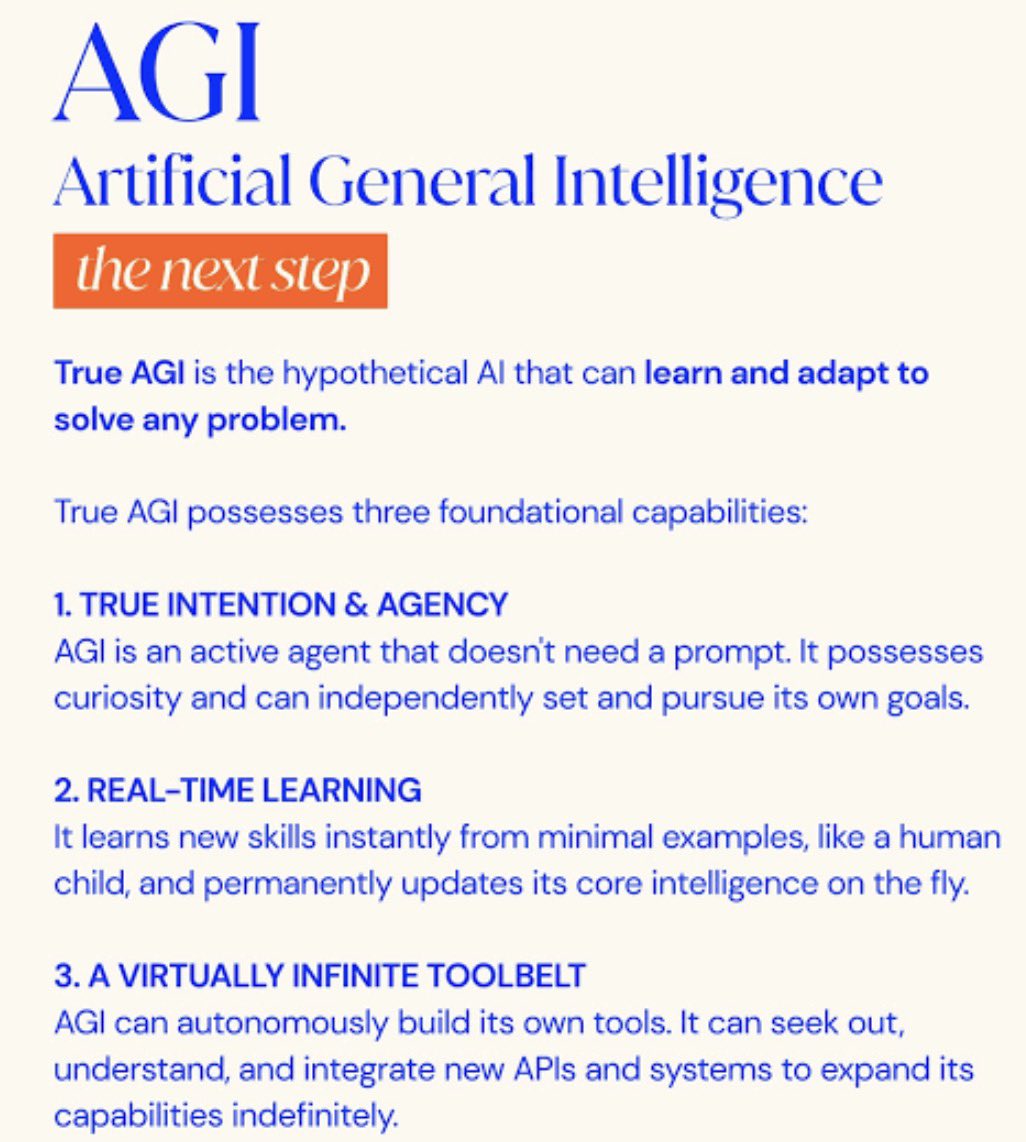
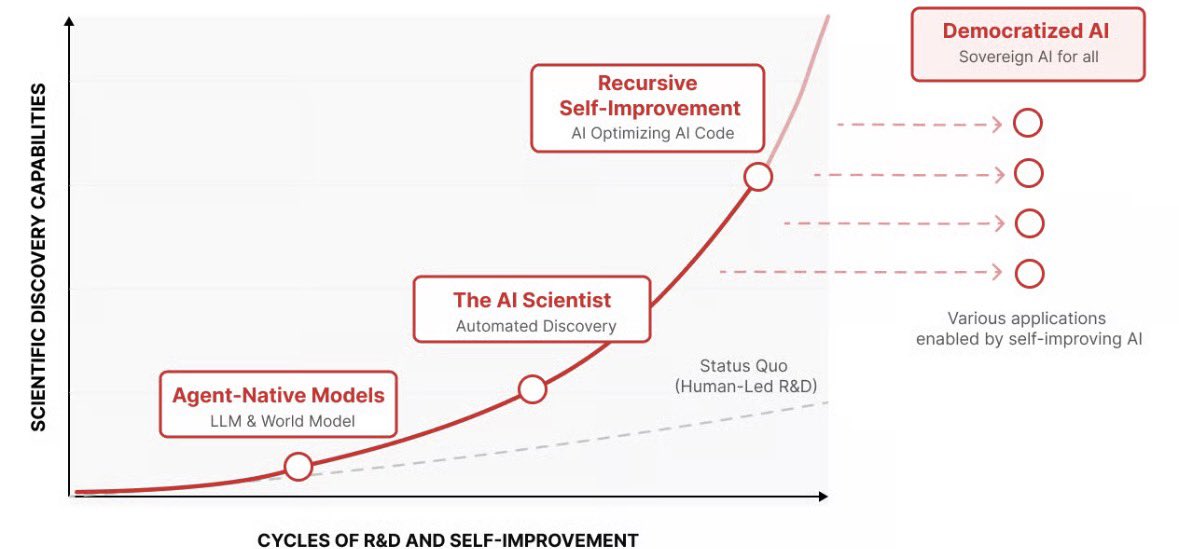
我认为,GPT这个名字已经越来越不能准确描述现在的AI模型的境遇了。 ChatGPT的GPT到底是什么意思呢? 先说表层,GPT,Generative Pre-trained Transformer。 首先,Generative,生成式。早期 AI 主流是判别式的,比如判断一封邮件是不是垃圾邮件。OpenAI 押注的是,如果一个模型能很好地预测下一个词,它就必须理解语言、知识甚至推理。 生成,被当作通往理解的路径。 然后,Pre-trained,预训练。很简单,就是不再为每个任务单独标注数据,先让模型在互联网规模的文本上自学。这让更多数据和算力换更强能力成为可能,后来,演变成著名的 scaling 路线。 OpenAI 2018 年的第一篇 GPT 论文,标题就是《通过生成式预训练提升语言理解》。 Transformer,它的注意力机制可以高度并行计算,这才让超大规模训练在工程上可行。 所以 GPT 这个名字,本质上记录的是一个信念。简单的目目标(预测下一个词)+ 足够大的规模 = 通用智能的雏形。 为什么GPT无法定义现在的模型呢? 因为如今的模型不只是预训练,还经过大量强化学习训练;不只处理文本,还能看图、听声音、操作电脑。 GPT 也已经从技术描述变成一个品牌名,比如GPT-6 Astra。 而虽然 Transformer 仍是基石,但多模态原生架构、长文本注意力机制的改良,甚至混合专家模型的引入,让它远比最初的 Transformer 复杂得多。 无论是持续学习还是自动化 AI 研究,它们都在做同一件事,那就是让 AI 拥有自我进化的能力,彻底摆脱人类手工训练的效率瓶颈。 未来的突破,一定是活着的有机体。持续学习让模型在部署后,能像人类一样边工作边吸收经验。它能在不污染旧知的前提下,把每天遇到的新案例、新错误转化为长期的内部记忆。为 AI 构建一个真正的长期记忆皮层,让它越用越聪明,形成真正的个性化和本地进化,是我们要看到的。 不过,如果AI 开始主导 AI 的研发,人类必然会面临黑盒之上的黑盒。可解释性是一个思路,可扩展监督也是,但是这些都是开放问题,目前没有人解决。