Gemini 4 Argon tops blind tests, but the agent race is the real focus
Gemini 4 Argon leads community blind tests in overall text ability, but after rounds of GPT, Claude and Grok releases the author sees the main battlefield shifting to agents like Grok Bot, Meta Muse and OpenAI Dots.
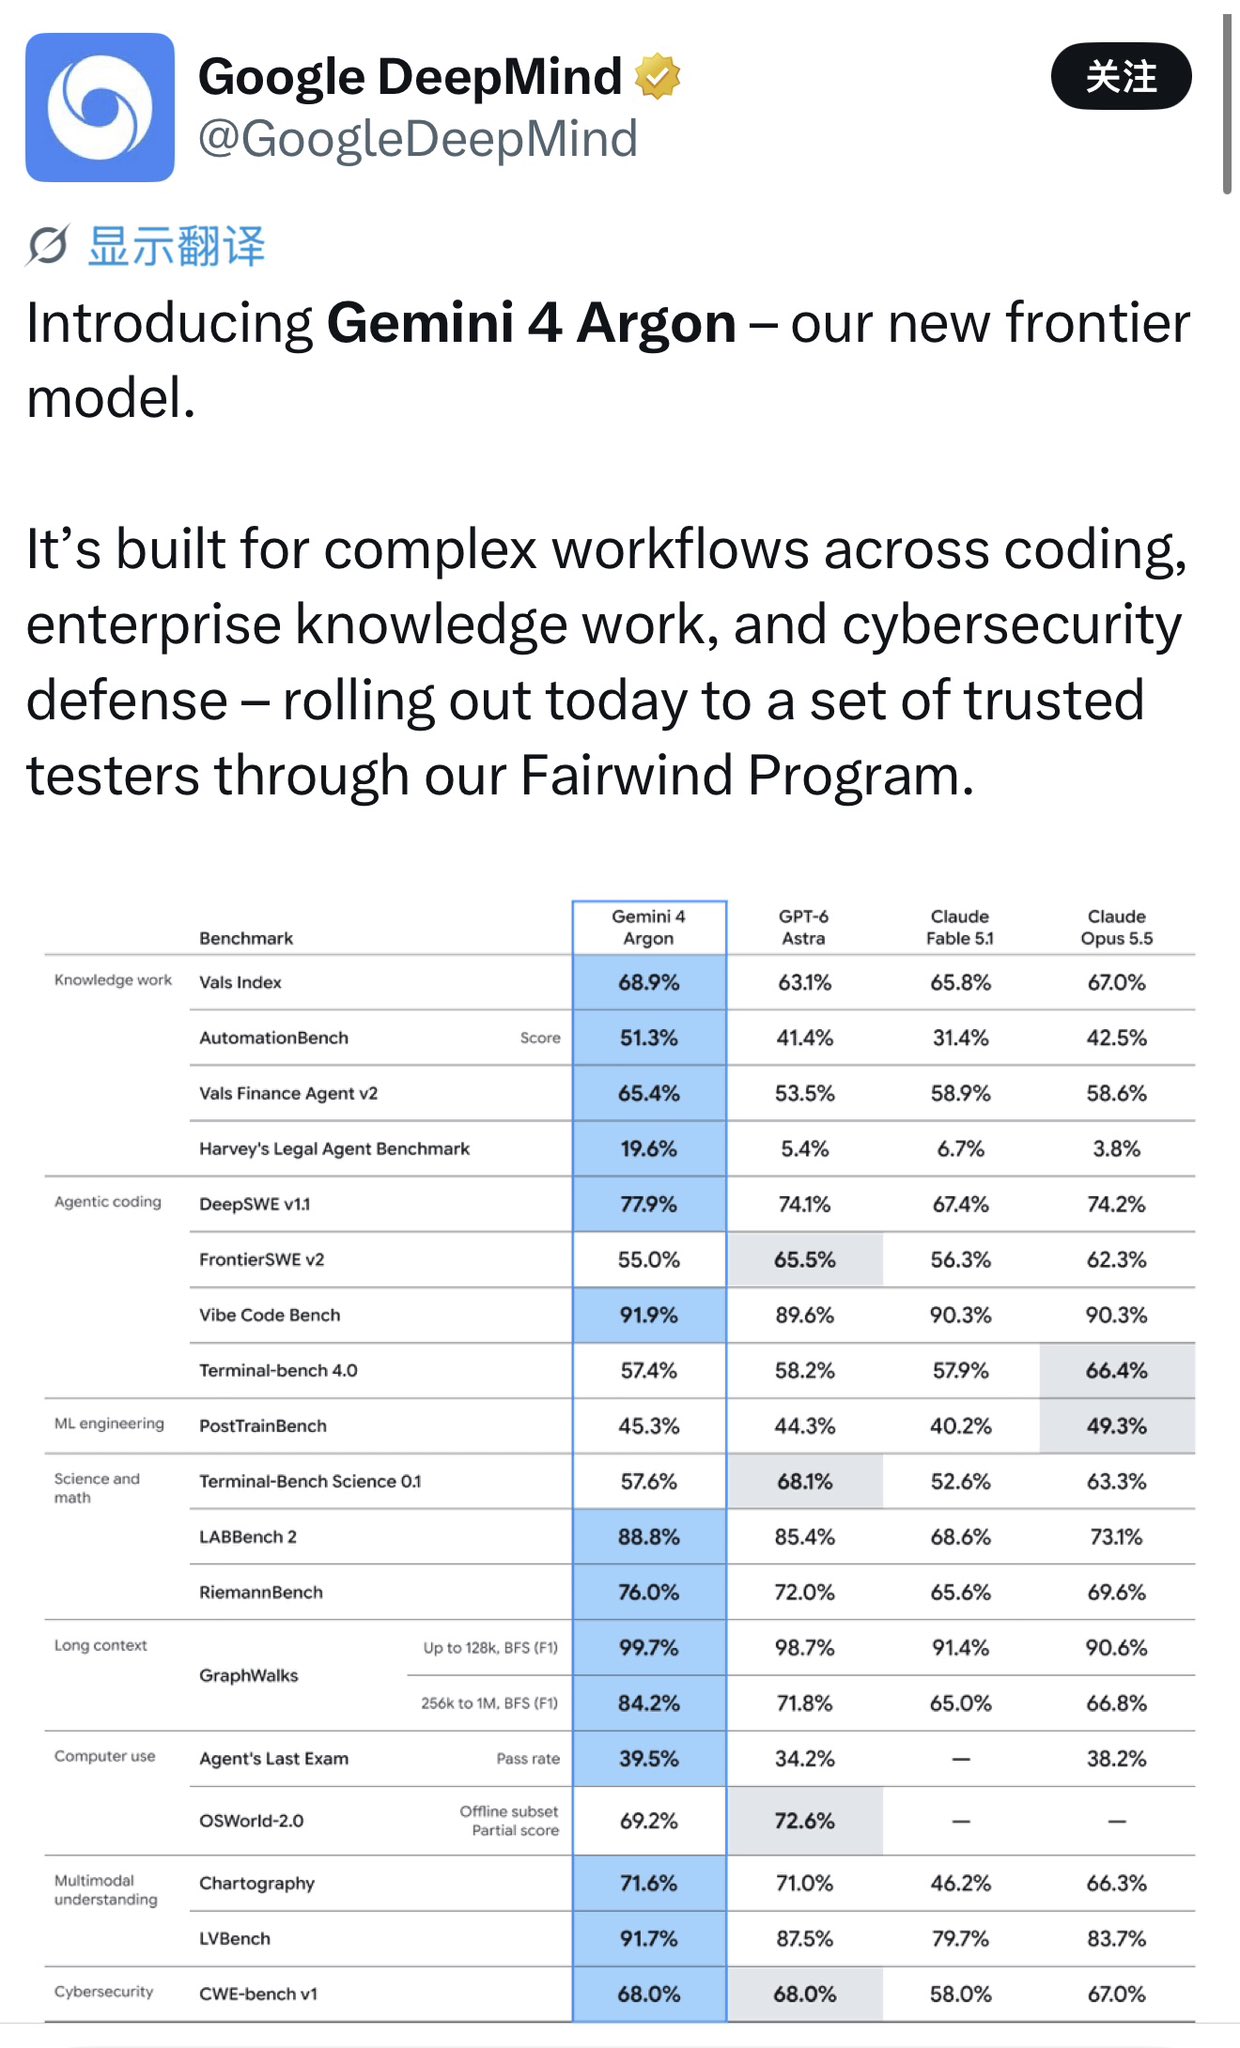
年初说大模型厂商各领风骚三五月,没有一家能长期领先甚至垄断,都是快速迭代、轮流坐庄。这不延迟几个月之后Gemini4终于发布了,Gemini 4 Argon (High) 的社区盲测表现很强,尤其在文本综合能力上直接登顶。不过今年市场经历过GPT5.5、5.6、6Astra,Claude fable 5.1、Opus 5.5 ,Grok 4的轮番轰炸,这还不算中国大模型的更高频的迭代,其实有点麻木了。 而且貌似AI主战场当下的焦点已不在模型本身而是转移到Agent上,Grok Bot、Meta Muse、OpenAI Dots等近期轮番上场,不断在推动这一点的迭代。其实谷歌做Agent也很有优势:有超大用户量、海量数据积累、强分发能力,这块发力应该也很有看头。 2月中在《资本开支的战争》推文里有聊过:”往下游看,越往用户端竞争越激烈,当然也是未来AI决胜的关键所在。 可以说大模型、在面向B端或者C端的Agent或者应用才是AI的王冠,但这一层面短期其实很难看出谁会成为最后真正的赢家,再很多时候都是交替领先” https://x.com/qinbafrank/status/2023597321368547520?s=46&t=k6rimWsEbo2D2tXolYcM-A
This post quotes another post: x.com/qinbafrank/status/2047491554609422452