Codex with Jev decision layer scores 24/50 vs 20/50 on 50-question test
A Turkish developer found diagnosis and fixes are still done by the main Codex or Claude model, with Jev stepping in only at decision points like which hypothesis to test first or whether evidence is sufficient; on a small sample Codex alone scored 20/50 and with Jev 24/50.
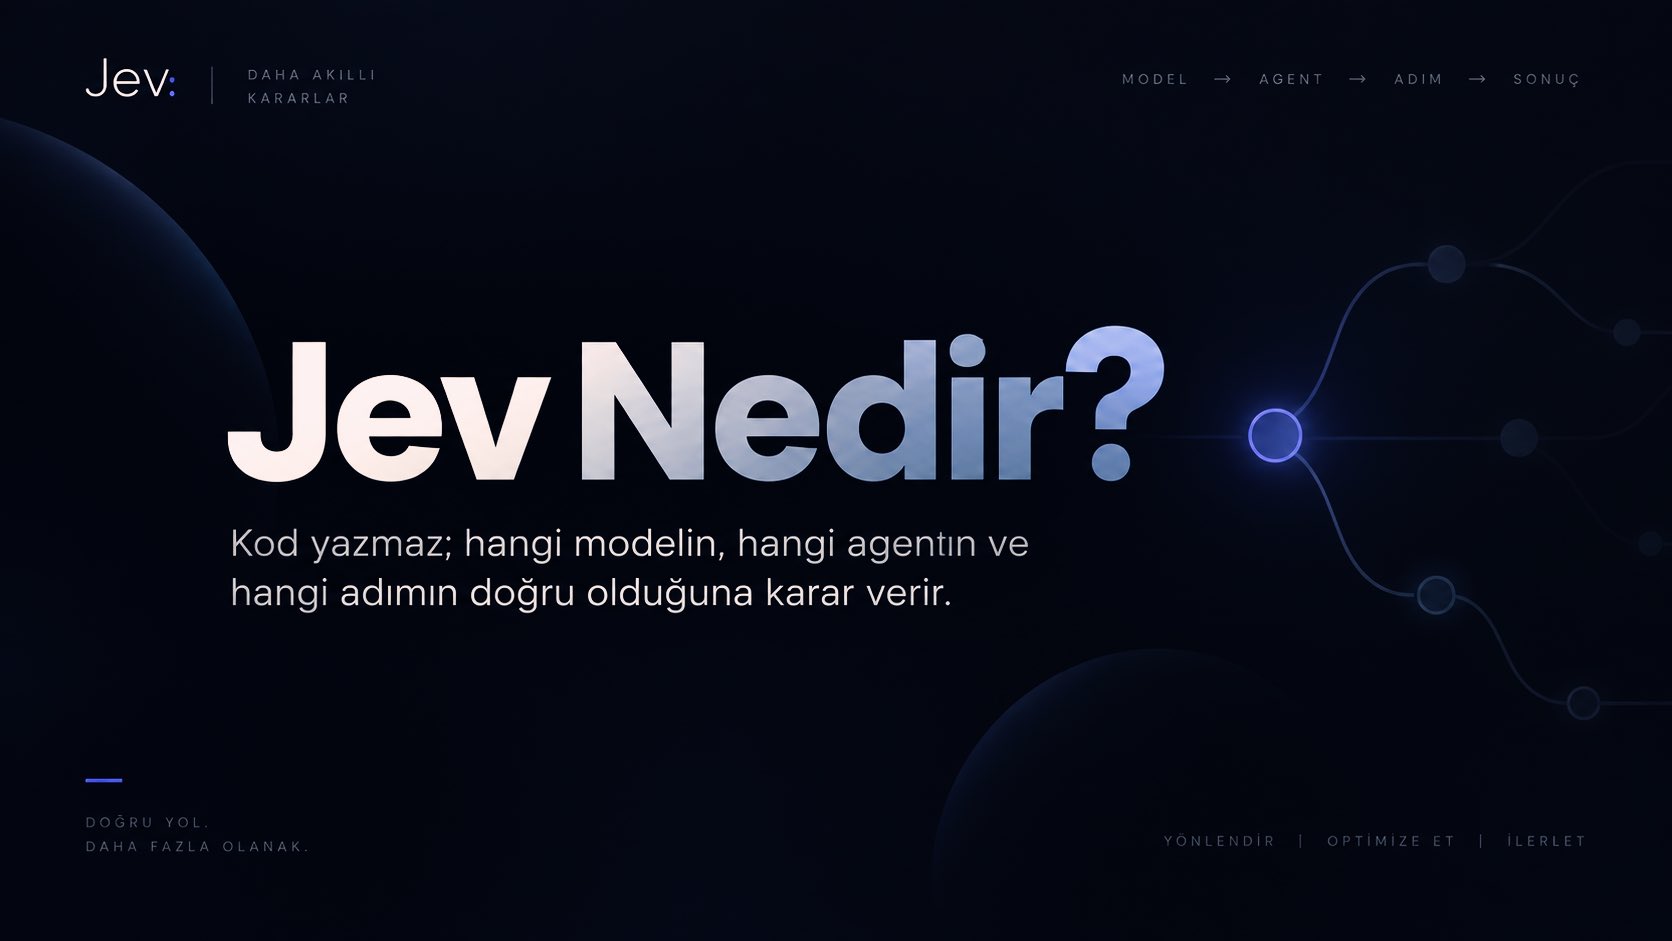
Jev’i ilk gördüğünüzde “büyük bir model daha çıkmış” diye düşünmeniz normal. Artık gün içerisindeki gelişmeleri geçtik; saatler, hatta bazen dakikalar içinde “inanılmaz” şeyler oluyor. Uzun uzun anlatacağımız bir makale ayrıca gelir ama şimdilik Jev hakkında şunu bilin: Jev, üretmekten çok karar vermek için tasarlanmış bir model. Kafanız karışmasın diye netleştirelim. Ufak çaplı testlerde Codex ya da Claude fark etmiyor; teşhisi ve düzeltmeyi yine ana model yapıyor. Jev ise yalnızca: Hangi hipotez önce test edilmeli? ve Eldeki kanıt yeterli mi? gibi karar noktalarında devreye giriyor. Yakın tarihli küçük bir Codex testinde sonuç: Codex tek başına: 20/50 Codex + Jev: 24/50 Yani Jev tek satır kod yazmadan, yalnızca karar katmanı olarak agent başarısını artırmış. Örneklem küçük, dolayısıyla genelleme yapmak için erken. Ama yön baya ilginç. Mimarimiz belli: User → Jev → doğru model → doğru agent → doğru tool → doğrulama → final Şimdi birkaç daha detaylı test yapayım. Geliyorum :)