Thai breakdown of V4.1 Flash 1017: multimodal, benchmark gains, 510GB weights
Explains 1017 is an MIT-licensed multimodal open-weight model, Terminal-Bench 4.0 up from 31.2 to 42.3 and DeepSWE from 74.2 to 77.0, 1M context, but weights span 48 shards totaling ~510GB so it won't run on a laptop.
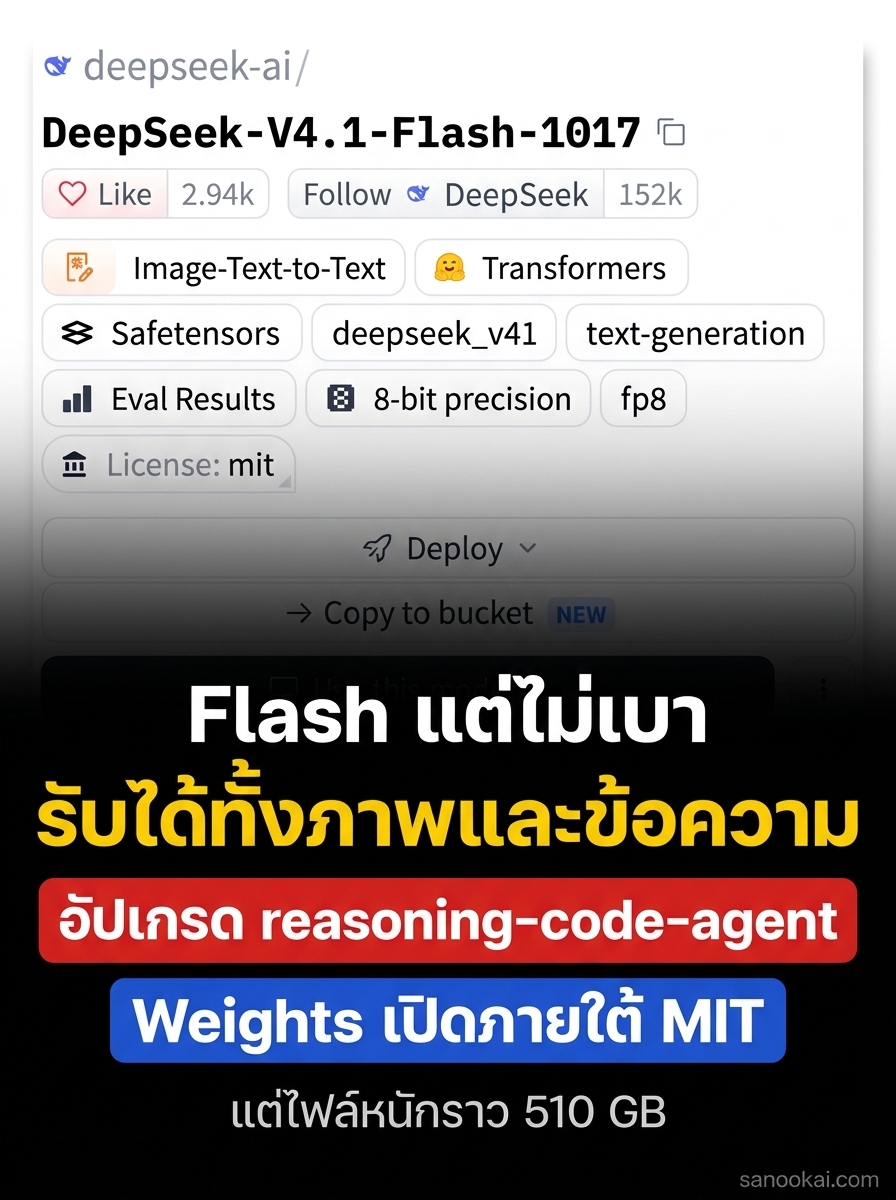
DeepSeek-V4.1-Flash-1017 ที่เพิ่งอัปเดตนี่ไม่ใช่ของเล่นเบา ๆ ครับ . มันเป็นโมเดล open-weight ที่รับได้ทั้งข้อความและภาพ ใช้ดูรูปหรือสกรีนช็อต แล้วคุยต่อหรือสั่งงานด้วยข้อความใน flow เดียวกันได้ . จุดที่ DeepSeek เคลมว่าน่าสนใจคือ รุ่น 1017 ทำ reasoning, เขียนโค้ด และงาน agent ได้ดีขึ้นกว่ารุ่น V4.1-Flash เดิม โดยตัวเลขจากทีมเองบน Terminal-Bench 4.0 ขยับจาก 31.2 เป็น 42.3 ส่วนงาน DeepSWE ขยับจาก 74.2 เป็น 77.0 . ของที่ผมว่ามีประโยชน์จริงคือมันพยายามลดทั้งเวลารันงานและความยาวคำตอบ ถ้าเอาไปต่อกับ workflow ที่ต้องวนแก้โค้ด อ่านเอกสารยาว ๆ หรือให้ agent ใช้ภาพเป็นบริบท ต้นทุนต่อรอบมีโอกาสลดลง ไม่ใช่แค่ตอบเก่งขึ้นบนกระดาษ . อีกข้อคือ weights เปิดภายใต้ MIT License และ model card ระบุ context ได้ถึง 1M tokens คนที่มีทีมวิศวกรรมจึงเอาไปทดลองต่อหรือวางบน infrastructure ตัวเองได้ ไม่ต้องล็อกอยู่กับ API เจ้าเดียว . แต่คำว่า open ไม่ได้แปลว่าเปิดโน้ตบุ๊กแล้วรันได้เลยนะครับ ไฟล์โมเดลมี 48 ส่วน กินพื้นที่รวมราว 510 GB จึงไม่ได้เป็นของที่คนทั่วไปโหลดมารัน local ได้ง่าย ๆ อีกอย่าง benchmark ชุดนี้เป็นตัวเลขที่ DeepSeek รายงานเอง งานจริงควรลองกับข้อมูลและงานของเราก่อน . ผมมองว่า 1017 น่าสนใจเพราะมันไม่ขายแค่ “ฉลาดขึ้น” แต่พยายามแก้ pain point ของคนทำ agent คือช้า แพง และต้องสลับระหว่างภาพกับข้อความไปมา . AI ช่วยเราวิ่งเร็วขึ้นได้ แต่คนยังต้องเลือกโจทย์ วัดผล และรับผิดชอบคำตอบอยู่ดีครับ #DeepSeek #AIModel #AIAgent