Jev context compaction draws criticism as tests expose memory loss
Former Apple engineer Tamara open-sourced fast-jev-compaction, which uses the small Jev model to score tool calls and delete useless records; Theo argues deleting history breaks reasoning and invalidates prefix caching, and the author's own test found that deleted error logs make the agent repeat the same mistakes.
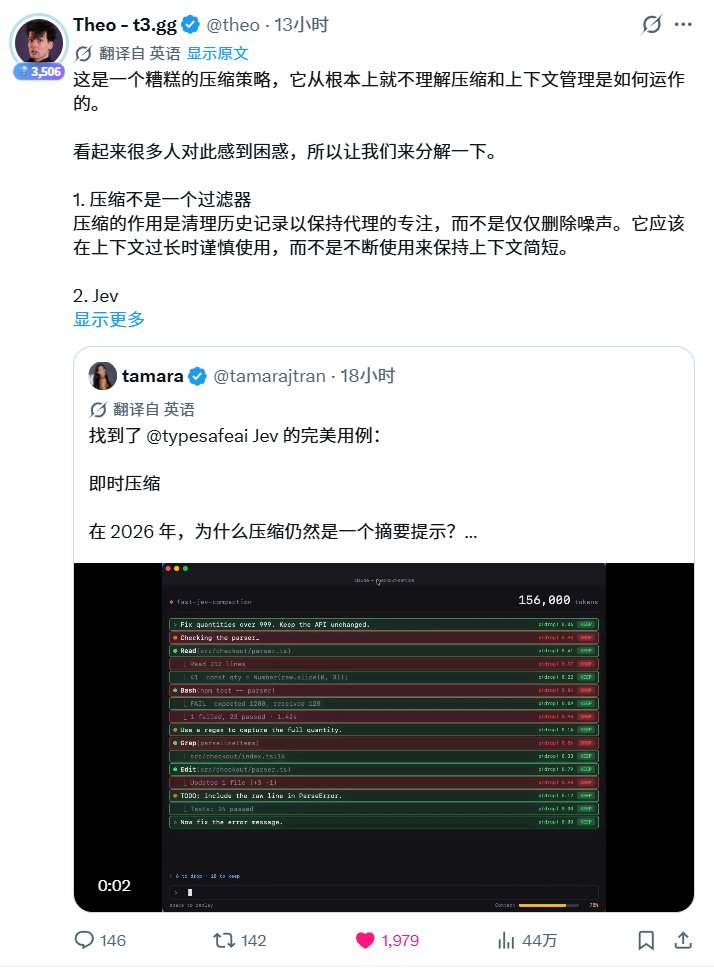
全网爆火的JEV 上下文即时压缩策略,被狠狠开喷了... 起因是前苹果工程师 Tamara @tamarajtran 开源了 fast-jev-compaction,主张彻底抛弃大模型写全文总结的做法,改用毫秒级小模型 Jev 给每条工具调用打分,没用的直接删,只留关键原文 然而前 Twitch 工程师Theo @theo 不认可这种做法..... • Tamara 的逻辑:大模型做总结经常胡说八道、严重漏细节,动不动就把具体报错、文件路径甚至“绝对不能改某代码”的硬规则给概括没了。用小模型瞬间过滤掉无用记录,不仅快,而且能完整保留关键代码 • Theo 的反驳:中途乱删历史等于自己坑自己 第一,现在的顶尖模型在后台有一整套加密的推理逻辑,你把中间调用删了,模型智商直接断崖式下跌; 第二,更致命的是账单!大模型缓存是按“前缀一字不差”来打折的(命中了便宜 90%)。你自作聪明把中间某一条记录删了,后面的缓存全部失效,全得按最贵的原价重新写入一遍,省了小钱却赔了大钱! 不过我亲自实测了 JEV 的这个策略,发现确实有个致命的硬伤: Agent 跑了条命令报错失败,Jev 判定‘这行报错没用’,随手给删了。结果几轮之后,Agent 彻底失忆,根本不知道自己刚才试错踩过坑,转头又傻乎乎去跑同一行的错误命令…… 但换个角度看,Jev 的价值根本不仅限于压缩上下文....JEV给未来的 Agent Memory打开了一条很有想象力的路,估计很快就有高手想出来了🫡
This post quotes another post: “Open-source plugin uses Jev scoring to clean Claude Code context”