Hands-on testing maps Jev's limits and pitfalls
After several days of heavy use, the author finds Jev has weak Chinese accuracy, no reasoning, a 1/20 result on long-horizon Browser Use tasks, zero hallucination that does not mean correct judgment, and no support for dynamic-parameter tool calls, making it fit only for closed tasks with clear boundaries.
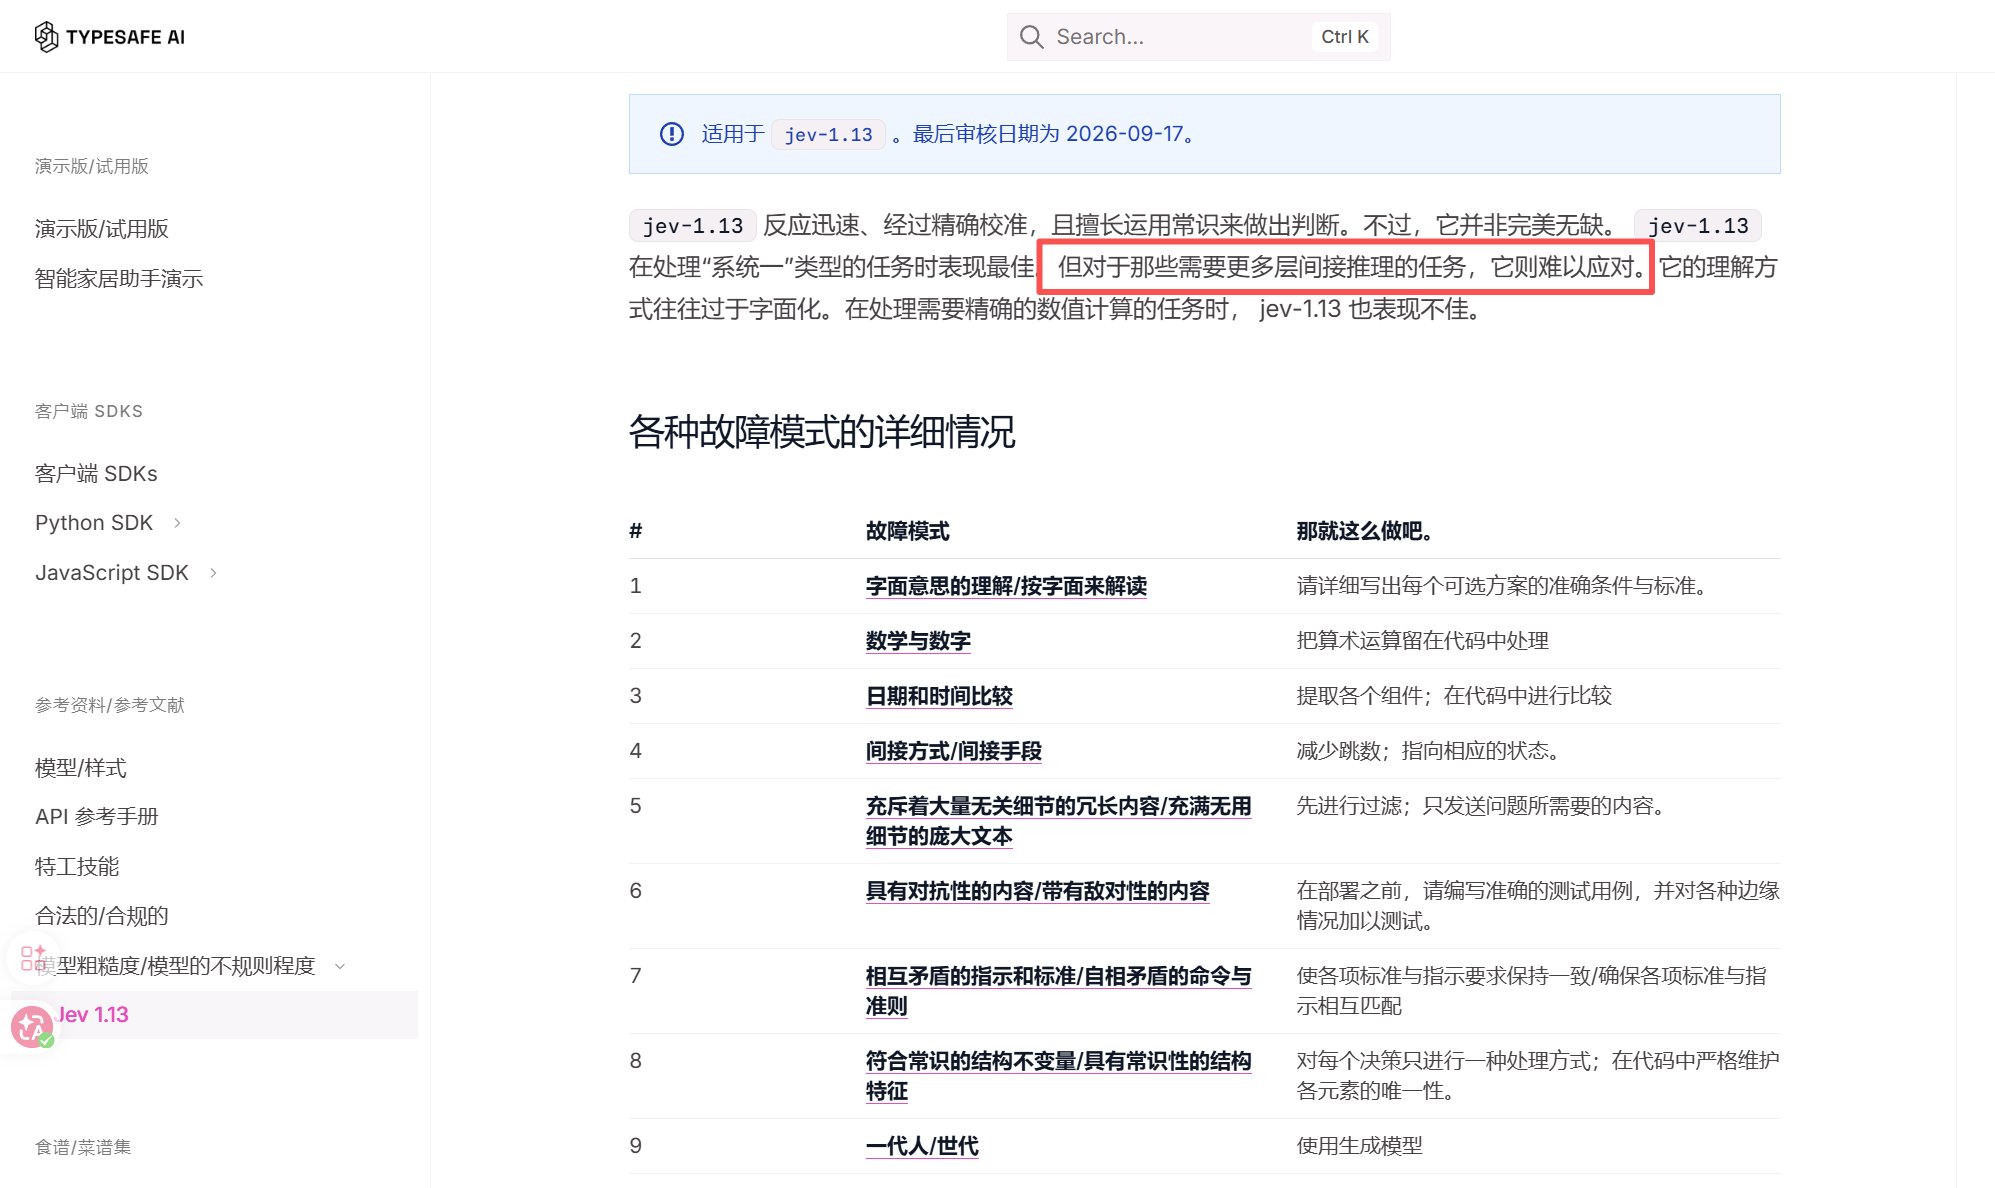
高频使用了几天JEV,慢慢摸到了它的能力边界 几天高频实测下来,我最大的感受是:Jev 是一个极其依赖使用者的工具。它能发挥多大价值,完全取决于你给它定的约束有多严格,把复杂的开放任务交给它是行不通的 --Jev 的中文适配能力较差。官方文档明确标注 CJK(中日韩)准确率偏低。英文短文本表现相对稳定。我实测过,JEV中文的准确率简直就是在乱来...... --Jev 没有推理能力。典型的例子是 Browser Use 创始人 @gregpr07 实测的长程浏览器交互,Jev 最终测试结果为 1/20,落后于具备推理能力的 Luna(17/20)。浏览器操作涉及状态空间搜索与路径回溯,Jev 不具备多步状态推演能力 --Jev 无法应付真实复杂的非沙盒网页。X上公开展示的流畅演示,多运行在结构规范、无干扰的封闭沙盒中,包括我自己的邮件分发演示,主要用于直观展示其执行速度。面对真实网页中未清洗的 DOM、异步加载与突发弹窗,JEV缺乏应对能力 --Jev 的“零幻觉”并不代表判断正确。官方文档说明其仅保证输出符合预定义的 JSON Schema 数据类型,CEO 亦确认模型存在自信选错的情况.. --Jev 无法胜任动态参数的工具调用。在实际 Agent 工具调用通常需要动态生成参数(例如指定代码修改行号、生成代码片段或自定义检索词),此类无限维的参数空间JEV的能力无法覆盖 --Jev 高度依赖清晰的边界限制。在规则复杂的任务下,低延迟与低成本是事实,但前提是必须建立在定义明确的封闭边界上,否则输出的大多是错误决策 --Jev 无法输出推理依据。它仅返回最终的选项或数值,不包含思考过程(CoT)。在需要解释决策原因、人工复核或合规审计的场景中,无法提供追溯依据 总结来说,Jev 的适用场景非常细分,而且高度取决于开发者如何去定义它的运行环境,所以我觉得非常需要高手们开发一个Jev harness....
This post quotes another post: “Jev vs DeepSeek: routing 300 emails to 15 departments”