Using Jev for context compaction in AI coding
The author describes fast-jev-compaction, which uses Jev to quickly decide which tool calls and results in an AI coding history can be dropped rather than summarizing, keeping key constraints and error evidence verbatim and cutting 156k tokens to 62k in a demo.
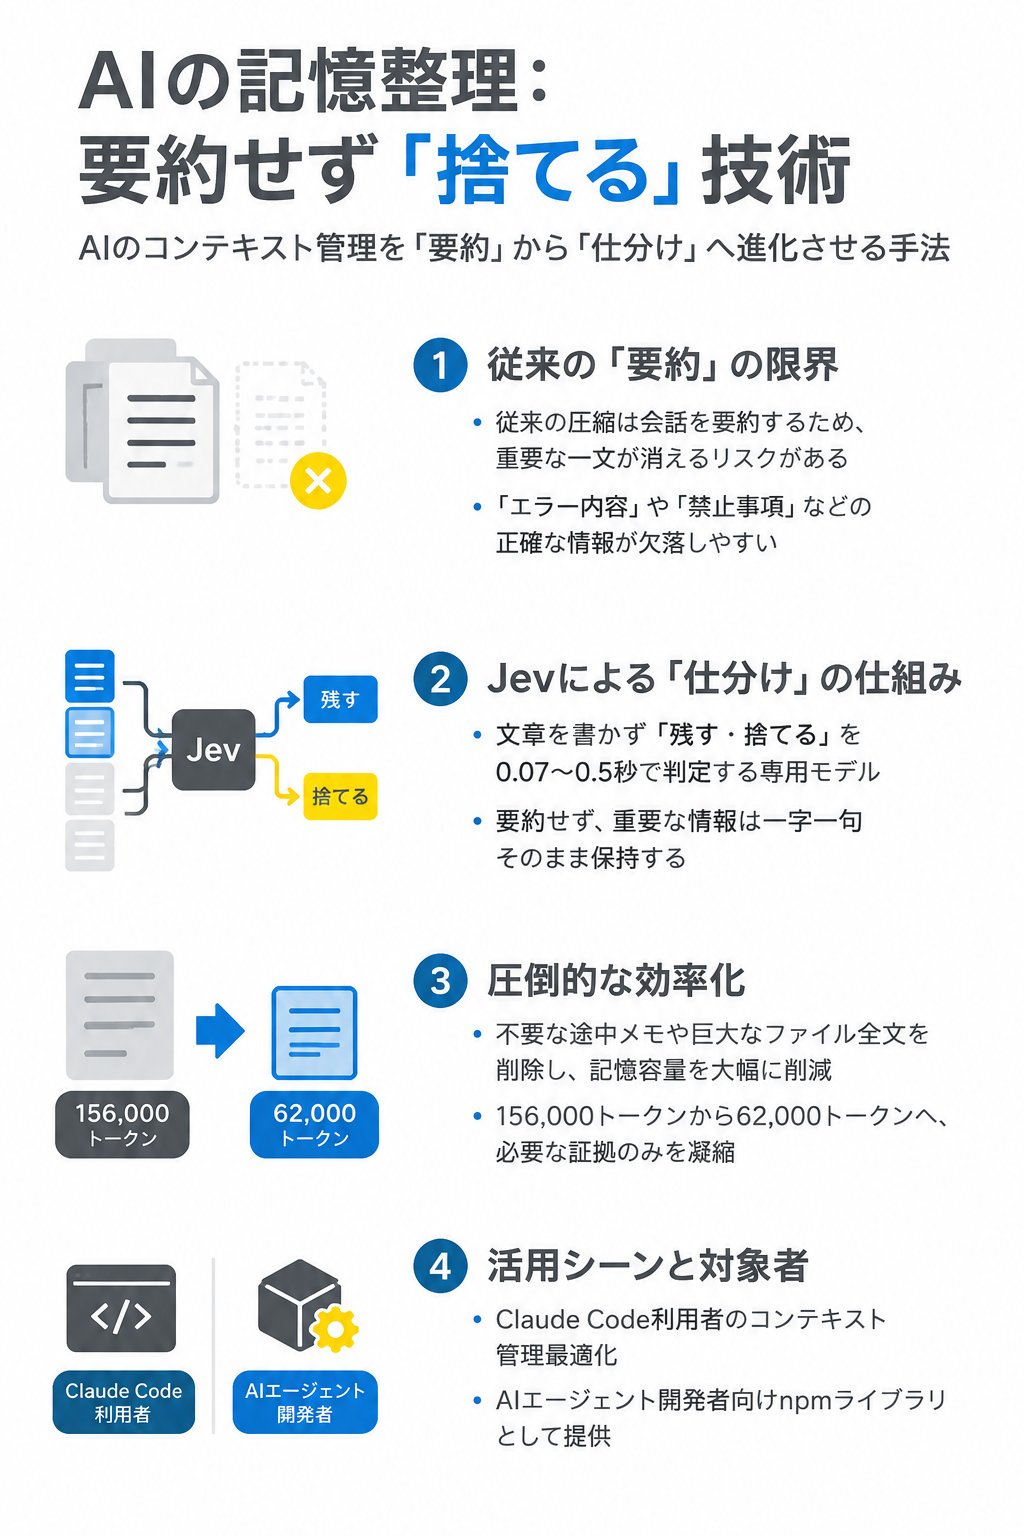
📝このJevのユースケース素晴らしくて、AIコーディングの「記憶の整理」、この発想はかなり面白い しかもGitHubにも公開されているから誰でも試せる! Claude CodeやCodexのようなAIは、長時間作業するとファイルを読んだ履歴、テスト結果、エラー、修正内容がどんどんコンテキストに積み上がっていく。当然いつか限界が来る。これまで一般的だったのは、古い会話をAIに「要約」させて小さくする方法だった。人間でいえば、3時間の会議が長くなりすぎたので「ここまでの議事録をA4一枚にまとめて」と頼むようなもの ただ、要約には弱点がある。「このフォルダは絶対触るな」「expected 1200, received 120」「原因はこのファイルの41行目」。こういう後から必要になる正確な一文まで、要約の過程で丸められてしまう可能性がある そこでTypeSafe AIのJevを使った「fast-jev-compaction」という発想が出てきた。やっていることは要約ではない。AIの作業履歴を見ながら「これはまだ必要か?」を高速に判定して、不要になったツール実行や結果だけを捨てる。残すと判断した情報は書き換えず、そのまま残す デモでは156,000トークンあったコンテキストが62,000トークンまで減っている。それでも「APIは変えるな」という制約や「expected 1200, received 120」という失敗の証拠は残っている。逆に、途中で読んだ巨大なファイルや、役目を終えた調査結果は消えていく。これは会議の議事録を要約するというより、机の上に積み上がった100枚の資料から「もう使わない紙だけ捨てる」に近い しかもJevはChatGPTのように文章を書くAIではない。あらかじめ決めた選択肢について高速に判断することに特化したTypeSafe AIの「System One Model」なので、大量の履歴に対してKEEPかDROPかを判断するような処理と相性がいい AIエージェントが長時間働くようになるほど、「何を覚えさせるか」以上に「何を忘れさせるか」が重要になる。AIのコンテキスト管理は、すべてを要約して作り直す時代から「必要な記憶を原文のまま選別する」時代に入っていくのかもしれない https://x.com/tamarajtran/status/2100694549362553153?s=20
This post quotes another post: x.com/tamarajtran/status/2100694549362553153