Which metric actually matters when comparing LLMs like DeepSeek V4.1
The author argues token prices, benchmark scores and speed don't capture the real cost of a verified working deliverable, using a bridge-steel analogy and calling for cost-per-verified-task comparisons.
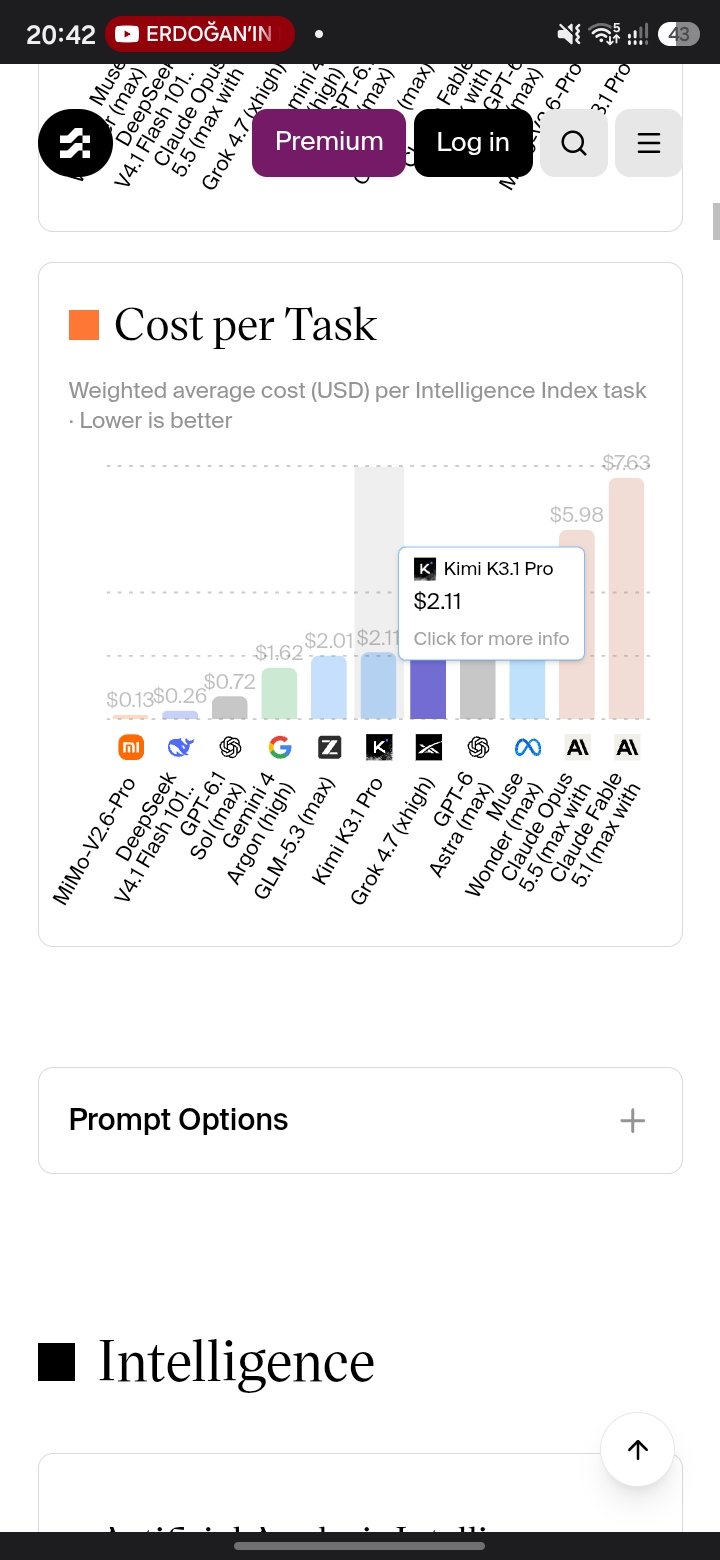
LLM modellerini karşılaştırırken yanlış metriğe bakıyor olabilir miyiz? Son dönemde Terra 6.1, DeepSeek v4.1, Luna 6, Sol 6.1 ve Sonnet 5.5 gibi modelleri performans ve maliyet açısından karşılaştırıyorum. Genellikle ilk baktığımız şeyler şunlar: • Input token fiyatı • Output token fiyatı • Cached token fiyatı • Benchmark skorları • Modelin hızı Bunların hepsi önemli. Ama bence asıl soruyu cevaplamıyorlar: Bir LLM'nin bize çalışan, güvenilir ve doğrulanmış bir işi teslim etmesinin gerçek maliyeti nedir? Şöyle düşünelim. İki farklı LLM'ye aynı yazılım görevini verdik. Model A, görevi 1.000 satır kod yazarak tamamladı. Model B ise aynı görevi 300 satır kodla tamamladı. İlk bakışta Model B daha verimli görünüyor, değil mi? Ama burada önemli bir problem var. Model B gerçekten daha iyi bir mimari kurmuş, gereksiz tekrarları ortadan kaldırmış ve daha temiz bir çözüm üretmiş olabilir. Ya da tam tersine; hata yönetimini, güvenlik kontrollerini, testleri ve nadir karşılaşılan durumları (edge case) atlamış olabilir. Model A'nın 1.000 satırı da daha sağlam bir çözümün sonucu olabileceği gibi gereksiz karmaşıklıktan kaynaklanıyor olabilir. Yani kod satırı sayısı tek başına ne kaliteyi ne de verimliliği gösterir. Bunu iki mühendisin aynı köprüyü tasarlamasına benzetiyorum. Bir mühendis diğerinden çok daha az çelik kullanarak köprüyü tamamlıyor. Hangisi daha iyi mühendis? Bunu sadece kullanılan çelik miktarına bakarak söyleyemeyiz. Köprünün yük testlerinden geçmesi, güvenlik katsayısı, dayanıklılığı ve uzun vadeli bakım maliyeti de önemli. LLM'lerde de durum aynı. Üstelik daha az kod yazan bir model, o sonuca ulaşmak için daha fazla düşünme tokenı, araç çağrısı veya yeniden deneme kullanmış olabilir. Şimdi maliyet tarafına bakalım. Tamamen varsayımsal bir örnek: Model A - Görev başına deneme maliyeti: $0,05 - Başarılı sonuç için gereken deneme: 4 - Toplam maliyet: $0,20 Model B - Görev başına deneme maliyeti: $0,15 - Başarılı sonuç için gereken deneme: 1 - Toplam maliyet: $0,15 İlk bakışta Model A üç kat daha ucuz görünüyordu. Ama işi bitirdiğimizde Model B hem daha ekonomik hem de daha hızlı olabilir. Bir de insanın hataları düzeltmek için harcadığı zamanı hesaba katarsak fark daha da büyüyebilir. Dolayısıyla gerçek maliyet hesabına şunları dahil etmemiz gerekiyor: 1. Input, output ve cached token maliyetleri 2. Thinking/reasoning token tüketimi 3. Araç çağrıları ve ek işlemler 4. Yeniden denemeler 5. Görevin tamamlanma süresi 6. Testlerden geçme oranı 7. Kaçırılan edge case'ler 8. İnsan müdahalesi ve düzeltme süresi 9. Üretilen kodun bakım maliyeti Burada benchmark karşılaştırmalarının da doğru yapılması gerekiyor. Modelleri aynı benchmark üzerinde, mümkün olduğunca aynı araçlarla, aynı görev koşullarında ve aynı başarı kriterleriyle değerlendirmeliyiz. Üstelik yüksek bir benchmark skoru, her zaman en düşük gerçek görev maliyeti anlamına gelmiyor. Bence LLM karşılaştırmalarında fiyat/performansın yanında ayrı bir metrik daha öne çıkmalı: Cost per Verified Successful Task Yani: Doğrulanmış başarılı görev başına toplam maliyet. Çünkü sonuçta token satın almak istemiyoruz. Çalışan, doğru, güvenilir ve sürdürülebilir çözümler üretmek istiyoruz. En ucuz tokenı sunan model, en ucuz işi çıkaran model olmayabilir. Bazen daha pahalı model, toplamda çok daha ekonomik bir mühendis gibi çalışabilir. Sizce LLM benchmarklarında görev başına gerçek maliyet yeterince ölçülüyor mu?