gpt-6IMAGE
ValsAI benchmark tests cost of reasoning levels in GPT-6 Astra and Opus 5.5
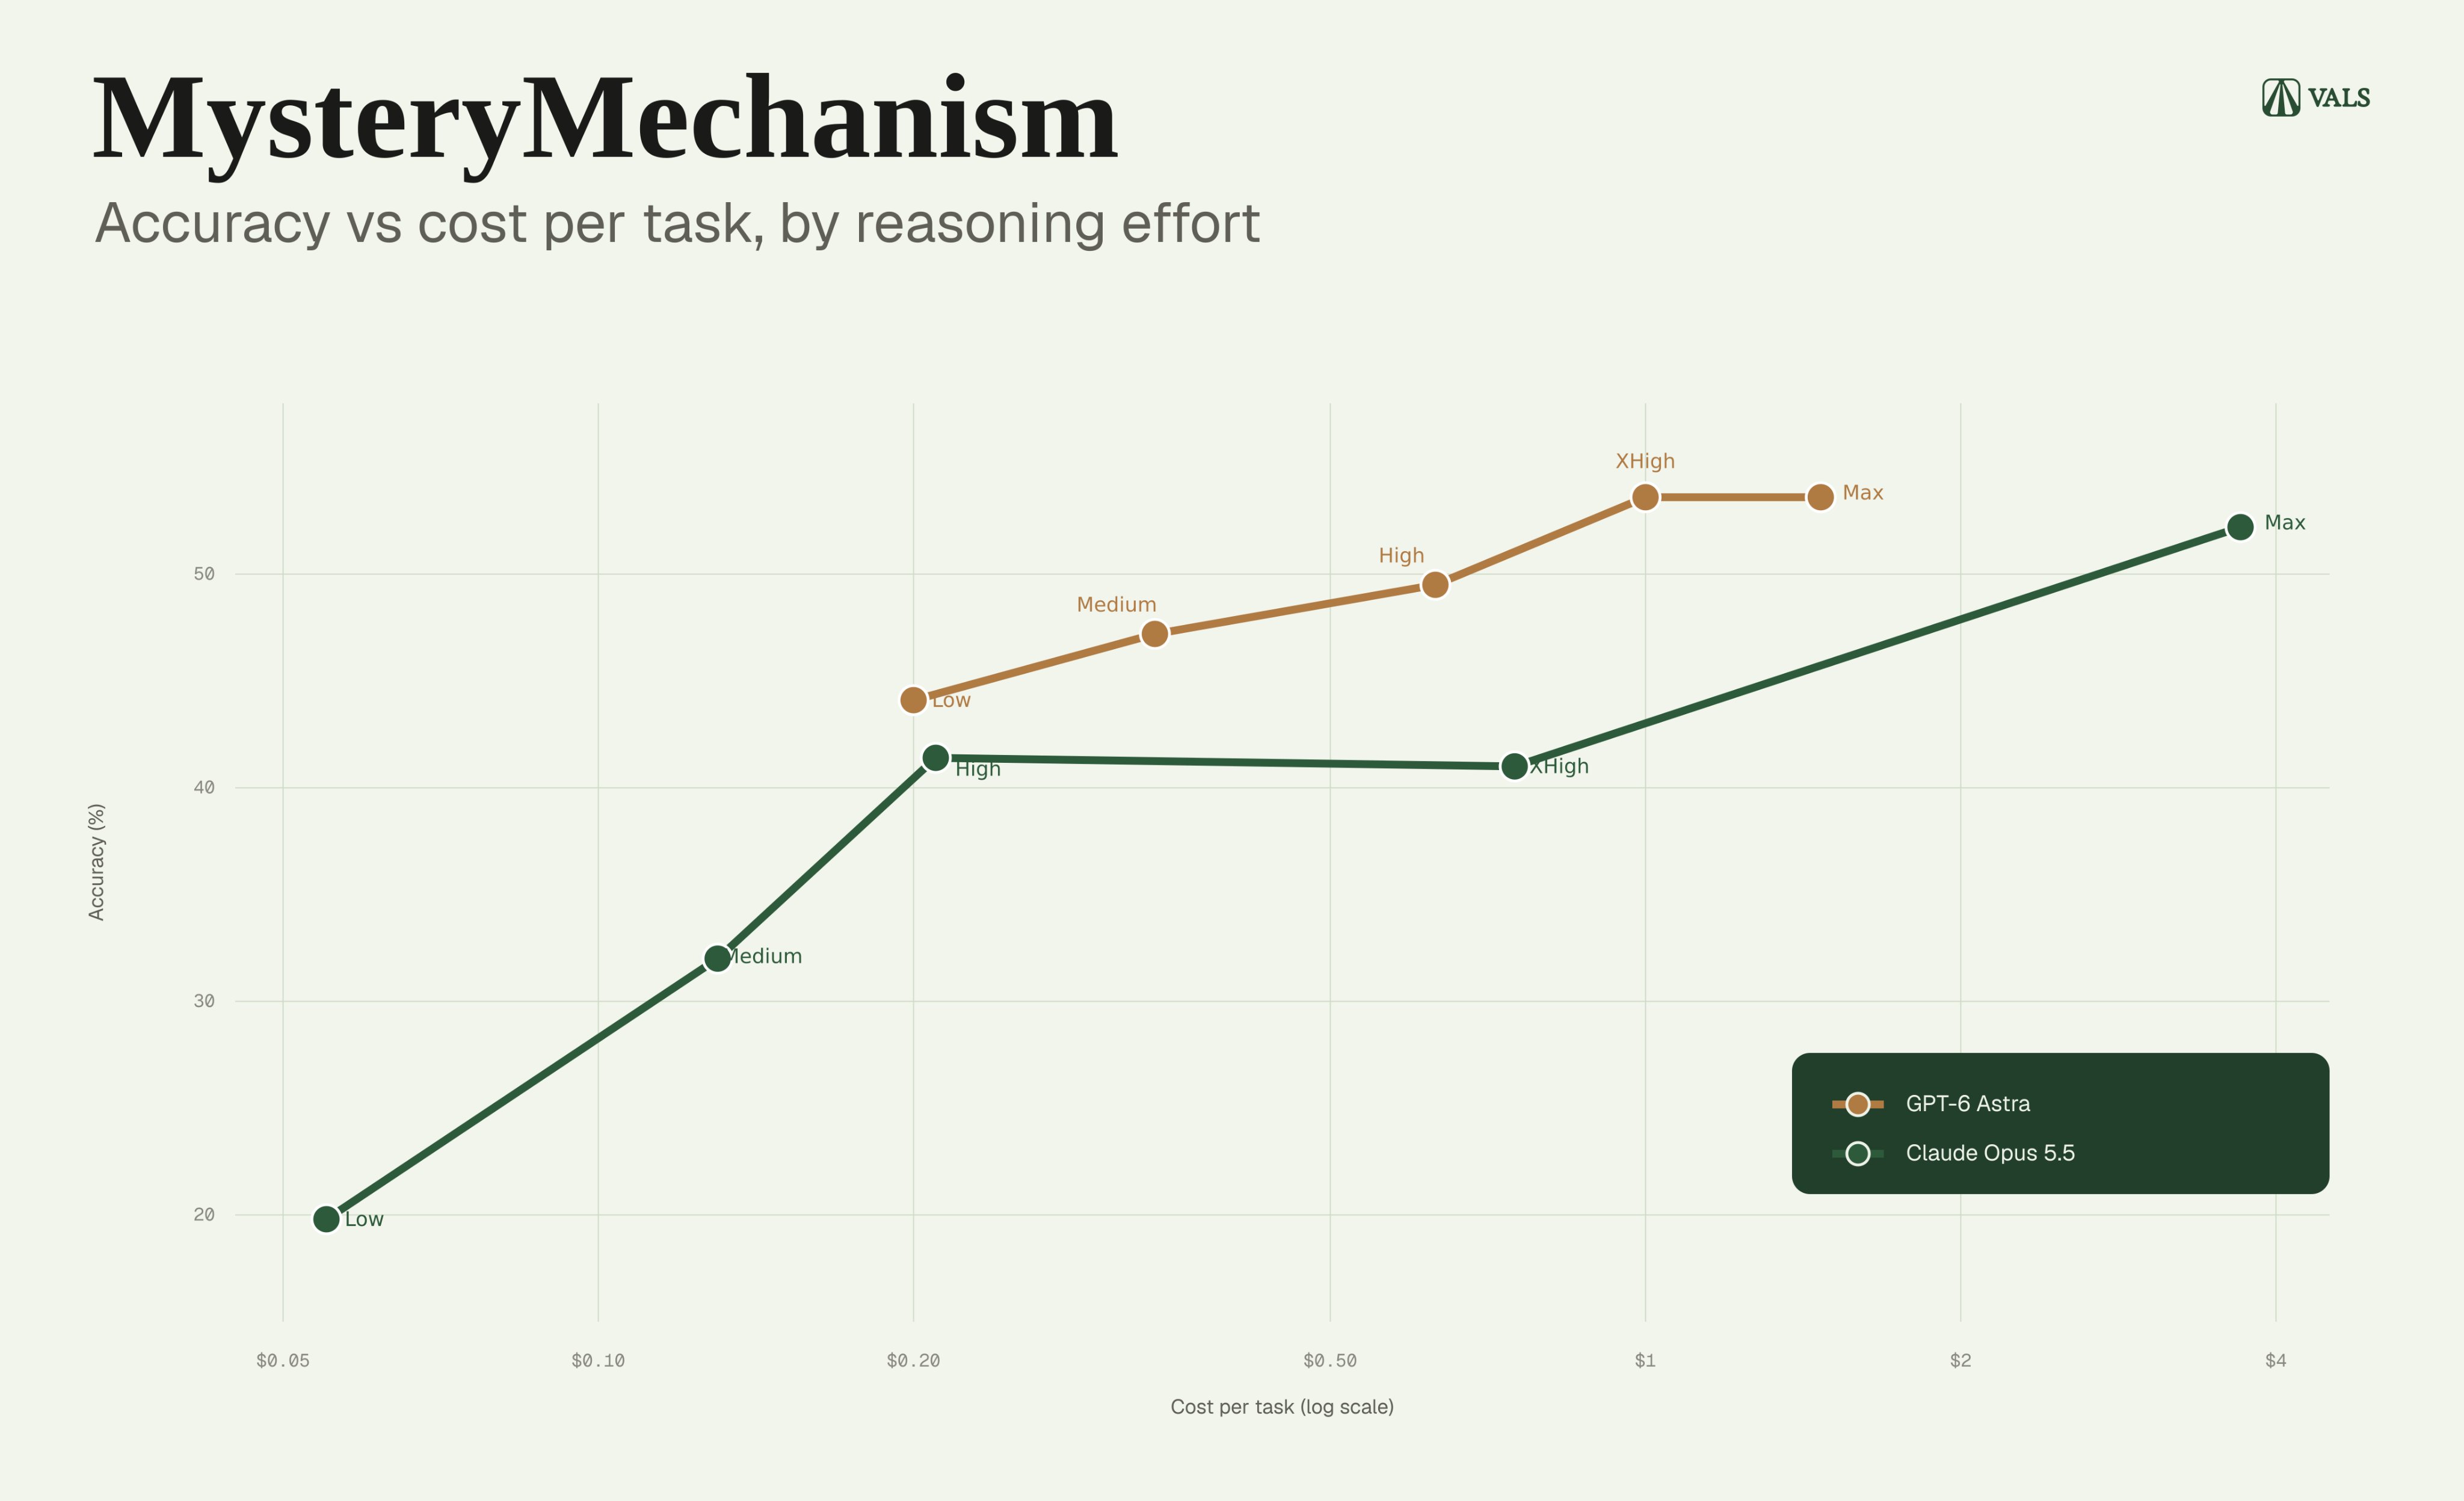
ValsAI ran GPT-6 Astra and Opus 5.5 at every reasoning level on its MysteryMechanism benchmark, finding longer thinking improves accuracy but can cost up to 20x more.
Vals AI
@ValsAIArchived 2026.09.29Originally posted 2026.09.29
Vals AI @ValsAIOriginally posted 2026.09.29
When does more reasoning stop being useful and start becoming overhead? We ran Open AI and Anthropic’s best models: GPT-6 Astra and Claude Opus 5.5 at every reasoning level on our new benchmark, MysteryMechanism. Thinking longer delivers accuracy gains with the same model at as much as 20x the cost. Inspecting traces, the models use their effort level in very different ways.
x.com/valsai/status/2104671432517316959Archived 2026.09.29 10:14