DeepSeek V4.1 Flash 1017 GSQ-RCO GGUF model card and Strata run docs
Links to the ISTA-DASLab DeepSeek-V4.1-Flash-1017 GSQ-RCO GGUF model card with per-tensor allocation table, Strata's run docs, and the GSQ and RCO papers.
模型卡和每个张量的分配表: https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF Strata 跑 DeepSeek 的文档和实测: https://github.com/Niko1221/Strata/blob/main/docs/DEEPSEEK41.md GSQ 论文:https://arxiv.org/abs/2604.18556 RCO 论文:https://arxiv.org/abs/2605.00649
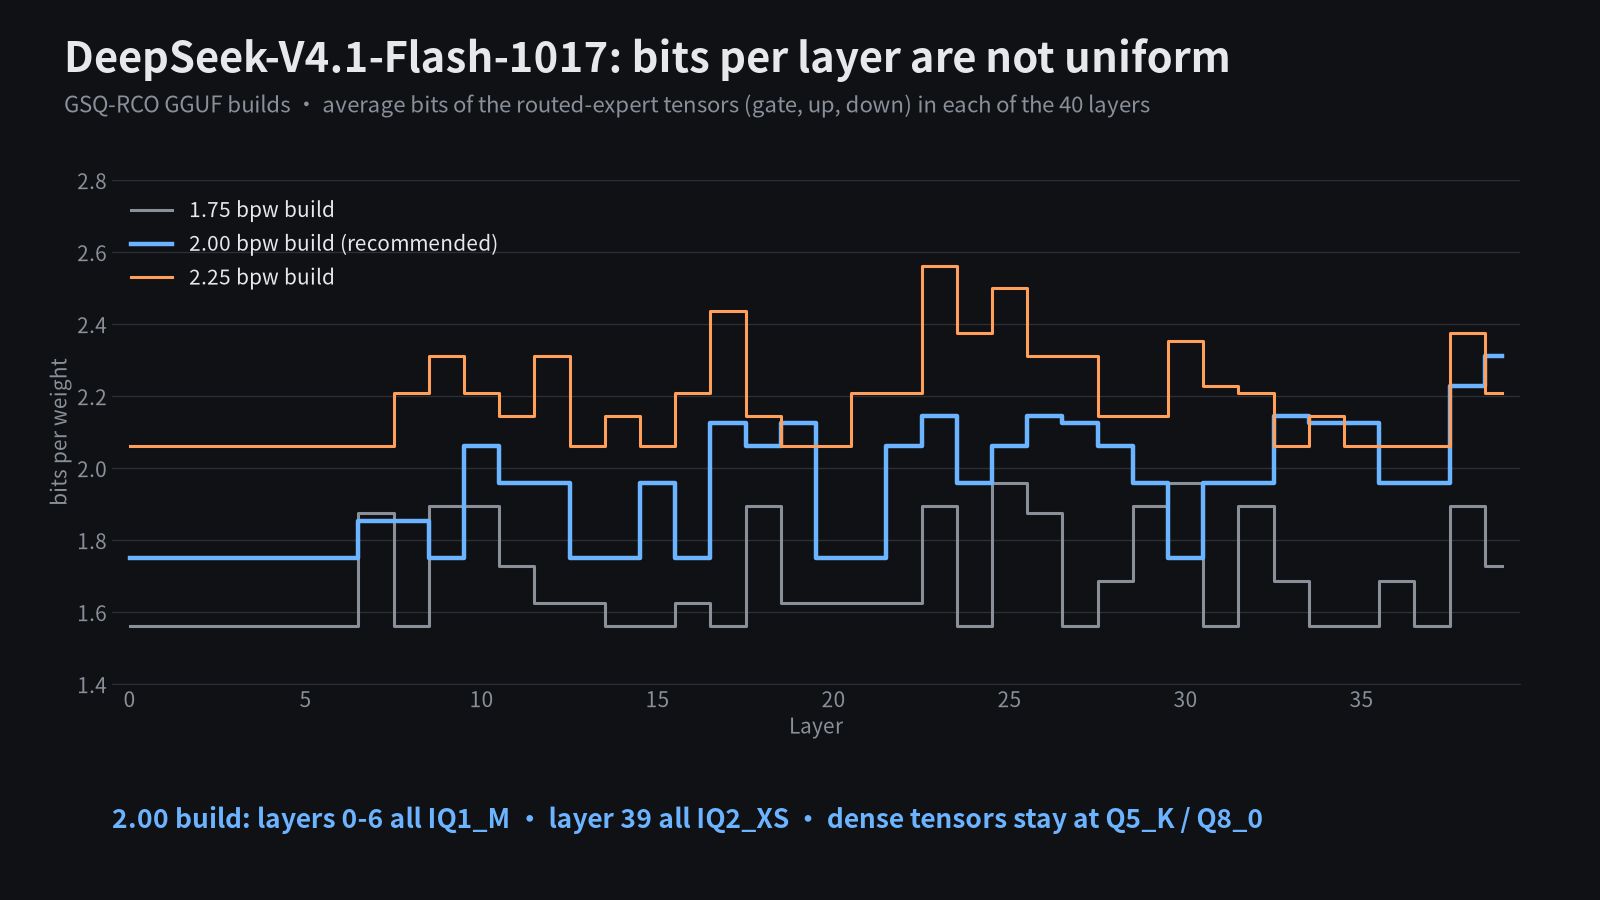
763B 的 DeepSeek-V4.1-Flash-1017,现在一张 12GB 显卡就能跑起来。靠的是两件事:每个张量单独挑位宽,再把模型拆到显存、内存、SSD 三层。 12GB 只是显存的门槛。实际还要 46 到 64GB 内存、257GB 硬盘,RTX 5070 上回答速度大约 4.7 tok/s。 先说直觉。 普通的 2 bit 量化是一刀切,所有张量压到同一个位宽。GSQ-RCO 先定一个总预算,比如平均 2.00 bpw,再让搜索决定每个张量分多少。 对误差敏感的多给,不敏感的少给,总大小正好卡在预算上。 2.00 版的分配表是公开的。40 层路由专家,每层 gate、up、down 三块,一共 120 个张量,位宽差得很开: 1. 60 个 IQ1_M,42 个 IQ2_XXS,18 个 IQ2_XS 2. 第 0 到 6 层的专家全是最低的 IQ1_M 3. 第 39 层三块都是 IQ2_XS,全表最高 4. 注意力、共享专家、embedding 这些稠密部分另走一套,只在 Q5_K、Q6_K、Q8_0 里挑 路由专家占了绝大部分参数,每层 384 个,每个 token 只用 6 个,压它最省空间。稠密部分每个 token 都要过,所以位宽高得多。 再说机制,分两步。 GSQ 管一个张量内部怎么量化。2 bit 只有 4 个格点,-2、-1、0、1 乘一个缩放系数,每个权重要选一个。 GSQ 先用 GPTQ 起步,再给每个权重在这几个格点上配一组可学习的概率,用 Gumbel-Softmax 把选格点变成能求梯度的问题。训练中逐渐降温,到结束时每个权重收成一个确定的值。 结果还是普通的标量格式,GGUF 直接能装。论文里 Llama-3.1-70B 压到 2.13 bpp,零样本平均 75.57,GPTQ 是 57.38,向量量化的 QTIP 是 77.25。 RCO 管每个张量分到哪种类型。1008 个张量各选一种,模型误差没法按张量拆开算,只能看整体。 RCO 把类型选择也变成概率。预算约束在这个空间里是一个光滑的曲面,每一步梯度更新完再拉回曲面上,全程预算都精确满足,也不用调惩罚系数。 然后是三层存储,Strata 按冷热把模型拆开放: 1. 显卡放稠密层和最常用的那批专家 2. 内存放其余专家,由 CPU 来算 3. Engram 查找表 110.6GB 放 SSD,每个 token 只读几行 2.00 版骨干 138.24GB,比 64GB 内存大,放不下的专家要在回答时从 SSD 读,所以慢。几台机器的实测速度差了十几倍: 1. RTX 5070 12GB,64GB 内存,3.6 GB/s 的 NVMe:约 4.7 tok/s,读 prompt 121 到 231 tok/s 2. RTX 3060 12GB,46GB 内存:8 到 10 tok/s 3. 4 张 Radeon AI PRO R9700:2.00 版约 48 tok/s,2.25 版约 80 质量这块要分开看。 官方模型卡上,2.00 版的 AIME25、GPQA-Diamond、LiveCodeBench v6 三项和原版完全一样,平均 93.54。 Strata 测的困惑度高了 15.5%,代码高 8.6%,agent 任务高 5.3%。1.75 版困惑度高 21%,英文散文高 53%。 AIME25 原版就是满分,三项跑分看不出压缩的损失,困惑度能看出来。 我觉得最值得学的是按张量分预算这一步,以后别的大 MoE 也能这么压。想拿 12GB 显卡写代码,先按每秒 5 个 token 来预期。