Project Maya runs DeepSeek V4.1 Flash locally on a single 4090 48G
An MIT-licensed project offloads experts across GPU, RAM, and SSD to run the 748B model on home hardware, hitting 26.4 tok/s for chat and 65 tok/s for coding on a single 4090 48G, with 1-bit quantization matching the original's token choice 87.5% of the time.
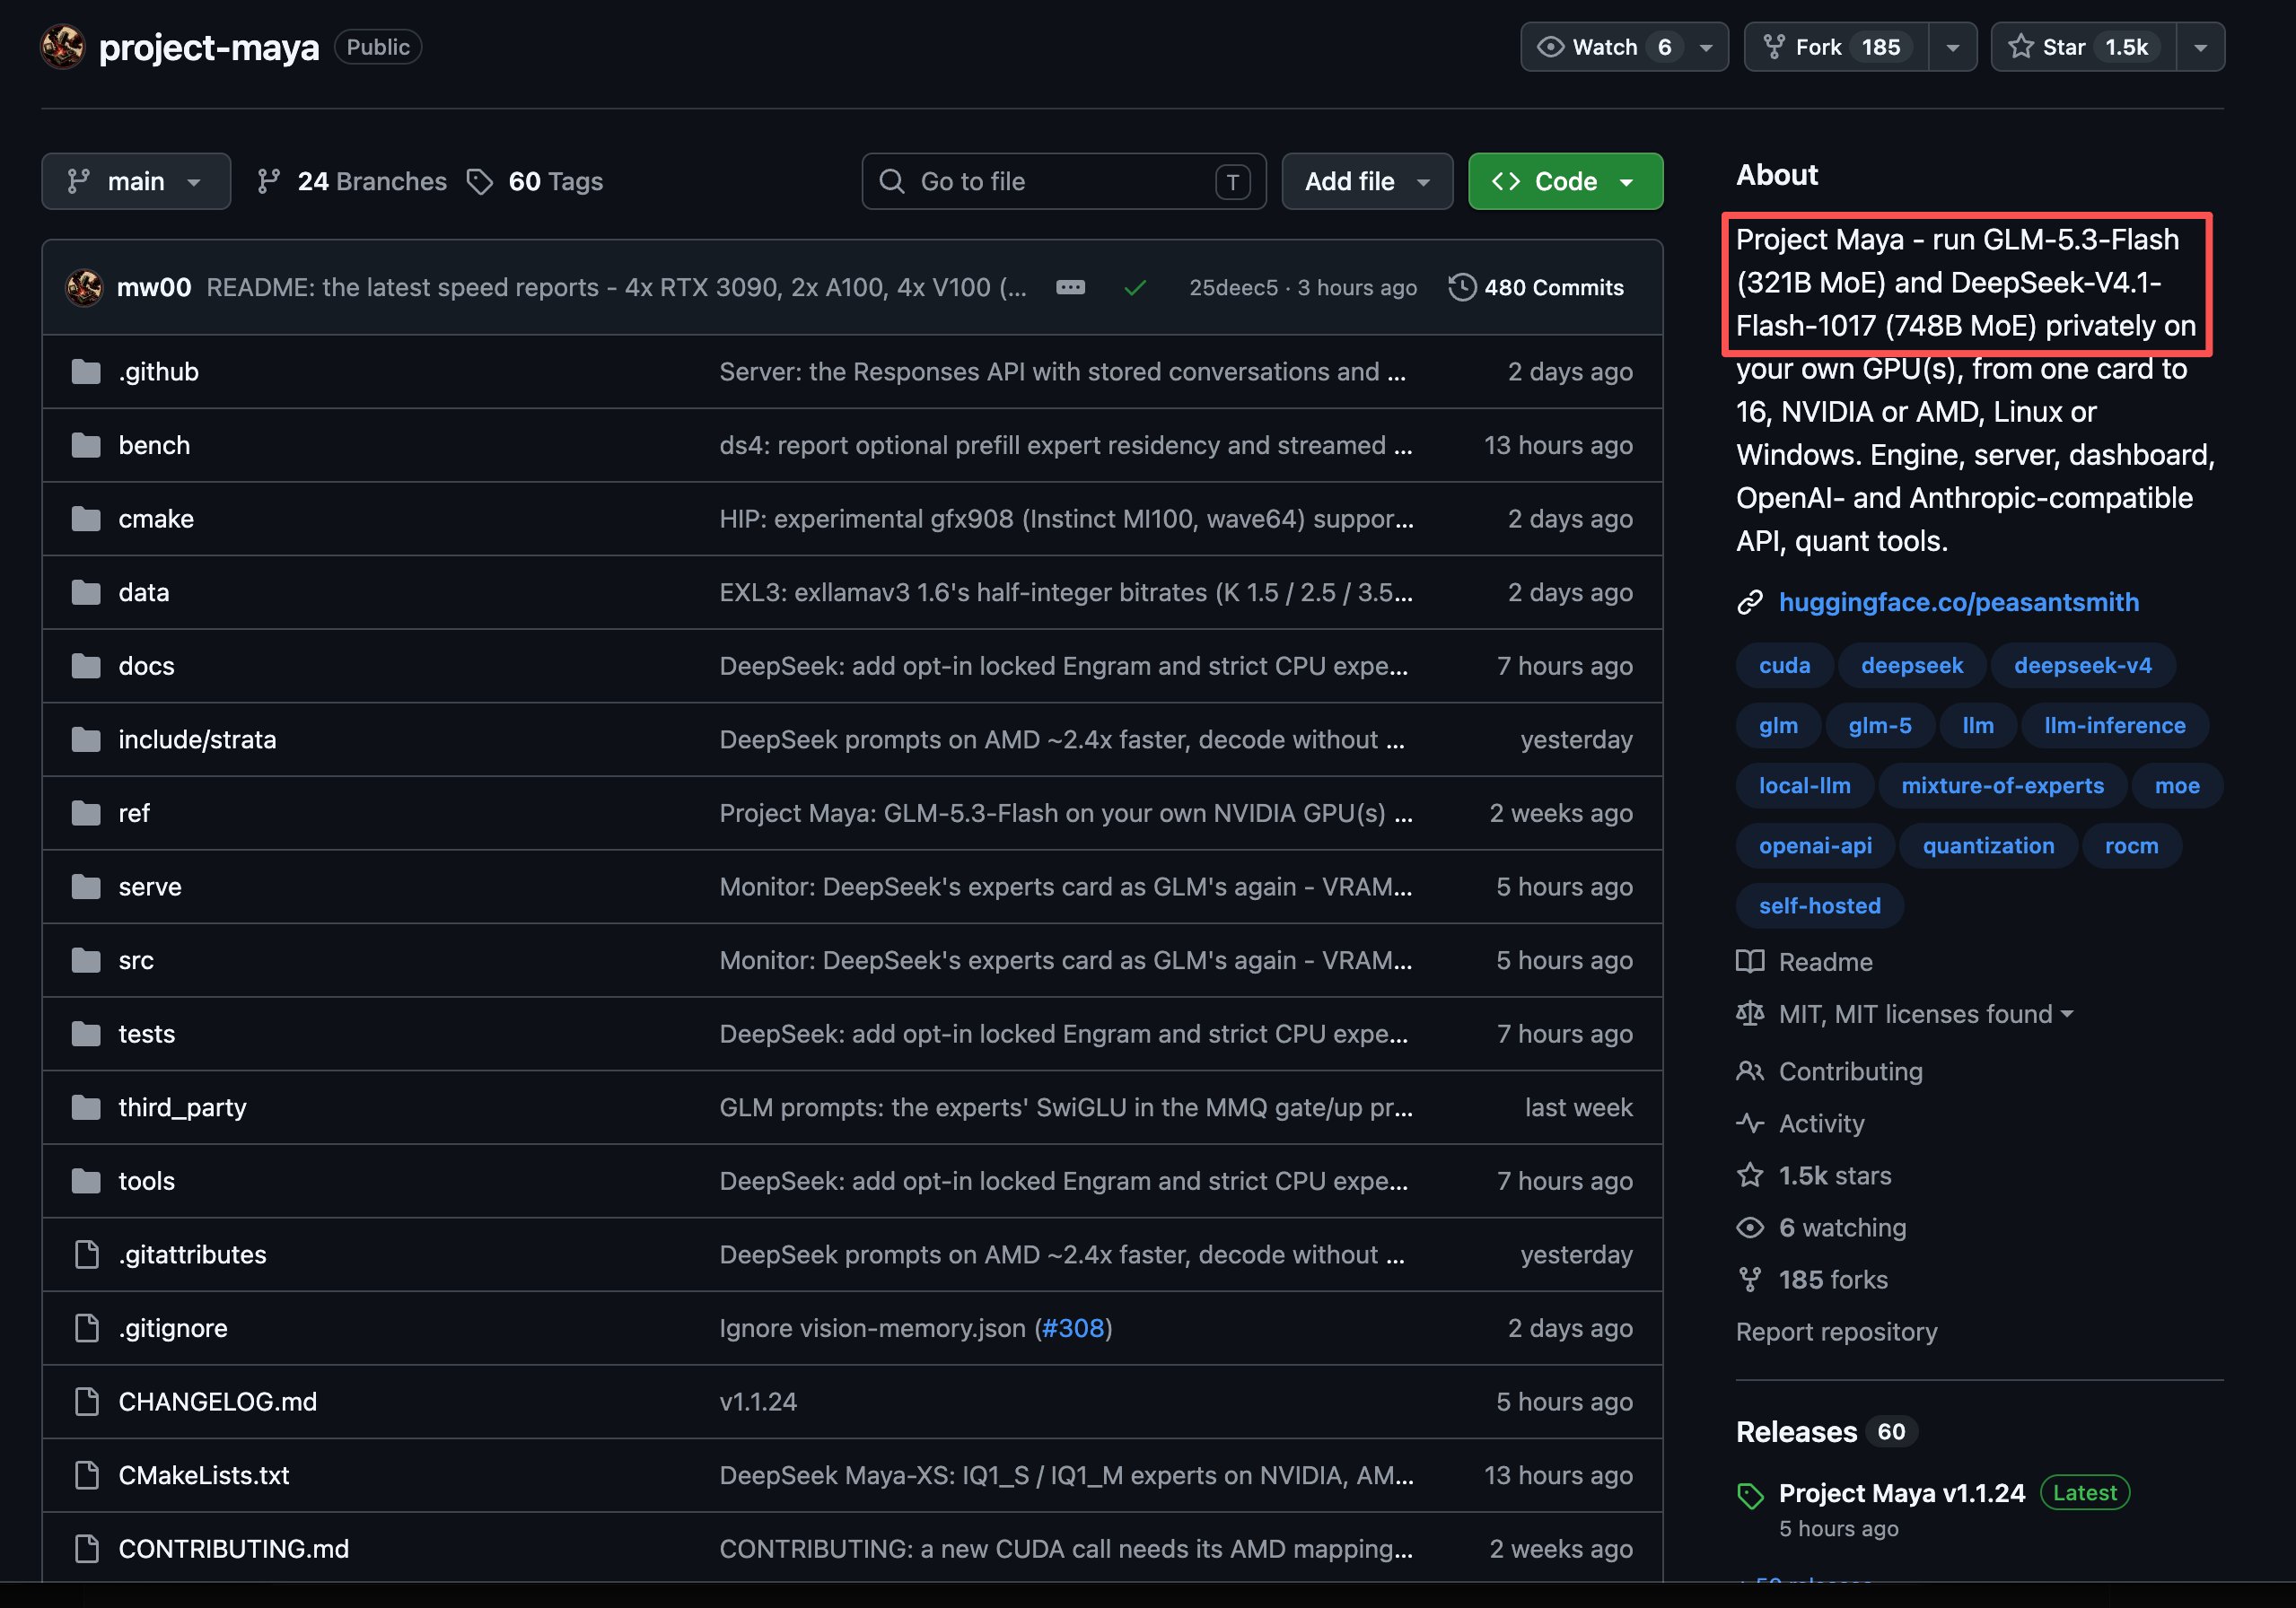
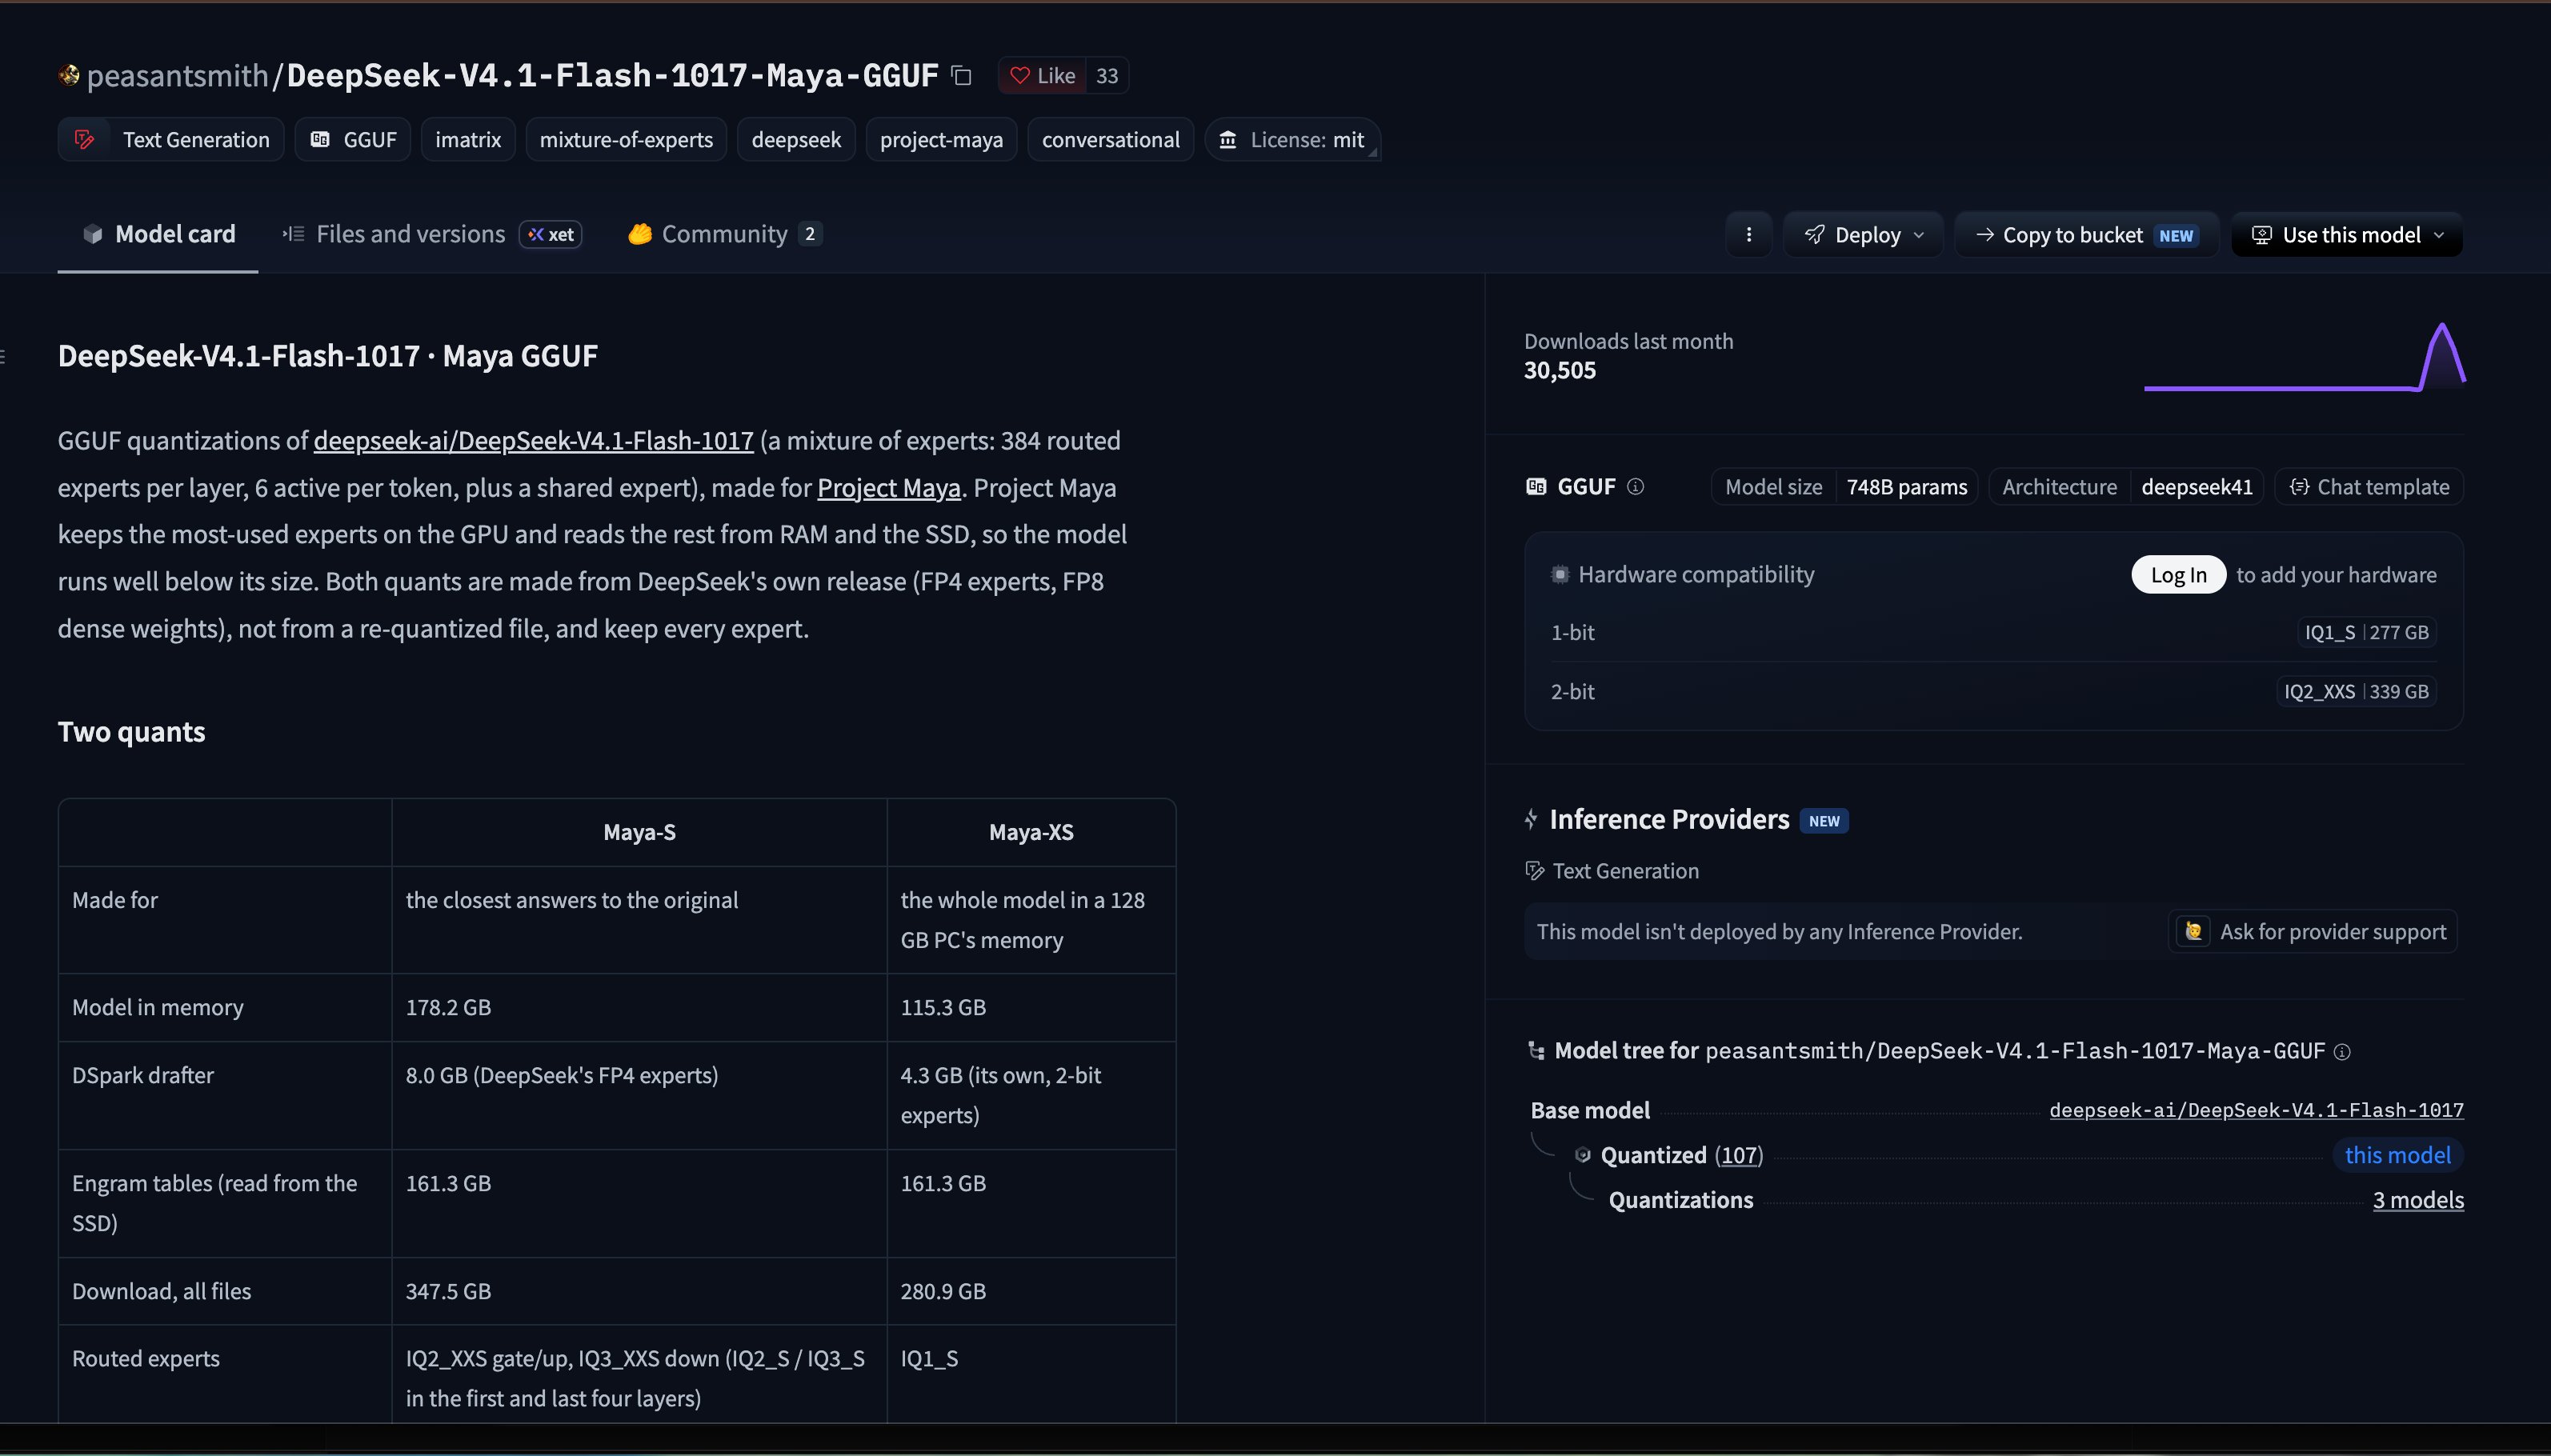
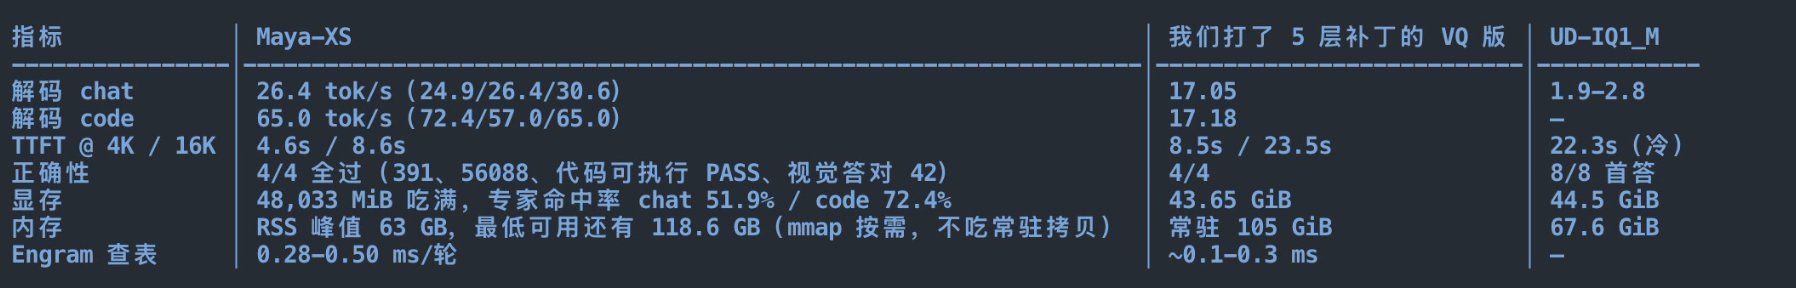
🥹 有人开源了:家用电脑跑 748B 的 DeepSeek! Project Maya,MIT 协议,免费。10-07 才建的库,已经 1500 多星,DeepSeek 量化文件下载 3 万次。 它让 DeepSeek V4.1 Flash 1017 这种平时得进机房的模型,在你家电脑上跑起来。 原理很白:常用的专家放显卡,次常用放内存,冷门的丢固态,聊天时自动搬 单张 4090 48G,日常聊天每秒 26.4 个 token,写代码 65。同一台机器换 Unsloth 1-bit,只有 2 个左右 自带网页聊天,兼容 OpenAI 和 Anthropic 接口,Claude Code 改个地址就能接本地 DeepSeek 本地跑,不按 token 付钱。 丑话说前头:这是 1-bit 量化,跟原版选同一个词的比例 87.5% Mac 不支持,显存加内存不到 115G 的也别硬上。 有N 卡的朋友,想本地跑 DeepSeek 的,先收藏。 据说 @servasyy_ai 黄总用单台 4090/48G 跑到了70+ tok/s ,只能说太牛逼了! 传送门👇 Project Maya https://github.com/mw00/project-maya DeepSeek 量化文件https://huggingface.co/peasantsmith/DeepSeek-V4.1-Flash-1017-Maya-GGUF