Pi vs DeepSeek Harness: architecture and benchmark differences
Compares Pi's minimal extensible design with DeepSeek Harness's everything-is-a-plugin approach, citing Terminal-Bench subset scores of 60.32% vs 52.38% on the same GPT-6 Astra.
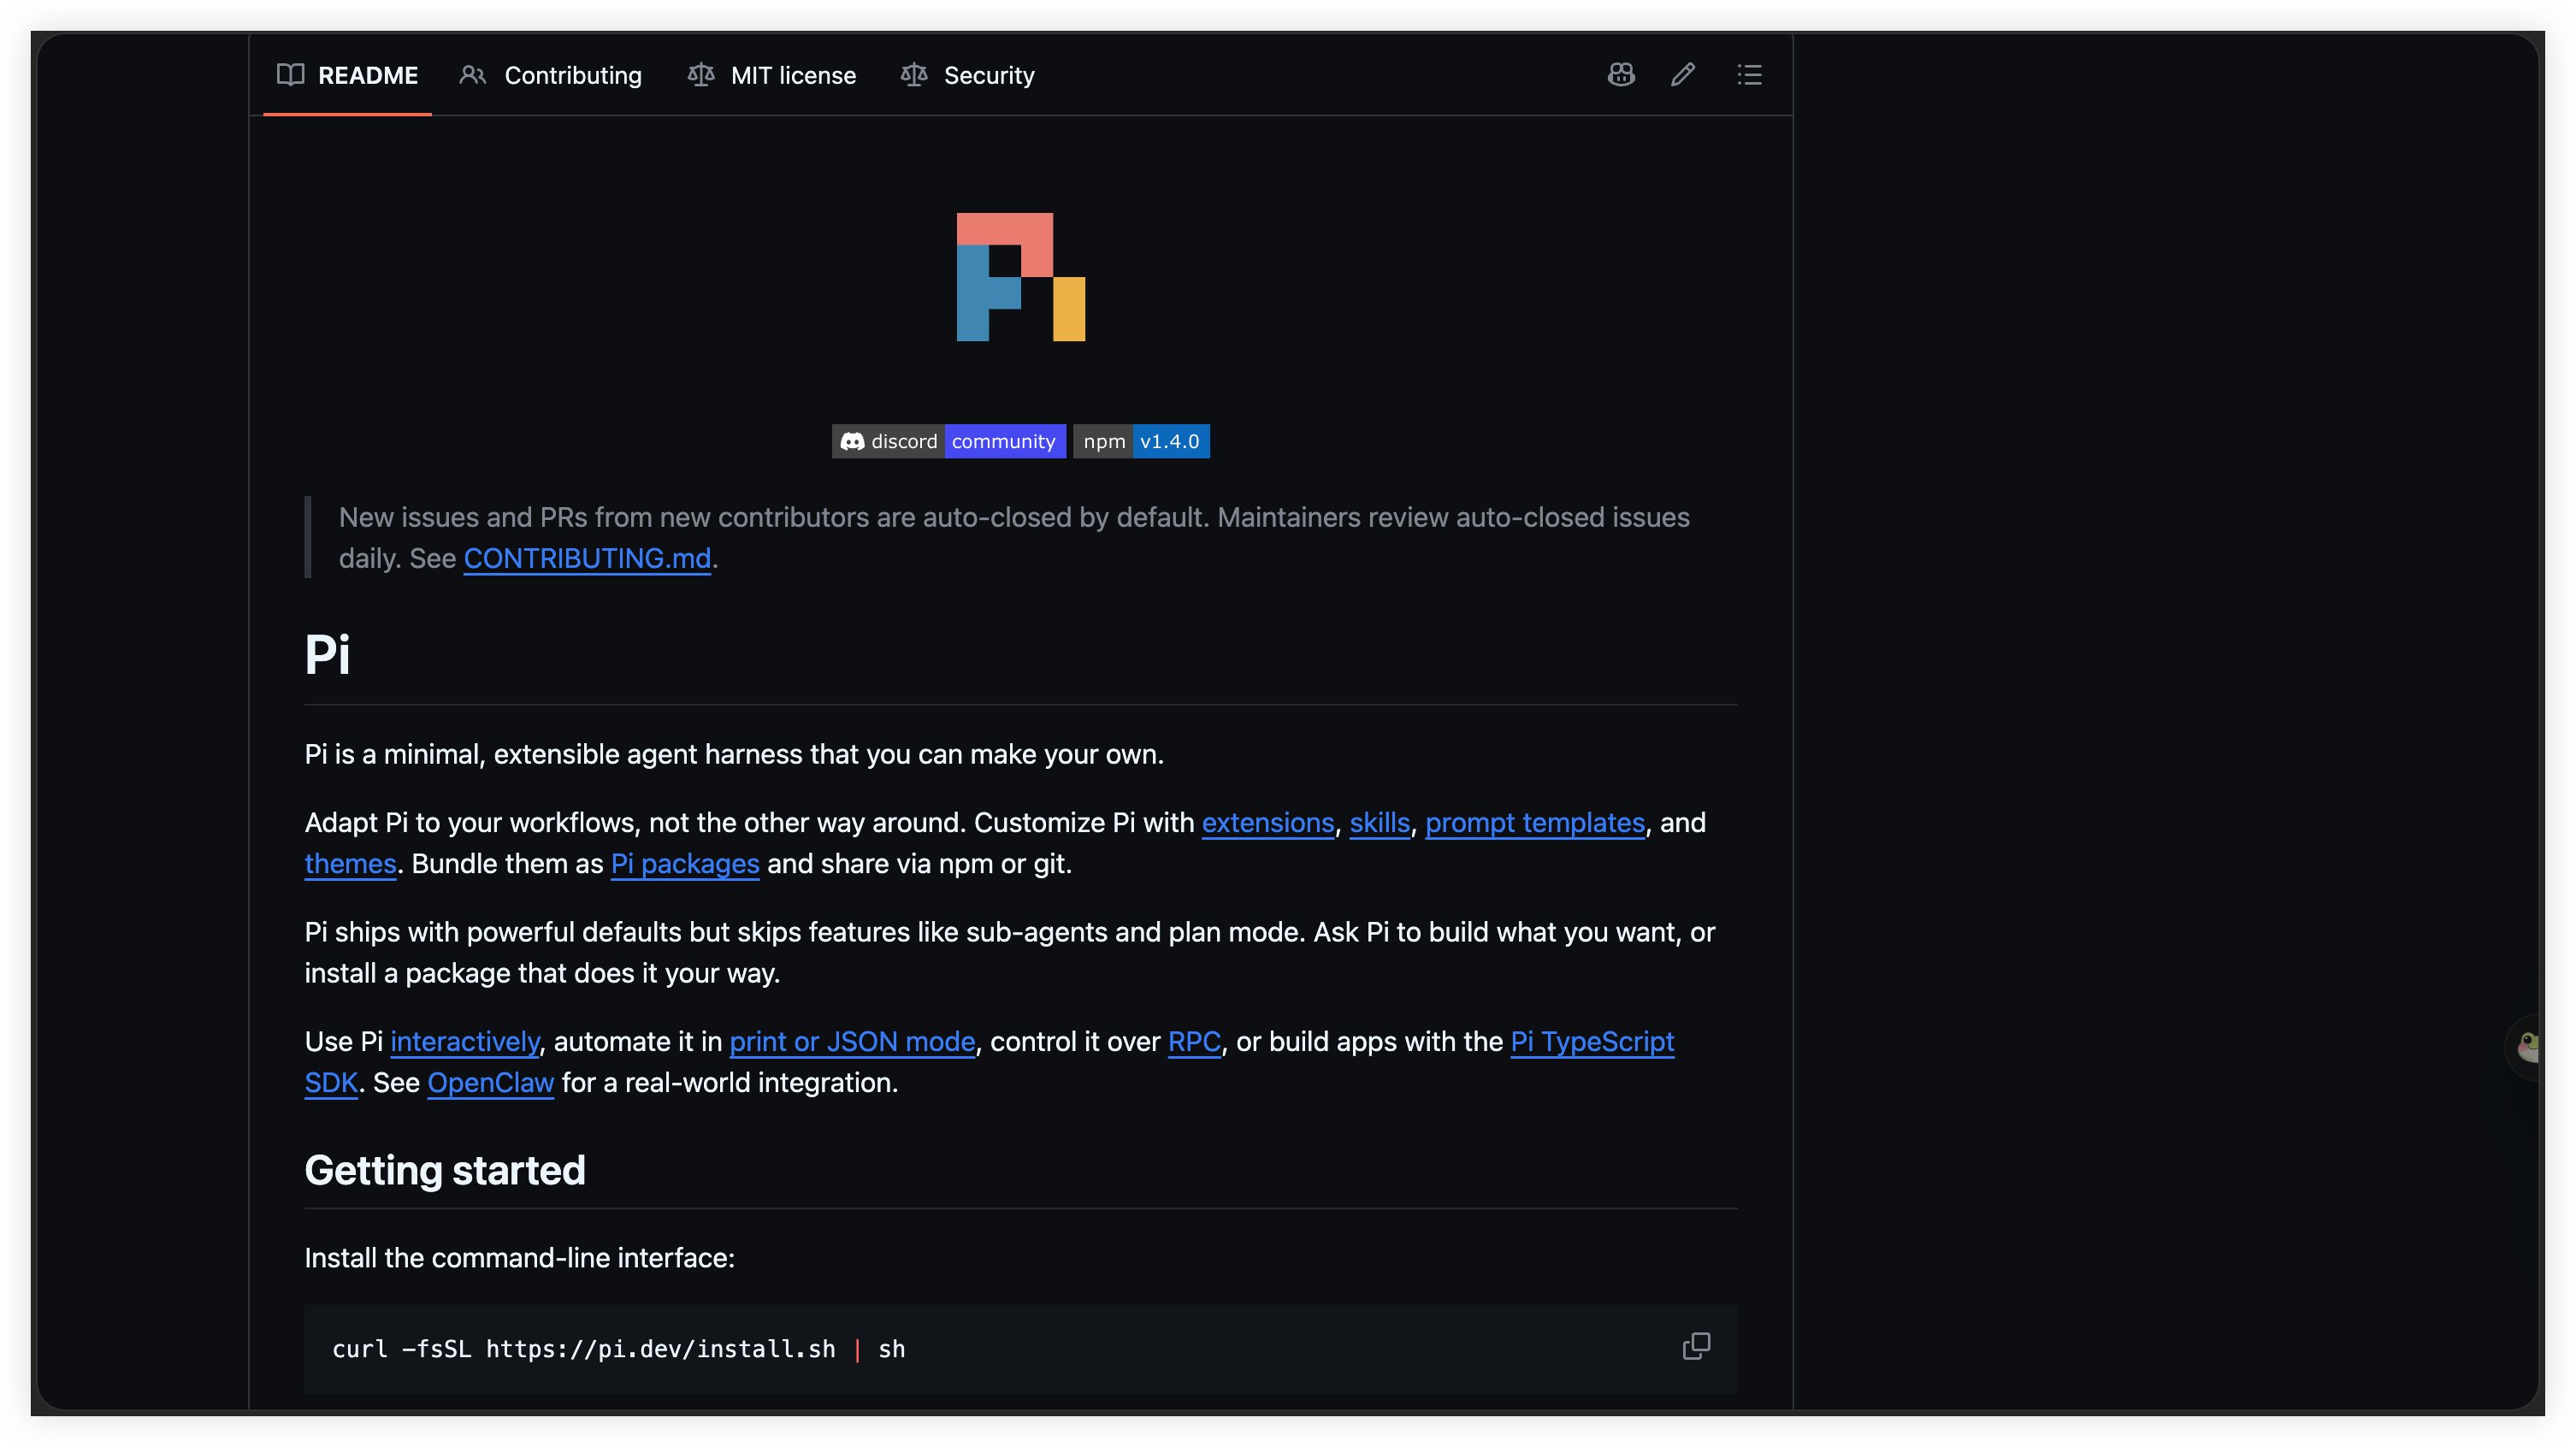
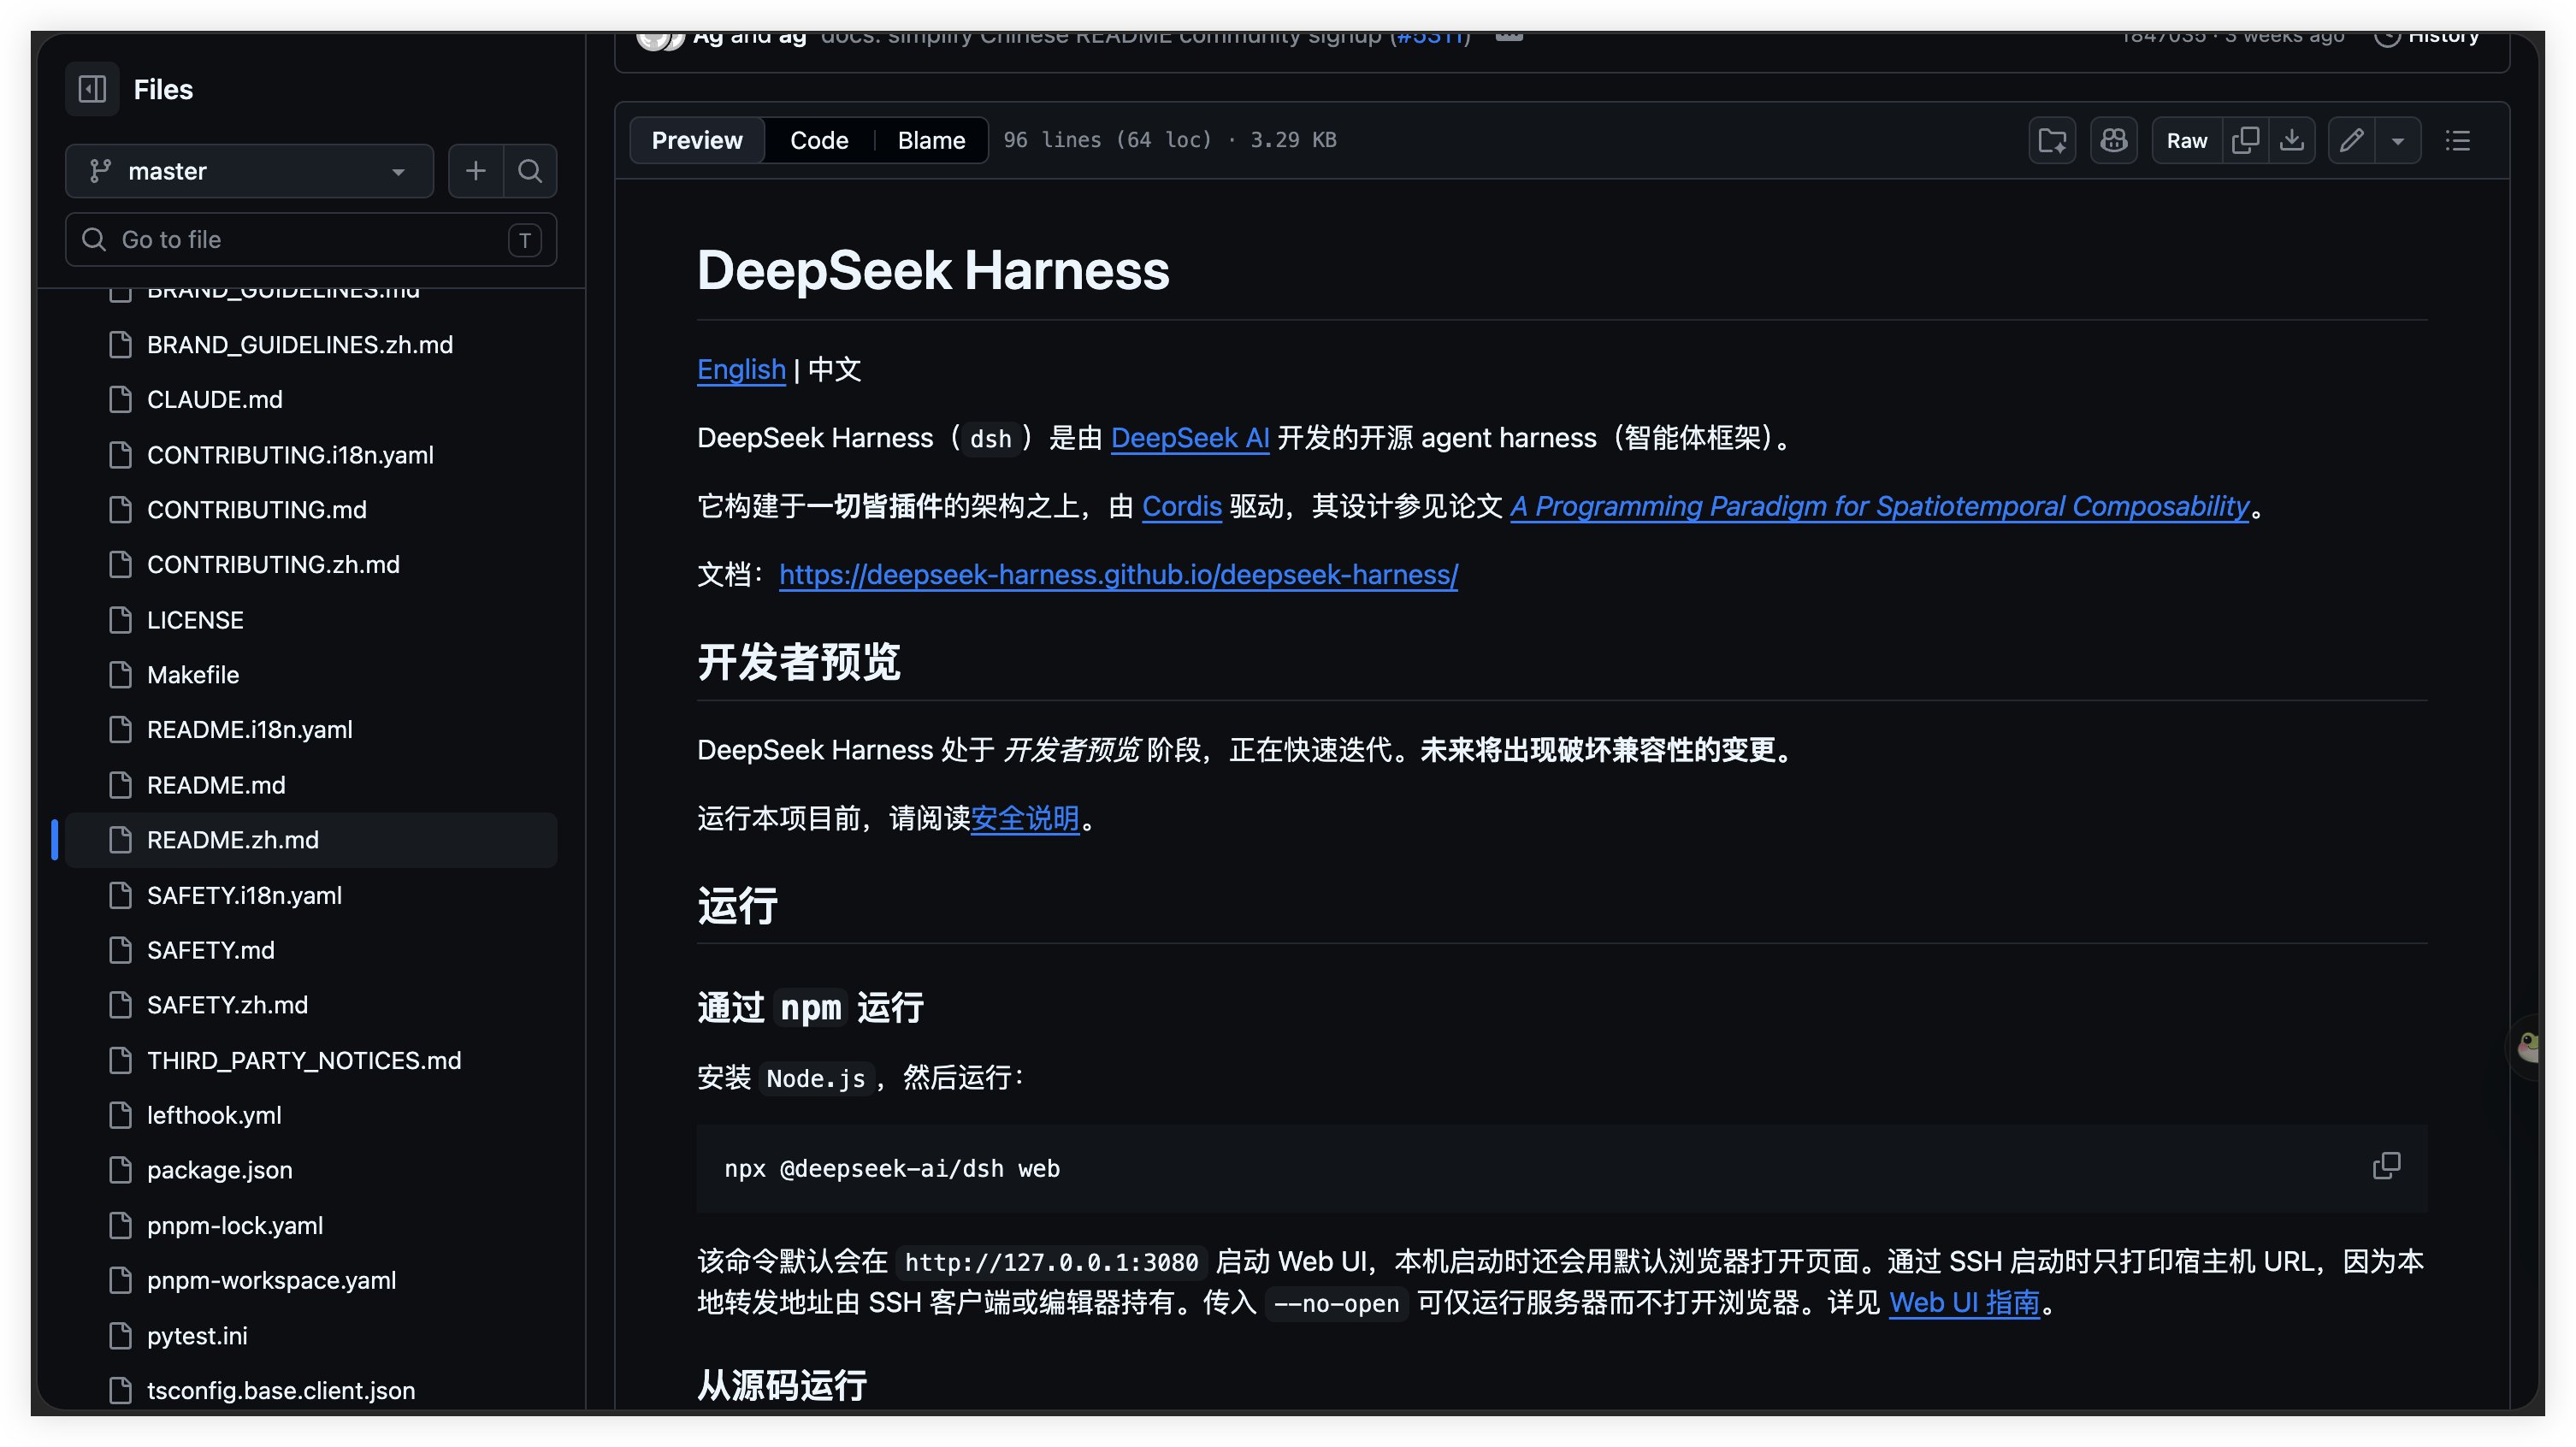
Pi 和 DeepSeek Harness,到底有什么区别?🔥 Pi 我已经研究了很长一段时间了,但是 DeepSeek harness 刚接手,有人问过我一个问题:Pi 和 DeepSeek harness 有什么区别? 我就花了一些时间研究了一下,总结了下面这几个点 1、Pi:核心尽量简单,想要什么自己加 Pi 默认只提供比较精简的 Agent 能力,需要 Subagent、特殊权限、定制工作流,就通过 Extension、Skills 和社区插件补上 它的好处是容易理解,也方便自己折腾,想改造某个功能,不一定要动整个运行时 2、DSH:Everything is a Plugin DeepSeek Harness 更激进,连 Model Adapter、Tool Registry、Session Storage,甚至 Agent Loop 都可以通过插件和配置进行替换 这意味着你不只是给 Agent 增加功能,还能重新组合它的运行体系。当然,插件依赖、配置复杂度和兼容性也需要自己处理 3、别以为 Harness 越复杂,效果就一定越好 我看到一组独立测试,在特定的 Terminal-Bench 子集上,同样使用 GPT-6 Astra,Pi 得分 60.32%,DSH 为 52.38% 另一组测试里,两者在任务耗时和成本上也各有表现。不过这些结果都受模型路由、任务集和测试配置影响,不能直接当成所有场景下的排名 这反而说明一个很重要的问题:模型相同,换个 Harness,任务成功率和实际成本也可能完全不同 4、一个适合日常折腾,一个适合深入改造 Pi 有终端、RPC 和 SDK,适合自己搭工作流、切换模型、开发扩展 DSH 则提供更完整的桌面和 Web 体验,也有执行轨迹可供分析,适合研究底层机制和插件组合 不过 DSH 目前仍处于 Developer Preview 阶段,安全隔离和兼容性都需要谨慎对待 我现在更感兴趣的,已经不是哪个 Harness 功能更多了,而是固定模型和任务后,换一套 Harness,究竟会对成功率、Token 消耗和实际账单产生多大影响 我就用一句话来概括:DeepSeek harness 是万物皆插件,插件化到连核心都可以替换,PI 极简,只属于你自己的 Agent
This post quotes another post: x.com/xiaomovps/status/2113093301717152107