gemini-4IMAGE
FrontierCode 2.0: DeepSeek V4.1 Flash tops open models, ahead of Gemini 4 Argon
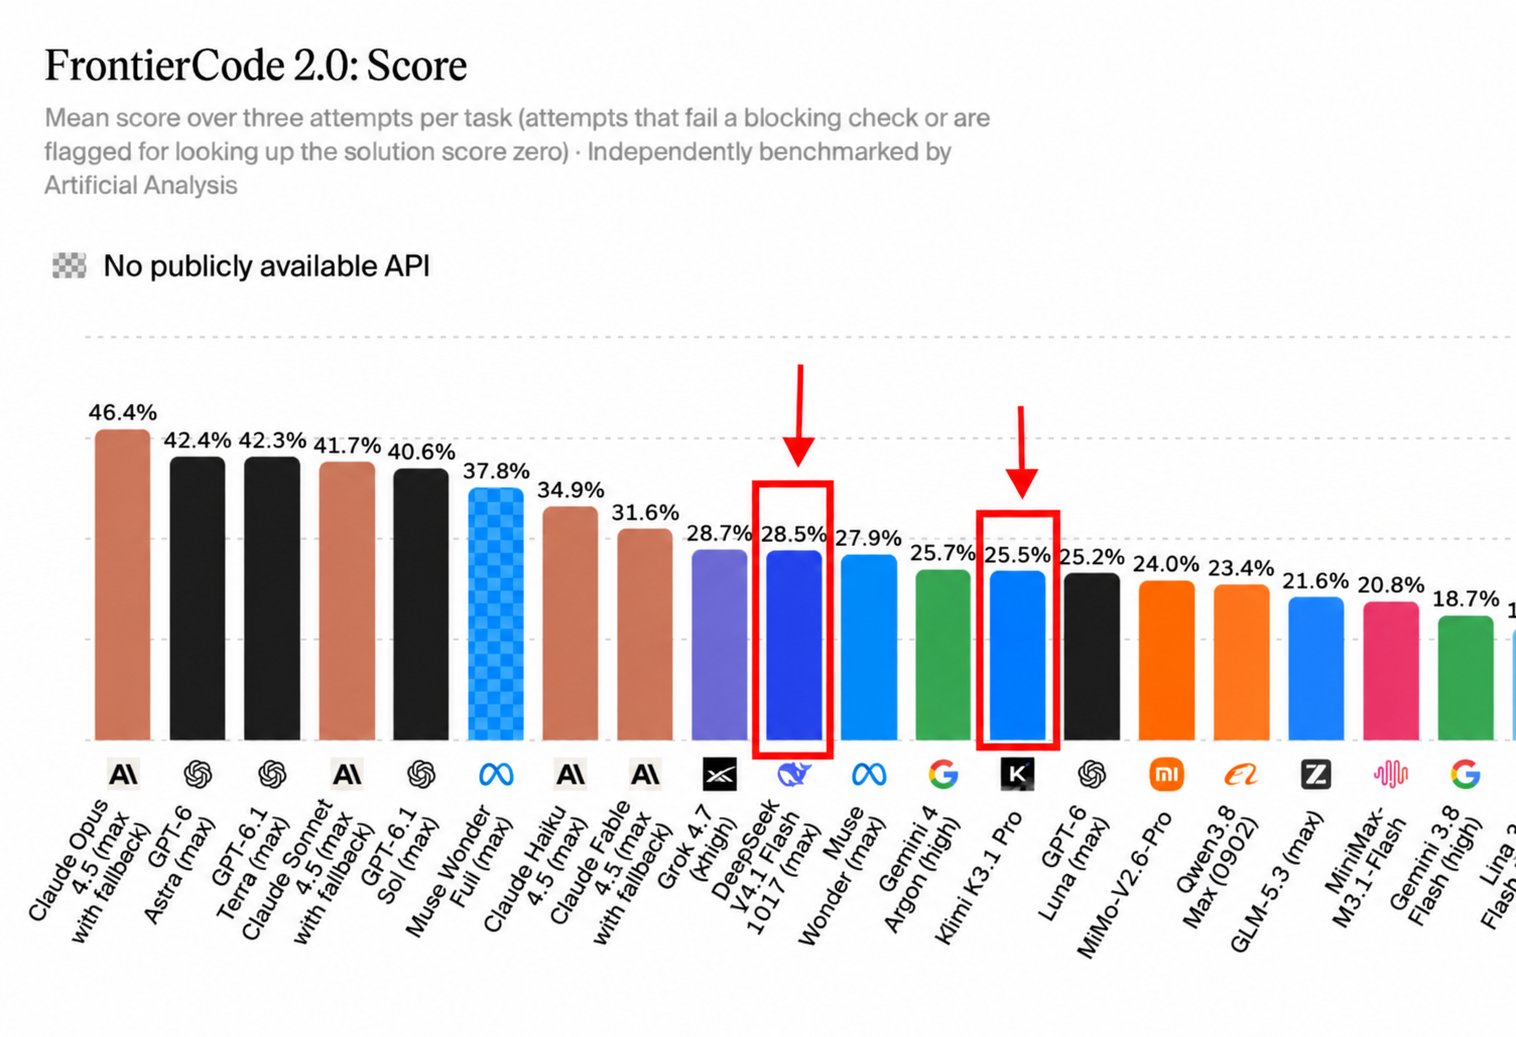
On AA's FrontierCode 2.0 engineering-code benchmark, DeepSeek V4.1 Flash 1017 scores 28.5% to lead open models, beating Kimi K3.1 Pro, Gemini 4 Argon and GPT-6 Luna.
xiax|AI & Agents
@xiax0603Archived 16 hours agoOriginally posted 2026.10.28
xiax|AI & Agents @xiax0603Originally posted 2026.10.28
🚨FrontierCode 2.0榜单出炉,DeepSeek V4.1 Flash 1017撕开开源代码模型天花板! 这份由Artificial Analysis独立评测的榜单,和很多侧重语法刷题的代码基准不一样,它看重可落地、能合并进项目的工程代码能力。 DeepSeek V4.1 Flash 1017拿到28.5%,排在开源模型首位,分数超过Kimi K3.1 Pro、Gemini 4 Argon、GPT-6 Luna多款主流闭源模型。 很多旧榜单容易把代码能力等同于写简单算法,低估模型在真实工程里的调试、上下文对齐、风险判断能力。 这个结果意味着,开源模型不再只靠低价做补充,在工程落地这个核心维度,已经具备正面硬刚闭源产品的实力。 但也要理性看待,榜单中段分数咬得很紧,一次基准不代表全面领先,代码能力只是模型综合能力的一环。 真正的优势,是它同时兼顾工程表现和成本,这对开发者、小团队来说价值极高。
This post quotes another post: “AA Intelligence Index v5: Gemini 4 Argon ranks sixth behind Opus 5.5”
x.com/xiax0603/status/2115316463242559709Archived 2026.10.29 10:03