Self-evolving harnesses overfit: Astra and peers in ARC-AGI-3 test
GPT-6 Astra, GPT-5.6 and Opus 5 build and twice rewrite their own ARC-AGI-3 harnesses: dev scores rise 8.4 points but held-out tasks only 2.8, with 15 of 27 trajectories improving and 12 regressing.
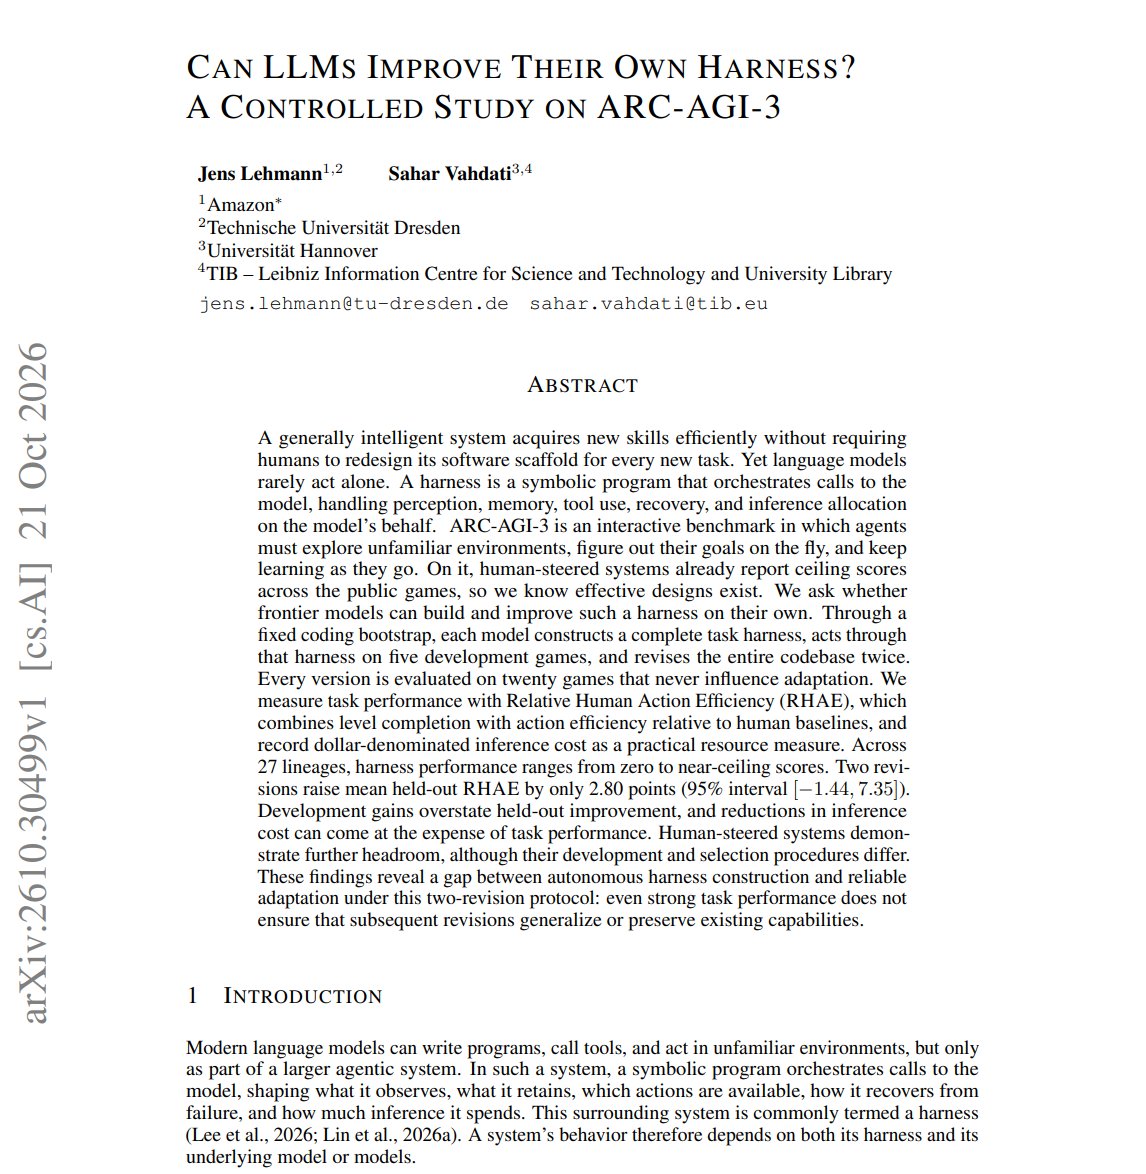
Agent 把自己的 Harness 改了两轮。 开发集涨了 8.4 分,真正没见过的任务只涨了 2.8 分。 这可能是 Harness 自进化里最需要警惕的信号:它会改自己了,但改出来的东西经常过拟合。 作者让 GPT-6 Astra、GPT-5.6、Claude Opus 5 等模型从一个极简代码库开始,自己搭建完整的 ARC-AGI-3 Harness。 跑完任务后,再把执行轨迹交给模型,让它连续两次修改自己的代码。 整个实验包含 27 条独立进化轨迹、81 个 Harness 版本和 2025 次游戏评测。 结果是有些 Harness 从很弱一路改到接近满分,也有一些越改越差。两轮之后,15 条轨迹提升,12 条退步。 更明显的问题是「Harness Adaptation Gap」: 模型很容易针对自己刚看过的任务做出有效修改,但这些修改到了 held-out 任务上,经常无法迁移,甚至破坏原本已经会的能力。 而且代码确实一直在变多。 Harness 的中位规模从 2161 行增长到 2912 行,但修改量和真正的性能提升几乎没有稳定关系。 会改自己,只证明 Agent 能动手。 能判断什么时候该改、改完能不能泛化、什么时候最好什么都别动,才更接近真正可靠的 self-improvement。