gpt-6IMAGE
GPT-6 Astra leads on new Terminal-Bench-Science research benchmark
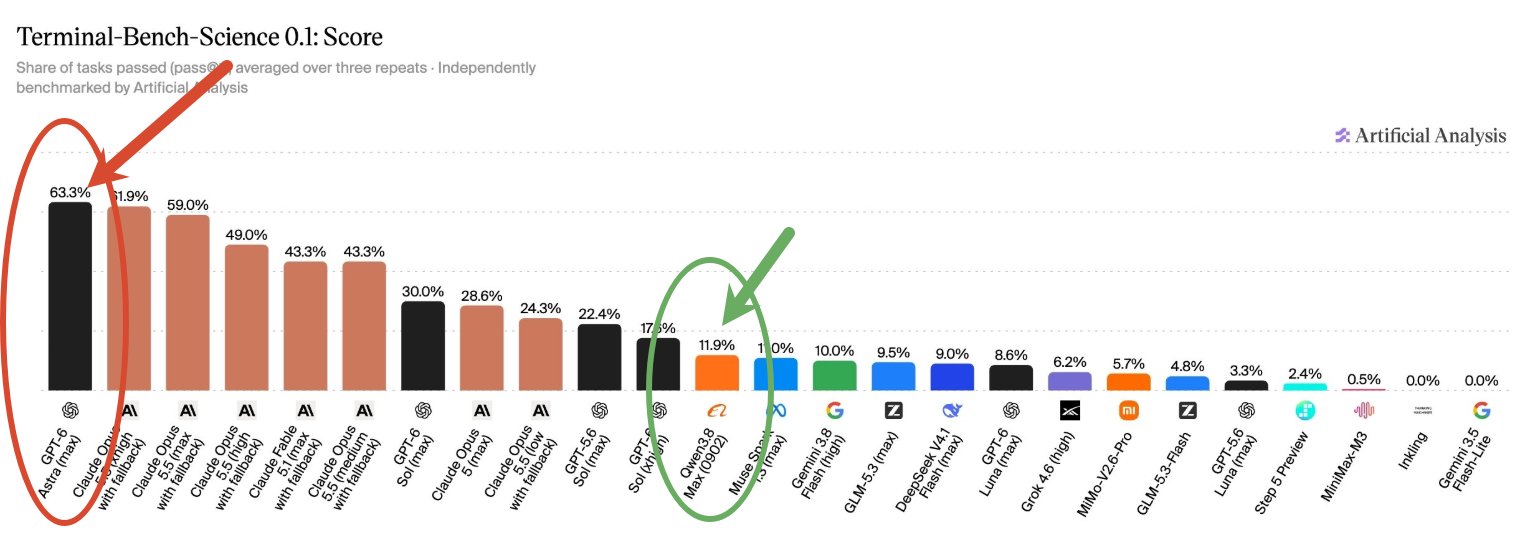
On Artificial Analysis's new 70-task Terminal-Bench-Science 0.1 benchmark of real research tasks, GPT-6 Astra beats Claude in research scenarios, with Qwen3.8-Max the best Chinese model.
雪瑜
@xueyu1125Archived 2026.09.28Originally posted 2026.09.27
雪瑜 @xueyu1125Originally posted 2026.09.27
卧槽,发现Artifical Analysis又搞了新的benchmark:Terminal-Bench-Science 0.1,这个benchmark主要是用来对大模型的科研能力进行测试 70个基于五个真实领域的科研任务,科研任务直接跑在沙箱里,排名前二的还是那两个大模型GPT和Claude 但是在科研场景下GPT-6 Astra更胜一筹,中国最好的模型还是那个比较少人用的Qwen3.8-Max(0902)
x.com/xueyu1125/status/2104044217739989139Archived 2026.09.28 10:04