deepseek-v4.1IMAGE
DeepSeek V4.1 Flash IQ2 quant on 3x V100: 26 tok/s decode
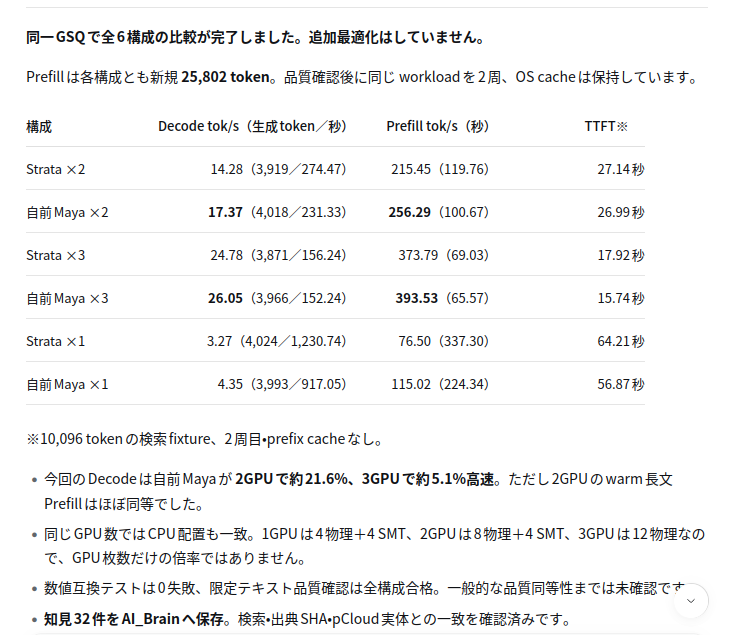
On three V100 32GB cards with dual 2650v2 and DDR3, the GSQ-RCO-IQ2_XXS quant decodes at 26.05 tok/s and prefills at 393.53 tok/s, versus 17.37 tok/s on two cards, with hardware-tuned builds clearly faster.
SOKOSOKO LIGHT GEAR
@yama_bokuArchived 6 days agoOriginally posted 2026.10.25
SOKOSOKO LIGHT GEAR @yama_bokuOriginally posted 2026.10.25
V100(32GB)×3、2650v2×2、DDR3(512GB)の貧困3点セット(AVX1、PCIe3.0、DDR3の三重苦)で DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XXS を回してみました、結果 V100(32GB)×2 Decode 17.37tok/s Prefill 256.29tok/s V100(32GB)×3 Decode 26.05tok/s Prefill 393.53tok/s 3枚だとギリ許容範囲で動くと言っていい気がします、遅いですけどね 今回の推論エンジンはStrataを動くようにしただけの物とProject Mayaをベースに三重苦用に出来る限りの最適化を施した物を比較したのですが 結果、ハードウェア最適化は効きますね、メインモデルにはやった方がよさそうです、ただ、Codex100$の週次半分は覚悟しておいてください 意図を取り違えられると困るんですが、どちらもStrataベースだし、私はフロンティアにハードウェアへの最適化を適当に投げただけなのでStrataが凄いんです、三重苦でも動く事に感謝
x.com/yama_boku/status/2114121051005501808Archived 2026.10.25 12:00