Coding Agent 成本对比:Gemini 4 Argon 每任务 5.84 美元
Artificial Analysis 榜单显示 Claude Code+Sonnet 5.5 得 68 分每任务 14.19 美元,Antigravity CLI+Gemini 4 Argon high 得 64 分 5.84 美元,Codex+GPT-6.1 Sol 得 63 分仅 1.04 美元。
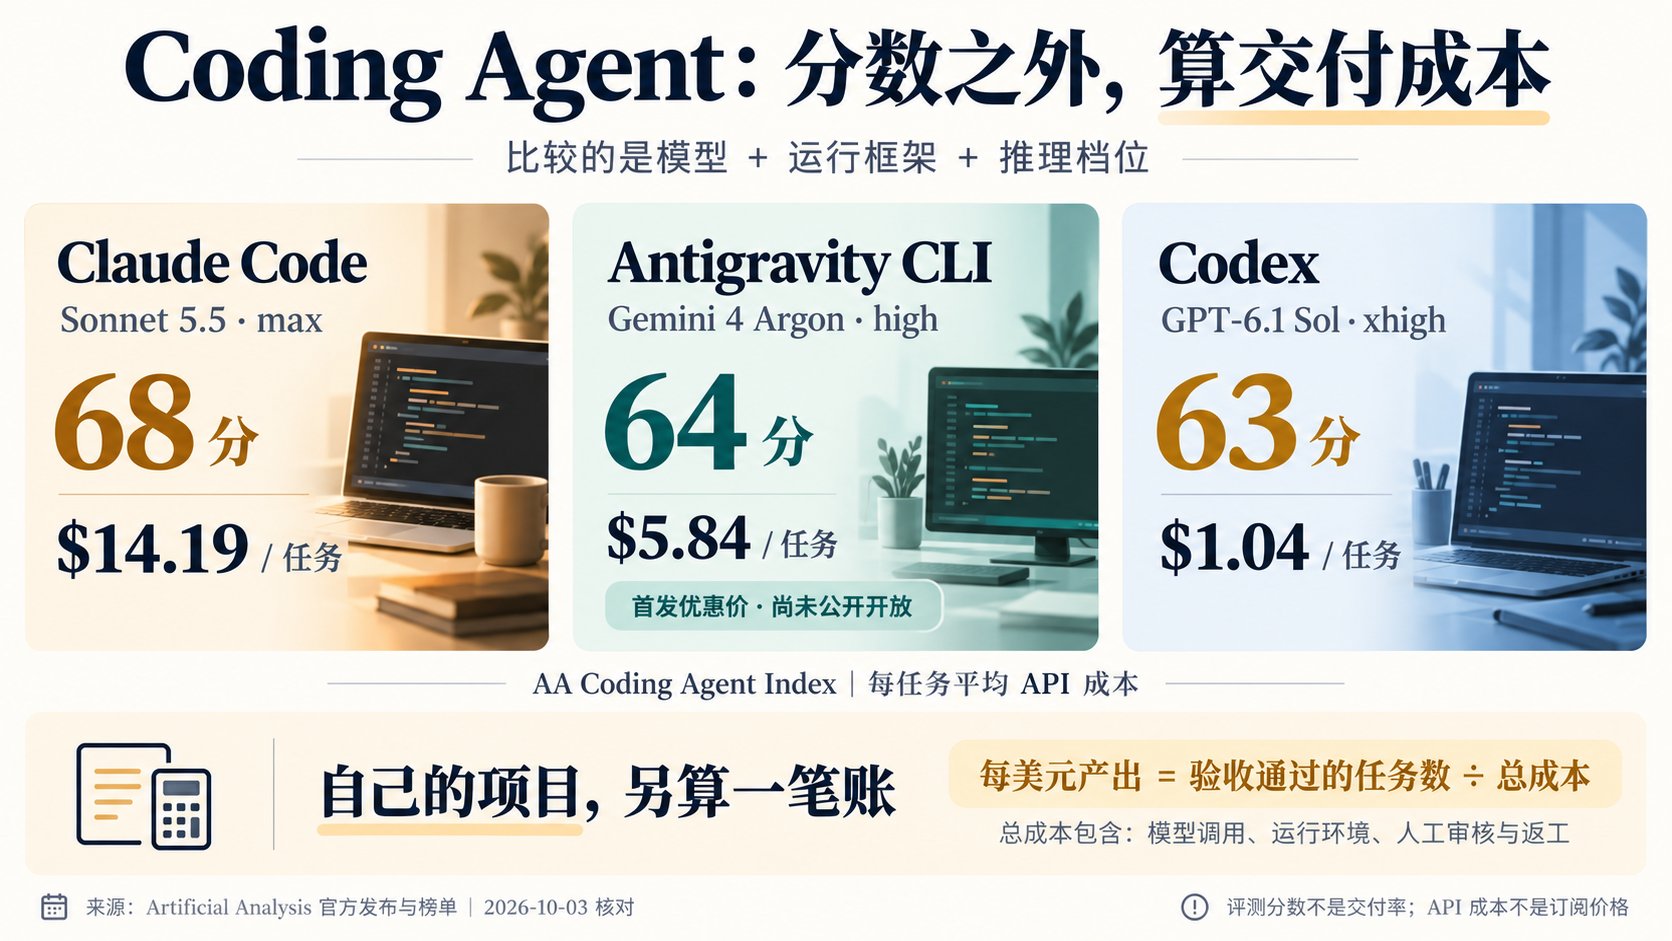
💸Coding Agent 差 5 分,每任务成本却差近 14 倍! Artificial Analysis 这轮榜单,把一个选型问题摆到了桌面上:拿最高分,和用同样预算做更多事,可能是两种选择。 先看官方公布的三组成绩: 🔹Claude Code+Sonnet 5.5 max:68 分,平均每任务 14.19 美元。 🔹Antigravity CLI+Gemini 4 Argon high:64 分,5.84 美元。 🔹Codex+GPT-6.1 Sol xhigh:63 分,1.04 美元。 Argon 按首发优惠价计算,发布评测时尚未公开开放。这里的成本也是 API 用量账单,不能直接换算成订阅套餐价格。 更容易被忽略的是:榜单测的是整套 Agent。 读哪些文件、怎么调用终端、失败后如何重试、怎样保留上下文,都由模型与运行框架共同决定。 把同一个模型接进另一个工具,再换一档推理强度,结果可能变。只记住“Sonnet 第一”或“Sol 最便宜”,会丢掉测试条件。 对 Web3 小团队,我会拿三类真实任务来复测: 🔹批量补测试、改接口:看能验收多少项,返工多少次。 🔹修改索引器、交易解析:看能否处理漏数、重复事件和异常输入。 🔹涉及签名、权限、资金逻辑:检查关键约束,人工审查不能省。 同样改完一个文件,有的能直接合并,有的还要工程师修半天。后者的成本不会完整出现在 API 账单里。 所以,“每美元产出”应该这样算: 验收通过的任务数 ÷ 总成本。 🔹失败尝试和重跑费用算进去。 🔹运行环境、人工审核与返工算进去。 🔹另外记录耗时,确认交付能赶上需求。 也别直接拿榜单分数除以美元,宣布生产力提高多少倍。综合指数里的分数,不等于你仓库里的交付率。 我的判断:这组结果足够让人重新测试默认方案,但还不足以直接替整个团队换栈。 先用同一批任务、同一套验收标准,看看低成本组合能覆盖多少日常工作,再判断高成本组合在哪些难题上值得调用。 一句话:榜单告诉你谁考得好,合并记录和账单告诉你谁用得值。 #AIAgent #AI编程
这条是引用着另一条写的:x.com/0x99dada/status/2105902096872767636