阿拉伯语决策引擎 Sev 基于 Jev 决策头构建
Sev Arabic Preview v0.1 用 mmBERT 加 Jev 的 Typed Decision Head,单次编码返回 choice 和校验决策,开发集准确率 94.55%。
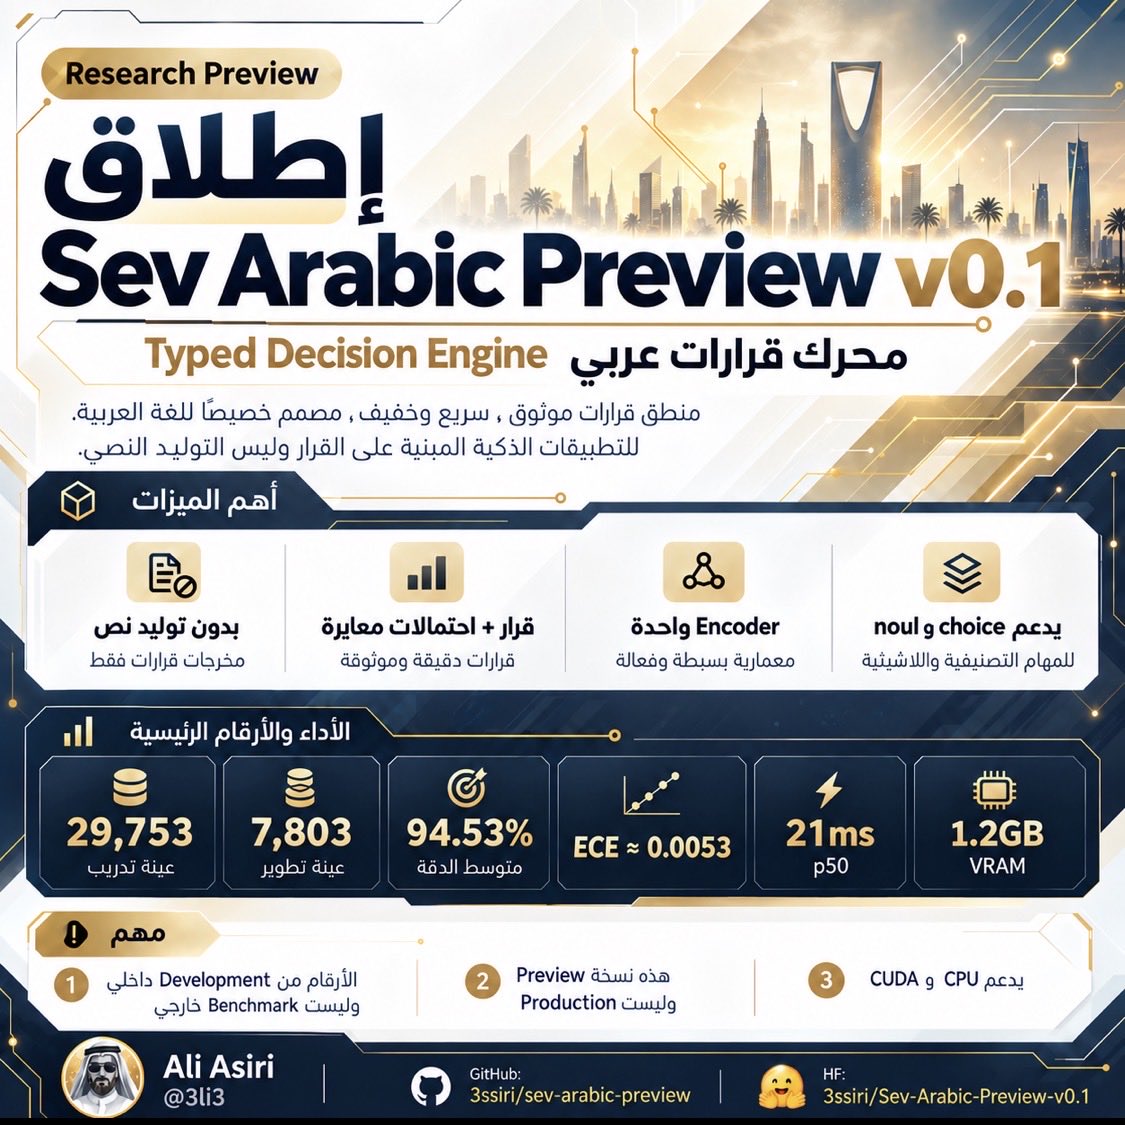
من المختبر إلى العالم.. أطلقنا Sev Arabic Preview v0.1 🇸🇦 هذه بالنسبة لي ليست مجرد نسخة تجريبية جديدة. هي نتيجة رحلة بدأت بفكرة بسيطة: هل نقدر نبني محرك قرار عربي خفيف وسريع، يفهم الحالة، يجيب على أسئلة محددة، ويرجع قرار واضح مع احتمالات معايرة، بدون الحاجة لتوليد نص كامل؟ اليوم صار عندنا أول إصدار عام قابل للتجربة. Sev ليس نموذج محادثة. تعطيه حالة أو طلب بالعربي + مجموعة أسئلة وقرارات محددة، ويرجع لك القرار مع الاحتمالات في تمريرة Encoder واحدة. الهدف منه أن يكون طبقة قرار عملية يمكن استخدامها في: Routing، تصنيف النوايا، التحقق من التصنيف، والأنظمة الوكيلة التي تحتاج قرارات محددة وسريعة بدل توليد نص كامل. ← كيف بنيناه؟ البنية مبنية على mmBERT-base من جامعة Johns Hopkins، مع LoRA صغير r=8 وTyped Decision Head. وكود رأس القرار مبني على مشروع open-jev-typed-decision-engine للمطور Intikhab Azam بترخيص Apache-2.0. التدريب في هذه النسخة كان على بيانات عربية فقط: 29,753 عينة تدريب 7,803 عينة تطوير من مصدرين: MASSIVE ar-SA ArBanking77 ثم حولنا البيانات إلى صيغة Sev نفسها: حالة + أسئلة Typed + خيارات واضحة. ← ماذا تدعم النسخة الحالية؟ choice لاختيار قرار من مجموعة خيارات. noul للتحقق من صحة التصنيف بجانب سؤال choice. والطلب الواحد يمكن أن يحتوي حتى 8 أسئلة، وتتم معالجتها في تمريرة Encoder واحدة، بدون Text Generation. ← النتائج الحالية Checkpoint النسخة المنشورة Seed 42: الدقة الكلية: 94.55% دقة choice: 92.82% دقة noul: 96.28% وعبر 3 تجارب مستقلة Seeds 42/17/73: متوسط الدقة: 94.53% الانحراف: 0.04 نقطة مئوية وبعد Calibration: ECE ≈ 0.0053 لكن مهم أوضح شي هنا: هذه أرقام Development داخلية من نفس مصادر البيانات المستخدمة في بناء النسخة، وليست Benchmark خارجية، لذلك ما أستخدمها حاليا للمقارنة مع Jev أو Lev أو Laya أو غيرها. التقييم الخارجي سيكون له مساره ونتائجه الخاصة. ← الأداء المحلي على RTX 4060 Ti 8GB سجل اختبار النسخة: حوالي 21ms p50 للطلب وحوالي 1.2GB VRAM والنسخة تعمل أيضا على CPU بدون GPU. هذه قياسات على جهاز واحد، وليست ضمان أداء على كل الأجهزة. ← طيب لماذا أطلقنا Preview الآن؟ لأن الهدف ليس انتظار نسخة مثالية ثم إظهار النتيجة النهائية فقط. الهدف أن نخرج العمل من المختبر إلى نسخة عامة قابلة للفحص وإعادة الاختبار. تقدر تعرف: على ماذا تدرب النموذج. كيف تم تقييمه. ما هي حدوده. وكيف تشغله وتجربه بنفسك. هذه Research Preview وليست Production. ومن أهم حدودها حاليا: النص الأطول من 384 Token يتم قصه تلقائيا مع تنبيه في النتيجة. score غير مدعوم بعد. noul في هذه النسخة مخصص للتحقق من التصنيف، وليس Yes/No عاما. التغطية الحالية تتركز على نوايا المساعدات الافتراضية والطلبات البنكية. اللهجات السعودية والخليجية لم تحصل بعد على Benchmark مستقل. لا يوجد Abstention تلقائي حاليا. ولم نقس بعد أداءه على خيارات أو مجالات جديدة خارج بيانات التدريب، ولا على طلبات تحتوي أكثر من سؤالين. وهذا بالضبط سبب إطلاق النسخة الآن: نريد اختبارات خارجية. نريد حالات فشل حقيقية. نريد قياس التعميم خارج بيانات التدريب. ونريد أن تكون خطوات بناء Sev النهائي موثقة وواضحة من البداية. الكود متاح بترخيص Apache-2.0. أوزان Sev المنشورة بترخيص CC BY-SA 4.0. والعمل مستمر على النسخة النهائية من Sev ببيانات أوسع، تقييم خارجي، وتجارب معمارية أدق. GitHub: https://github.com/3ssiri/sev-arabic-preview Hugging Face: https://huggingface.co/3ssiri/Sev-Arabic-Preview-v0.1 DOI: https://zenodo.org/doi/10.5281/zenodo.22979051 اليوم خرج Sev من المختبر. والآن يبدأ الاختبار الحقيقي.