GPT-6 Astra 该开多高 thinking?先看 benchmark 再决定
泰语长帖建议:别默认开 Max,先对比同任务各 thinking 档位的成功率、耗时和 token,再清理为旧模型写的 prompt 与 Skills。
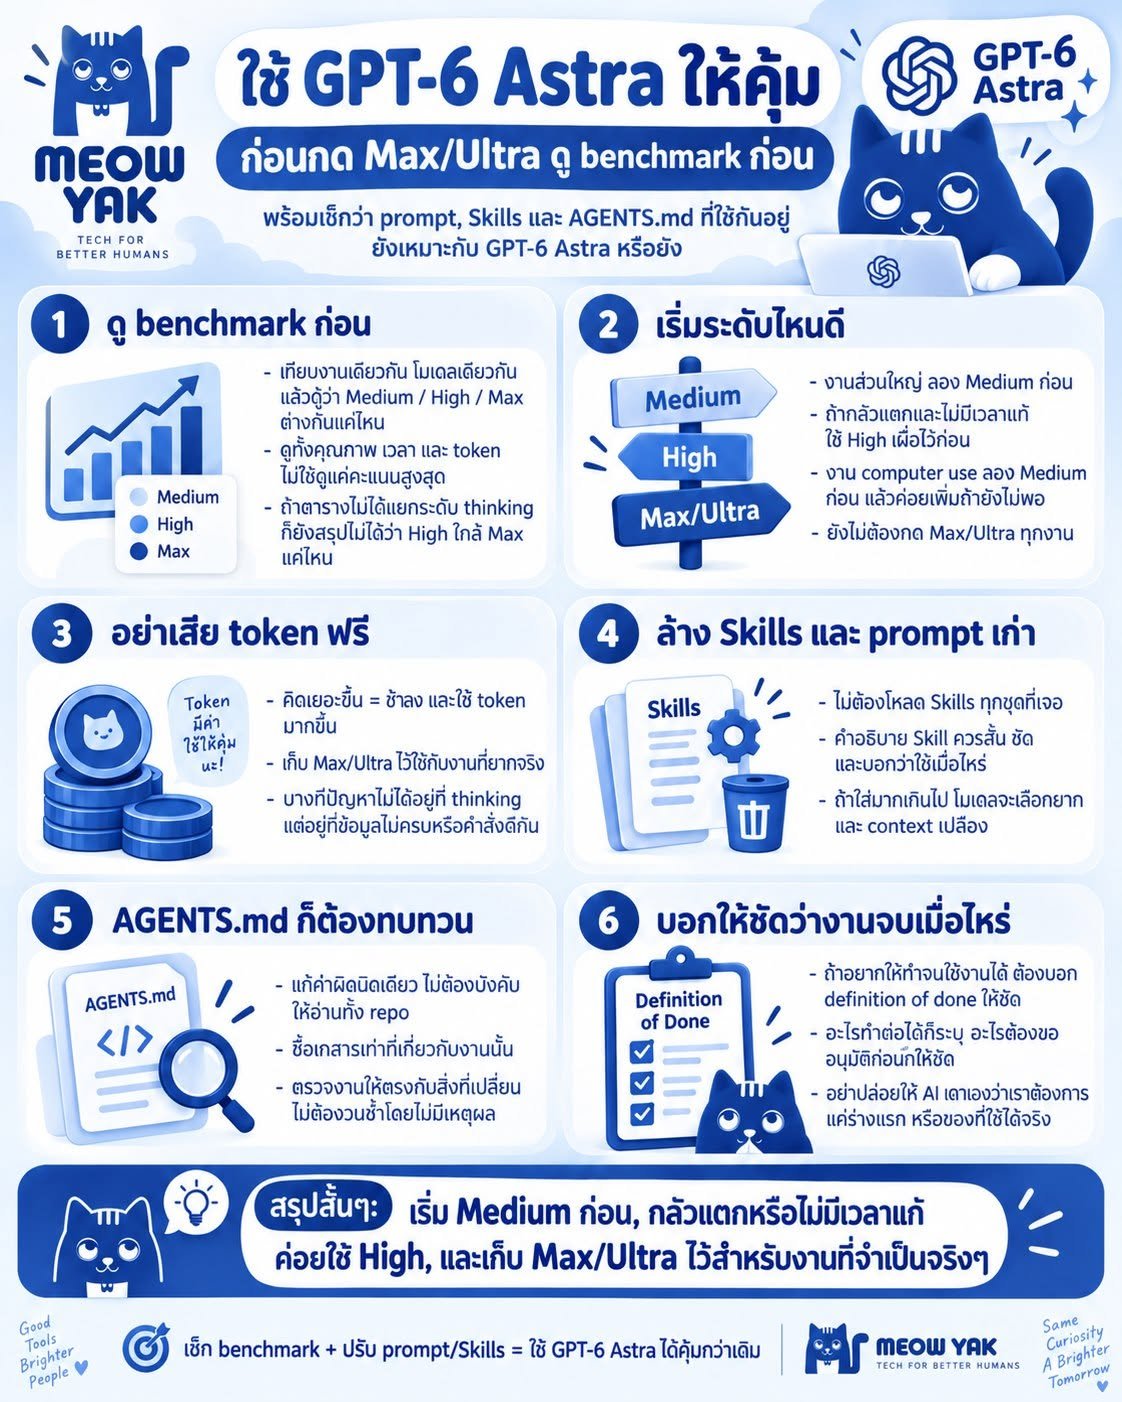
“ก่อนใช้ GPT-6 Astra ที่ Max/Ultra thinking ลองดู benchmark ก่อนว่าจริงๆงานเราใช้ขนาดนั้นไหม แล้วเช็กด้วยว่า prompt กับ Skills เก่าที่ใส่ไว้ยังช่วยงานอยู่ไหม ได้ปรับให้เหมาะกับ GPT-6 Astra หรือยัง ถ้าอ่านแล้วไม่แน่ใจ post นี้แหละคำตอบเลย !” ผมอยากชวนดูสองเรื่องนี้คู่กันครับ เราจำเป็นต้องเปิด thinking สูงสุดทุกงานไหม แล้วคำสั่งที่สะสมมาตั้งแต่โมเดลรุ่นก่อน ยังช่วยงานอยู่จริงหรือเปล่า บทความ Rethinking skills and prompts for GPT-6 Astra พูดถึงเรื่องหลังได้ตรงมาก เคยไม่อ่านไฟล์ก็สั่งให้อ่านทุกครั้ง เคยทำพังก็สั่งให้ตรวจซ้ำ เคยทำเกินก็สั่งให้ถามก่อนทุกอย่าง พอเปลี่ยนโมเดลแล้ว กติกาเหล่านี้ยังอยู่ครบ แต่เราได้กลับไปดูมันหรือยัง ═══════════════════ 📊 ดู benchmark ก่อน อย่าเพิ่งกดสุด - เวลาเทียบ ผมอยากให้ดูโมเดลเดียวกัน งานเดียวกัน แล้วแต่ละระดับ thinking ทำได้ต่างกันแค่ไหน ดูทั้งงานสำเร็จไหม รอนานแค่ไหน และใช้ token เท่าไร ไม่ใช่ดูแค่คะแนนสูงสุดตัวเดียว - ถ้างานนั้น High กับ Max ได้ผลใกล้กัน แต่ Max ใช้เวลาและ token เพิ่ม เราจำเป็นต้องเปิด Max ทุกครั้งไหม สำหรับผม ความต่างที่เพิ่มมาควรช่วยงานเราจริงๆ ถึงจะคุ้ม - แต่ถ้าตารางไม่ได้แยกระดับ thinking ก็ยังบอกไม่ได้ว่า High ใกล้ Max แค่ไหนนะ อย่าเอาคะแนนสูงสุดมาแทนทุกระดับ แล้วสุดท้ายต้องลองกับงานของเราเองด้วย ═══════════════════ ⚙️ งานส่วนใหญ่ ผมแนะนำให้ลอง Medium ก่อน แต่ถ้ากลัวแตกและไม่มีเวลาแก้ ก็ใช้ High เผื่อไว้ก่อนครับ - งานส่วนใหญ่ ผมอยากให้ลอง Medium ก่อน ถ้าทำได้ครบและผ่านสิ่งที่เราต้องการ ก็ใช้ต่อได้ ยังไม่ต้องขยับขึ้นเพียงเพราะมีระดับที่สูงกว่าให้เลือก - งานที่รู้ว่ายาก โดยเฉพาะโค้ดซับซ้อน หรือไม่มีเวลามานั่งไล่แก้หลายรอบ ผมแนะนำ High เผื่อไว้ก่อน แต่ก็ยังไม่จำเป็นต้องกระโดดไป Extra High หรือ Max ตั้งแต่แรก - งาน computer use ที่ให้ AI เปิดโปรแกรม กดปุ่ม ทำงานตามขั้นตอน ผมก็แนะนำให้เริ่ม Medium เหมือนกัน ถ้ายังเอาไม่อยู่ค่อยเพิ่ม แต่เช็กก่อนด้วยว่าติดเพราะคิดไม่พอ หรือข้อมูลไม่ครบและคำสั่งตีกัน นี่เป็นแนวทางที่ผมแนะนำนะ ไม่ได้แปลว่า Medium พอทุกงาน หรือเปิด High แล้วงานจะไม่มีทางแตก การตรวจงานยังต้องมีเหมือนเดิม ═══════════════════ 💰 อย่าใช้ token หมดไปกับการกดสุดทุกงาน - การคิดเพิ่มมีต้นทุน เอกสาร OpenAI อธิบายว่าระดับที่ต่ำลงเน้นความเร็วและใช้ token น้อยลง ส่วนใครใช้ API ต้องนับ reasoning tokens ที่เราไม่เห็นในคำตอบด้วย เพราะคิดค่าบริการเป็น output tokens - Max กับ Ultra ก็ทำงานต่างกัน คู่มือ Models อธิบายว่า Max ให้โมเดลคิดกับงานมากขึ้น ส่วน Ultra ใช้ subagents หรือผู้ช่วยย่อย แบ่งงานไปทำพร้อมกัน จึงเหมาะกับงานที่แยกเป็นส่วนๆ ได้จริง ไม่ใช่เห็นชื่อ Ultra แล้วต้องเลือกไว้ก่อน - ผมเลยอยากให้เก็บงบไว้กับจุดที่ยากจริงๆ ส่วนใครใช้ผ่านแอป ให้ดูเครดิตหรือโควตาของแพ็กเกจตัวเองด้วย อย่าเอาตัวเลข token ใน API ไปคิดแทนโควตาทุกแอปตรงๆ ═══════════════════ 🧩 Skills ไม่ต้องโหลดมาทุกชุดที่เจอ - ตามบทความ ชื่อกับคำอธิบายของ Skills จะเข้าไปอยู่ใน context ให้โมเดลเลือกว่าจะใช้ตัวไหน ยิ่งติดตั้งเยอะก็ยิ่งมีข้อมูลส่วนนี้ให้อ่าน และถ้ามากเกินพื้นที่ Codex จะเริ่มย่อคำอธิบาย ทำให้ข้อมูลที่ช่วยเลือกเหลือน้อยลง - บาง Skill เขียนคำอธิบายกว้างมาก เหมือนบอกว่า “ทำอะไรก็เรียกฉันก่อน” พอมีหลายตัวแย่งกันหรือสั่งคนละทาง โมเดลก็อาจหยิบคู่มือที่ไม่ได้ช่วยงานนั้นมาอ่านเพิ่ม - คำอธิบายควรสั้นและชัดว่าใช้เมื่อไหร่ เช่น Skill สำหรับย้ายโครงสร้างฐานข้อมูล ก็บอกว่าใช้ตอนย้ายโครงสร้างฐานข้อมูล ไม่ใช่แค่แตะฐานข้อมูลนิดเดียวก็ต้องเรียกทุกครั้ง ═══════════════════ 📚 ไฟล์หลักสั้นๆ ที่เหลือค่อยอ่านตอนใช้ - ถ้า Skill มีหลายวิธีทำงาน ให้ไฟล์หลักเป็นเหมือนสารบัญ บอกว่างานแบบนี้ไปอ่านไฟล์ไหน ใช้สคริปต์อะไร แล้วค่อยเปิดรายละเอียดตอนจำเป็น นี่คือ progressive disclosure ไม่ต้องบังคับให้อ่านทั้งเล่ม ทั้งที่งานนี้ใช้แค่บทเดียว - คู่มือที่ล็อกทุกขั้นก็ต้องกลับมาดูเหมือนกัน บทความชี้ว่าขั้นตอนที่เคยช่วยโมเดลรุ่นก่อน อาจบังคับ Astra มากเกินไป ลองบอกเป้าหมายกับข้อจำกัดให้ชัด แล้วเหลือพื้นที่ให้มันเลือกวิธีทำเองบ้าง - ผู้เขียนบอกว่าปรับคำแนะนำของ skill-creator แล้ว ทั้งเรื่องคำอธิบายและการแยกรายละเอียดไปอ่านเมื่อใช้ แต่ถ้าทีมยังใช้ Sol หรือ Luna ด้วย ก็คิดถึงคนอื่นก่อนแก้ Skills กลาง อย่าปรับทุกอย่างให้เหมาะกับโมเดลที่เราใช้คนเดียว ═══════════════════ 🗂️ แก้คำผิดนิดเดียว ไม่ต้องอ่านทั้งโปรเจกต์ก่อน - AGENTS . md เป็นอีกไฟล์ที่ควรกลับไปดู เพราะเป็นกติกาที่ใช้กับงานในโปรเจกต์ ถ้าแค่แก้คำผิด แต่ต้องอ่านเอกสารทุกชุดและทำแผนผังทั้งโปรเจกต์ก่อน งานเล็กก็กลายเป็นงานใหญ่ตั้งแต่ยังไม่ได้ลงมือ - เอกสารยังควรอ่าน แค่ชี้ให้ตรงงาน เช่น แก้ระบบล็อกอินก็อ่านคู่มือส่วนนั้น และอัปเดตให้ตรงกับระบบที่ใช้อยู่ ไม่ใช่ให้โมเดลทำตามคู่มือเก่าที่ไม่ตรงกับโค้ดแล้ว - ถ้ามันหยุดหรือเปลี่ยนทางเพราะคำสั่งเก่า ลองถามตรงๆ ว่า “ติดคำสั่งจากไฟล์ไหน ข้อไหน เขียนไว้แบบนั้นจริงๆ หรือเป็นสิ่งที่ตีความเอง” คู่มือ Astra ก็แนะนำให้ไล่หาคำสั่งที่ขัดกันแบบนี้ ═══════════════════ 🧪 ตรวจให้ตรงงาน ไม่ต้องวนซ้ำเผื่อไว้ - คู่มือ Astra บอกว่าโมเดลมีแนวโน้มตรวจงานโค้ดละเอียดอยู่แล้ว คำสั่งเก่าที่สั่งให้ทดสอบทุกอย่างซ้ำๆ จึงอาจทำให้ตรวจเกินงาน โดยเฉพาะการแก้จุดเล็กๆ - ไม่ได้แปลว่าให้เลิกทดสอบนะ ให้ตรวจสิ่งที่แก้และส่วนที่อาจได้รับผลกระทบให้ครบ ถ้าเจอปัญหาก็แก้แล้วตรวจซ้ำ แต่พอผ่านแล้ว ไม่มีอะไรเปลี่ยน และไม่มีข้อสงสัยค้างอยู่ ก็ไม่ต้องวนเรื่องเดิมไปเรื่อยๆ ═══════════════════ 🎯 อยากให้ทำจนจบ ก็บอกให้ชัดว่าจบตรงไหน - บทความบอกว่า Astra อาจทำรอบแรกเสร็จแล้วกลับมารอเรา ทั้งที่เราคาดหวังให้ทำต่อ โดยเฉพาะถ้ากติกาเก่ายังเขียนว่า “ทำรอบแรกแล้วหยุดให้รีวิวก่อน” มันก็อาจหยุดตามนั้นจริงๆ - ถ้าต้องการเว็บที่ใช้ได้ คำว่าเสร็จควรรวมถึงรันได้ เปิดดูหน้าจอ ลองกดใช้งาน และแก้สิ่งที่ยังพังด้วย แนบตัวอย่างที่อยากได้และบอกสิ่งที่ต้องผ่าน ไม่ใช่ให้มันเดาว่าเราต้องการแค่โค้ดหรือของที่ใช้งานได้จริง - แยกให้ชัดว่าอะไรทำต่อได้ อะไรต้องถาม เช่น ชุดทดสอบในเครื่องที่ยืนยันว่าใช้ข้อมูลทิ้งได้และไม่เชื่อมระบบจริง ให้รัน แก้ปัญหาจากงานนี้ แล้วตรวจซ้ำได้ ส่วนการเอาขึ้นระบบจริงค่อยหยุดรออนุมัติ ไม่ต้องใช้คำว่า “ถามก่อนทุกครั้ง” ครอบทุกอย่าง ตัวอย่าง prompt สำหรับงานเว็บในพื้นที่ทดสอบ เอาไปปรับตามงานได้เลย “ทำฟังก์ชันนี้ให้รันและใช้งานได้ตามโจทย์ อ่านไฟล์ที่เกี่ยวข้องให้พอเข้าใจ ลงมือทำ เปิดดูหน้าจอ ลองใช้งาน และทดสอบส่วนที่เกี่ยวข้อง ถ้าเจอปัญหาจากสิ่งที่แก้ ให้แก้ต่อแล้วตรวจซ้ำ อย่าหยุดแค่รอบแรกที่มีโค้ด เรื่องเล็กที่ไม่เปลี่ยนผลลัพธ์สำคัญให้ตัดสินใจแล้วบอกสมมติฐานไว้ ถ้าข้อมูลที่ขาดทำให้ผลลัพธ์เปลี่ยนมากให้ถาม ทำต่อได้ในพื้นที่ทดสอบที่ไม่เชื่อมระบบจริง แต่ห้ามเผยแพร่หรือแก้ระบบจริงก่อนอนุมัติ ก่อนส่งบอกว่าทำอะไรแล้ว ตรวจอะไรผ่าน และยังติดอะไรอยู่” ═══════════════════ 🧹 ให้ Astra ช่วยตรวจ prompt เก่าได้เลย - ให้มันไล่ดู Skills, AGENTS . md และ prompt ที่ใช้ประจำ ว่ามีอะไรซ้ำ ตีกัน บังคับอ่านเกินงาน หรือทำให้หยุดก่อนจบ แล้วเสนอข้อความเดิมกับข้อความที่อยากแก้ให้เราดูก่อน กติกาสำคัญกับจุดที่ต้องขออนุมัติยังต้องอยู่ - หลังปรับ ลองกับงานตัวอย่างเดิม ดูทั้งงานผ่านไหม เร็วขึ้นไหม และใช้ token เท่าไร คำสั่งสั้นลงอย่างเดียวไม่ได้แปลว่าดีขึ้น ต้องดูผลงานด้วย - นี่คือการตรวจชุดคำสั่งตอนปรับโปรเจกต์นะ ไม่ใช่เพิ่มกฎใหม่ว่า “ก่อนทำทุกงานต้องตรวจ Skills ทั้งหมด” ไม่อย่างนั้นก็วนกลับไปปัญหาเดิม ตัวอย่าง prompt สำหรับเริ่มตรวจ “ช่วยตรวจ Skills, AGENTS . md และ prompt ในโปรเจกต์นี้ ว่ามีอะไรซ้ำ ตีกัน เขียนกว้างเกินไป บังคับให้อ่านหรือทดสอบเกินงาน หรือทำให้หยุดก่อนงานเสร็จ เสนอว่าจะปรับให้เหมาะกับ GPT-6 Astra ยังไง คำอธิบาย Skill ให้สั้นและชัดว่าใช้เมื่อไหร่ รายละเอียดที่ใช้เฉพาะบางงานให้แยกไปอ่านตอนจำเป็น เก็บกติกาสำคัญกับจุดที่ต้องขออนุมัติไว้ และคิดถึงโมเดลอื่นที่ทีมใช้ด้วย แสดงข้อความเดิมกับข้อความที่เสนอแก้พร้อมเหตุผลก่อน ยังไม่ต้องแก้ไฟล์” ═══════════════════ 💭 ในมุมมองส่วนตัวของผม ผมอยากให้เราใช้ thinking ตามงานจริงๆ Medium ทำได้ก็ใช้ Medium งานยากหรือกลัวแตกและไม่มีเวลาแก้ก็เริ่ม High ส่วนระดับที่สูงกว่านั้น เก็บไว้ใช้ตอนที่ช่วยให้งานดีขึ้นจริงๆ แล้วเวลาเปลี่ยนโมเดล อย่าลืมกลับมาอ่าน prompt กับ Skills ของตัวเองด้วย ข้อไหนยังช่วยก็เก็บไว้ ข้อไหนขวางงานก็ปรับ บอกให้ชัดว่าอยากได้อะไร ทำต่อได้ถึงไหน และแบบไหนถึงเรียกว่าเสร็จ ผมอยากเอา token ไปใช้แก้ปัญหาของงาน มากกว่าให้ AI อ่านกติกาซ้ำ ตรวจเรื่องเดิมวนไป หรือหยุดถามในสิ่งที่เราอนุญาตแล้วครับ