LLM Benchmark v4 对比 Gemini 4 Argon 与 GPT Sol 6.1 Terra
AkitaOnRails 发布自建 LLM Benchmark v4,把 Gemini 4 Argon、GPT Sol 6.1 Terra、Kimi K3.1 Pro、Claude Sonnet 5.5 放在一起比较,结论是前沿模型已足够胜任日常编程。
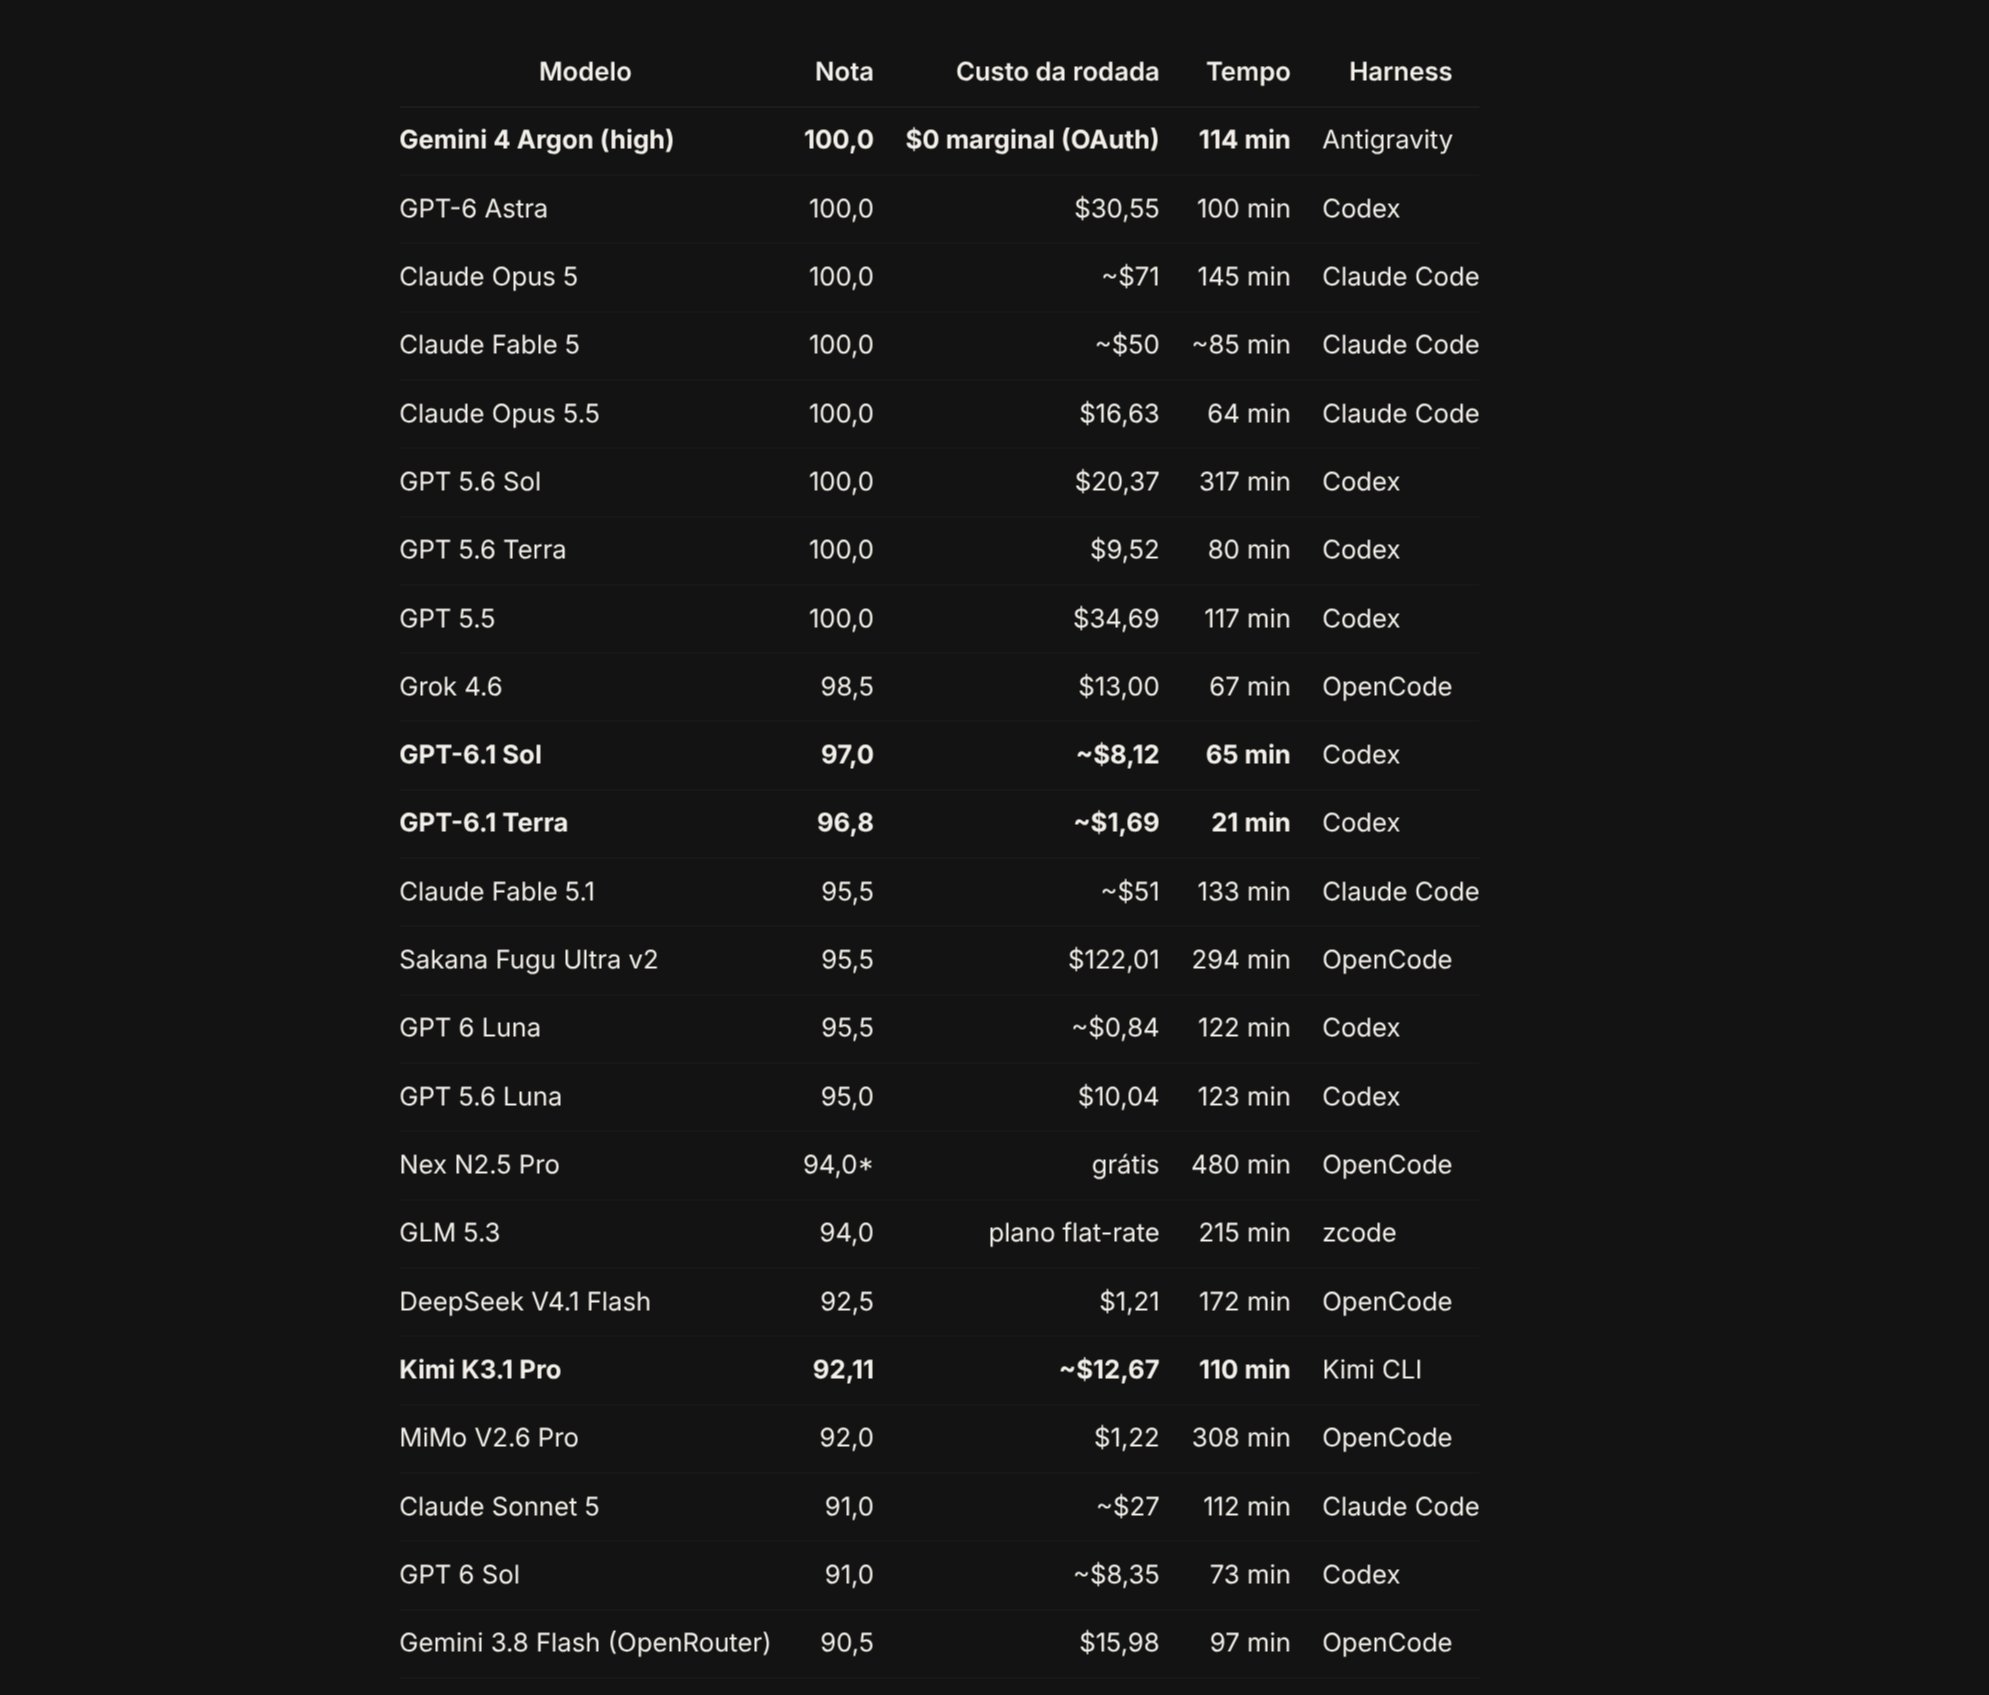
Post novo: "LLM Benchmark v4: Gemini 4 Argon, GPT Sol 6.1 Terra, Kimi K3.1 Pro, Claude Sonnet 5.5" Finalmente Gemini sai da rabeira e vai direto pra dianteira! Já não era sem tempo. Agora sim, tá tudo igual pra todo mundo. Hoje eu comparo meu benchmark com outros mais famosos como SWE-Bench Pro pra vocês entenderem de uma vez por todas com isso funciona e porque benchmark A não é melhor que benchmark B. E porque este benchmark, se não for o último, está perto de ser. TL;DR: a esta altura, não tem mais importância escolher por benchmark: qualquer um dos frontier models é Competente o Suficiente pra todas as suas tarefas de programação do dia a dia. Use qualquer uma e fique trocando entre elas como meu http://aimemory.sh https://akitaonrails.com/2026/10/28/llm-benchmark-v4-gemini-4-argon-gpt-sol-6-1-terra-kimi-k3-1-pro-claude-sonnet-5-5/ English: https://akitaonrails.com/en/2026/10/28/llm-benchmark-v4-gemini-4-argon-gpt-6-1-sol-terra-kimi-k3-1-pro-claude-sonnet-5-5/