gemini-4IMAGE
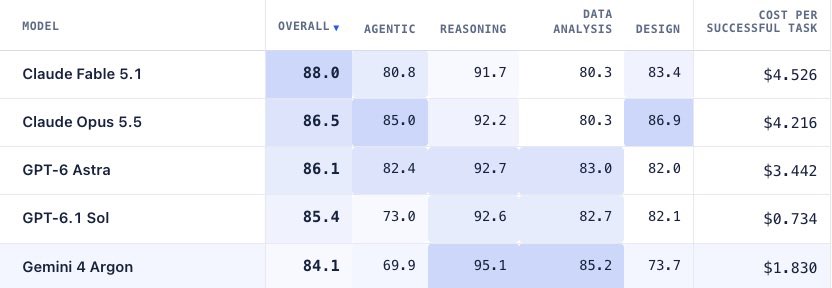
LiveBench 2.0 给 Gemini 4 Argon 排第五
Gemini 4 Argon 在 LiveBench 2.0 总分 84.1 排第五,推理与数据分析第一,但智能体和设计垫底,单任务成本 1.83 美元。
AYi
@AYi_AInotes20 天前收录原推发布于 2026.10.14
AYi @AYi_AInotes原推发布于 2026.10.14
谷歌新旗舰 Gemini 4 Argon 刚官宣,第三方评测 LiveBench 2.0 几乎同步甩出一张跑分表,直接把它按在了第五名。 乍一看总分 84.1 落在 Claude 和 GPT-6 后面,但只要把五门成绩单拆开,就会发现它根本不是平庸,而是一个极其偏科的理科怪兽。 在推理 95.1 和数据分析 85.2 两个硬核科目上,它直接拿下全场第一。但一测到智能体自主干活 69.9 和设计生成 73.7,分数直接掉到了前五名垫底。 以前大家看榜单只挑总分第一,但真实业务场景里,拿一个智能体只有 69 分的模型去跑复杂长流程,踩坑概率会成倍放大。 这张榜单最耐人寻味的,其实是最后一列:每个成功任务的实际成本。 Claude 两款模型在智能体和设计上确实断层领先,但跑完一个任务要 4 美元多。 相比之下,总分紧咬的 GPT-6.1 Sol 做完一个任务只要 0.73 美元,成本差了将近六倍;Gemini 4 Argon 则卡在中间,单任务 1.83 美元。 说白了,大模型早已没有所谓的全能六边形战士。 Claude 在死磕复杂的智能体闭环,谷歌在死磕硬核的逻辑推理和数学分析,而 OpenAI 在拼命把执行成本砍到脚脖子。 看榜选模型从来不是为了选谁当状元,而是算清每一块钱到底买到了什么能力。
这条是引用着另一条写的:「Gemini 4 Argon 上线 AI Studio、Gemini API 与 Gemini App」
x.com/ayi_ainotes/status/2110070065919889679采集于 2026.10.14 10:24