逆向抓包被封号,建议改用本地部署
作者称近期做逆向、抓包、代码审计的人中,OpenAI、GitHub、Claude 账号都有被封情况,建议改用本地开源模型规避云端封号与数据外泄。
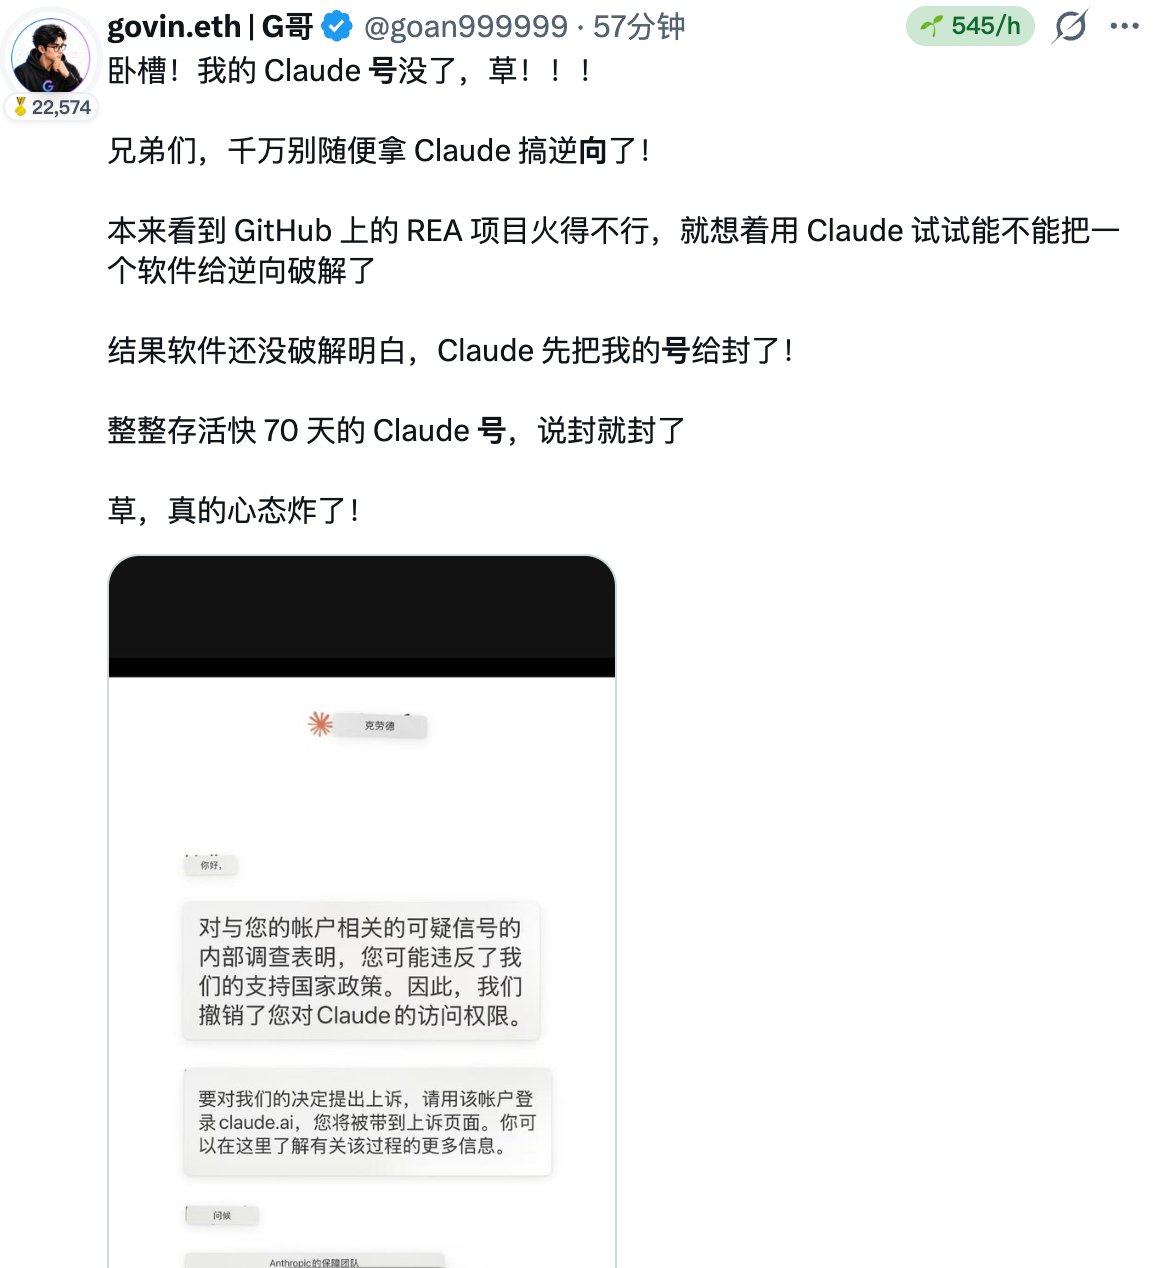
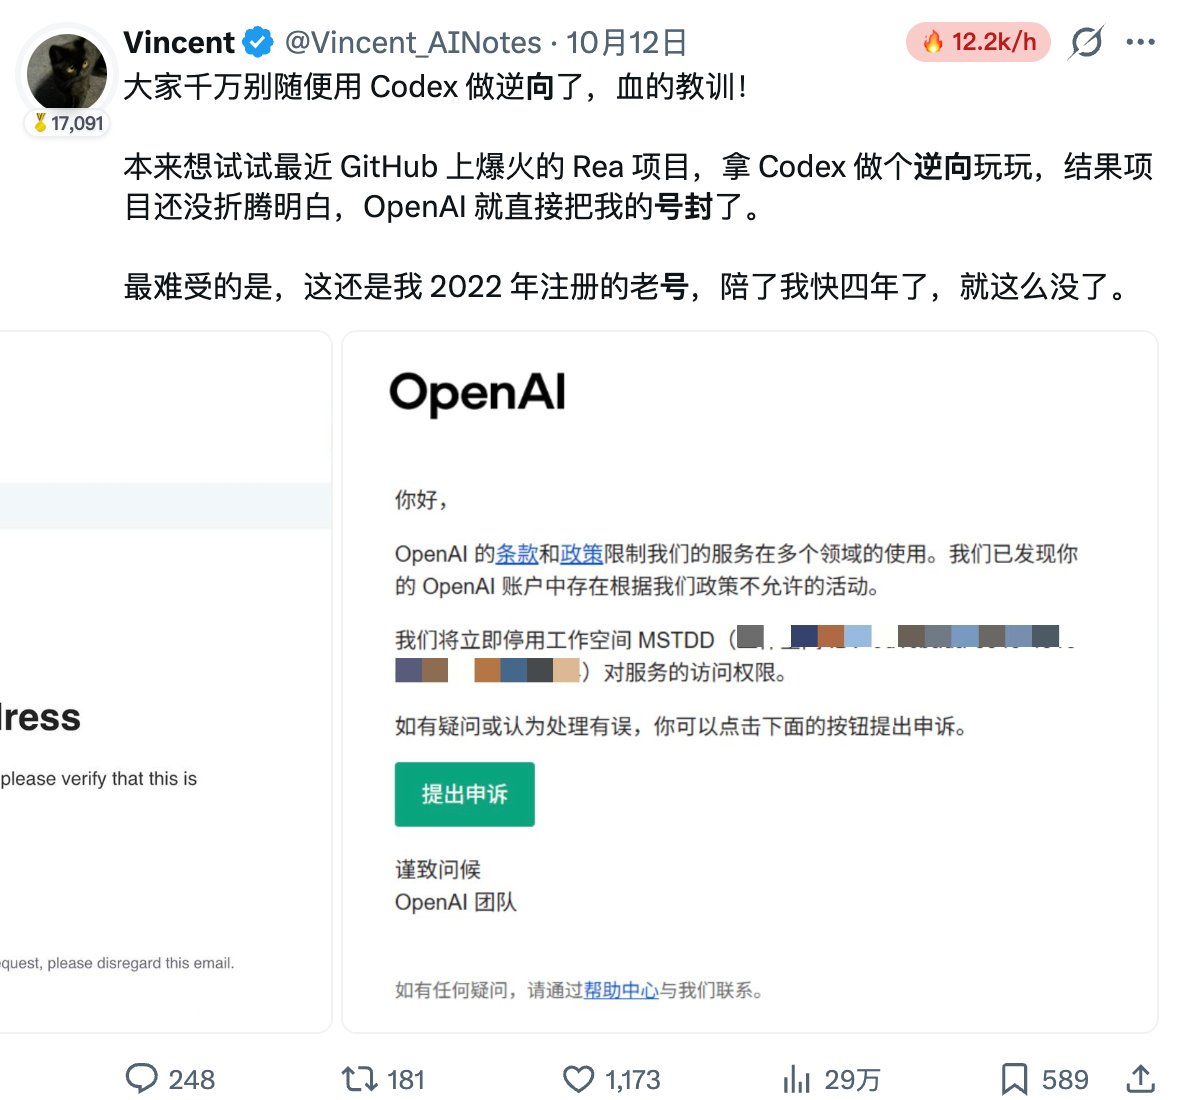
🚨兄弟们,赶紧停下来!最近REA太火了,但最近有很多兄弟中招了, OpenAI、GitHub 、Claude 都有被封号的情况,我必须再旗帜鲜明地强调一次: 搞逆向、做抓包和代码审计,我【强烈推荐、且唯一推荐】的方式就是:本地部署! 真别心存侥幸去蹭什么云端商用大模型了。但凡写过几年工业级代码的都知道,在别人的云端监控底下搞底层工程,纯属与虎谋皮。 为什么技术老鸟碰这类活,100% 坚持本地部署?就 3 条硬道理: 1️⃣ 物理级免疫封号 本地跑开源模型,断网都能转。没有 OpenAI / Anthropic 的云端行为遥测,没有自动化安全分类器,你的主力号、开发环境稳如泰山。 2️⃣ 数据资产零外泄 逆向出来的协议逻辑、未公开接口、商业代码,你往云端 API 里一送,本质上就是把把柄双手奉上。本地跑,数据死在内网,谁也拿不走。 3️⃣ 算力真正的“零元购” 逆向分析和 AST 语法树解析极其吃 Token,动不动几万、几十万 Tokens 的上下文吞吐。走商业 API 钱包瞬间见底;本地自部署一个开源模型,随便你并发拉满,连电费都花不了几毛钱。 💡 很多兄弟以为本地部署门槛高,其实现在的生态早就平民化了: • Mac 玩家:靠统一内存架构,开个 Ollama 跑量化版模型,内存吃满速度飞快; • PC / 服务器:一张 4090 配合 vLLM,跑开源版 DeepSeek,推理速度直接起飞。 与其天天提心吊胆防封号,不如老老实实搭个属于自己的本地开发底座。 兄弟们现在本地主力跑的是哪个开源模型?配置够不够用?评论区交流下抄作业👇
这条是引用着另一条写的:x.com/geekcatx/status/2109689282336346575