jevIMAGE
Jev 70ms 低延迟实测与架构解析
作者拆解 Jev 的并行采样架构与成本(输入 $0.042/百万 token、输出免费),并给出堡垒机实时拦截危险 shell 命令等生产级用法。
karminski-牙医
@karminski32026.09.18收录原推发布于 2026.09.18
karminski-牙医 @karminski3原推发布于 2026.09.18
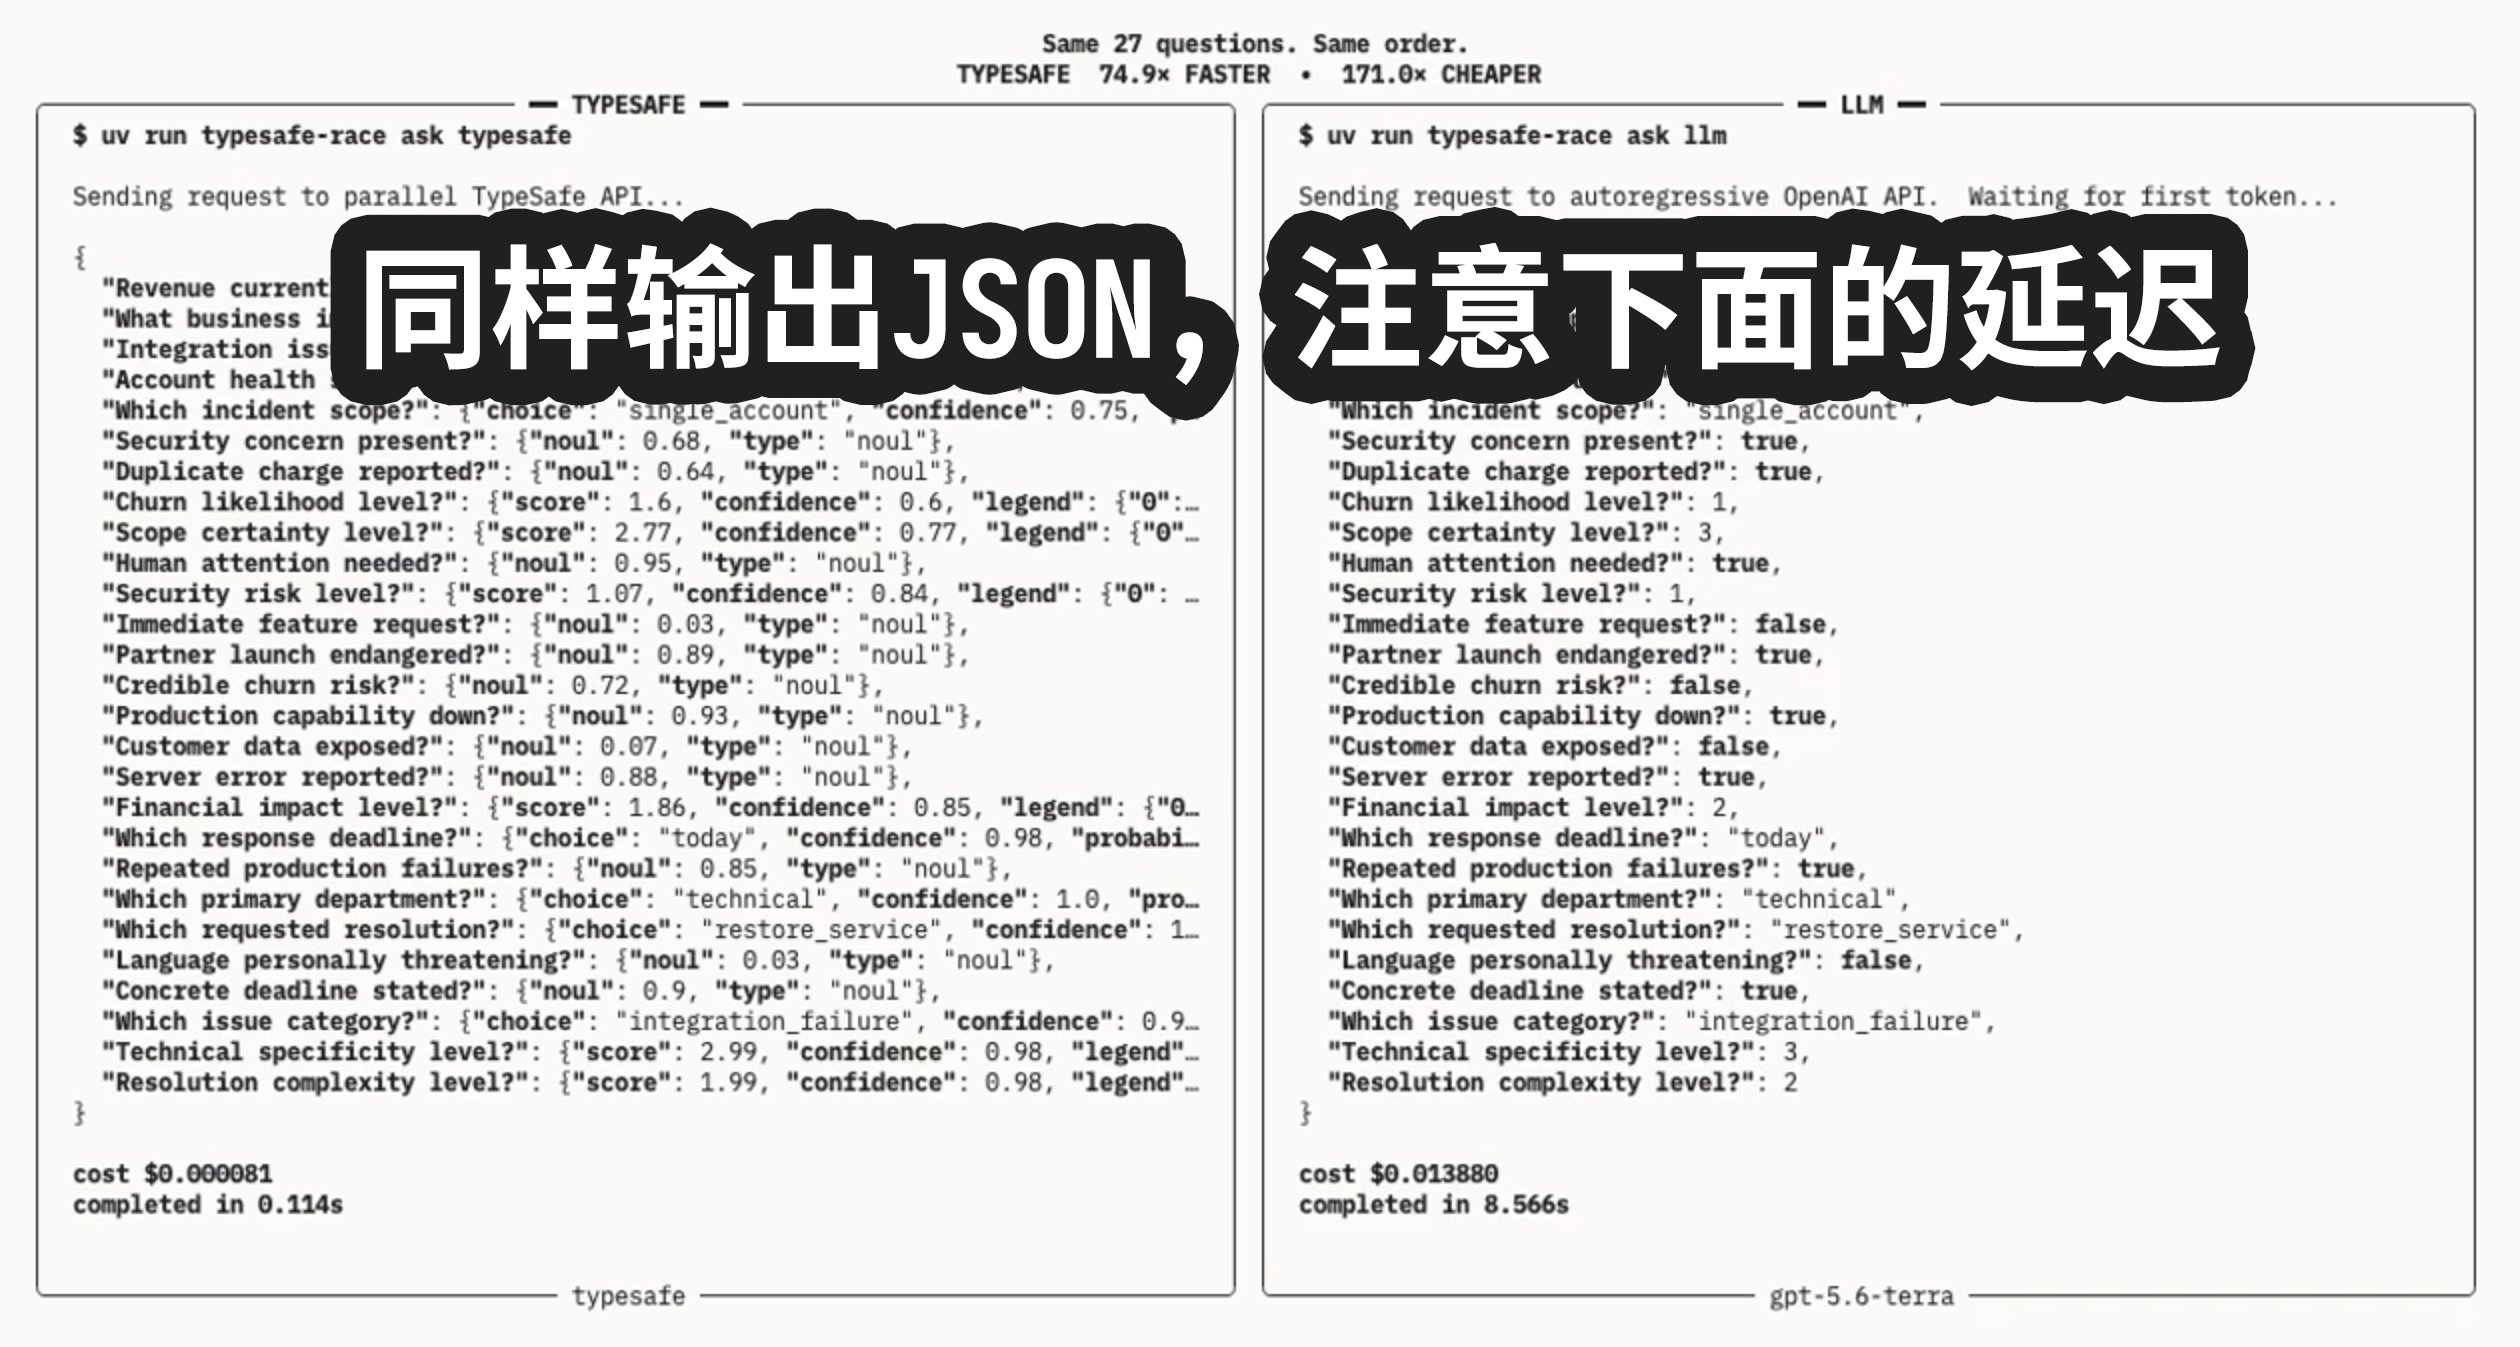
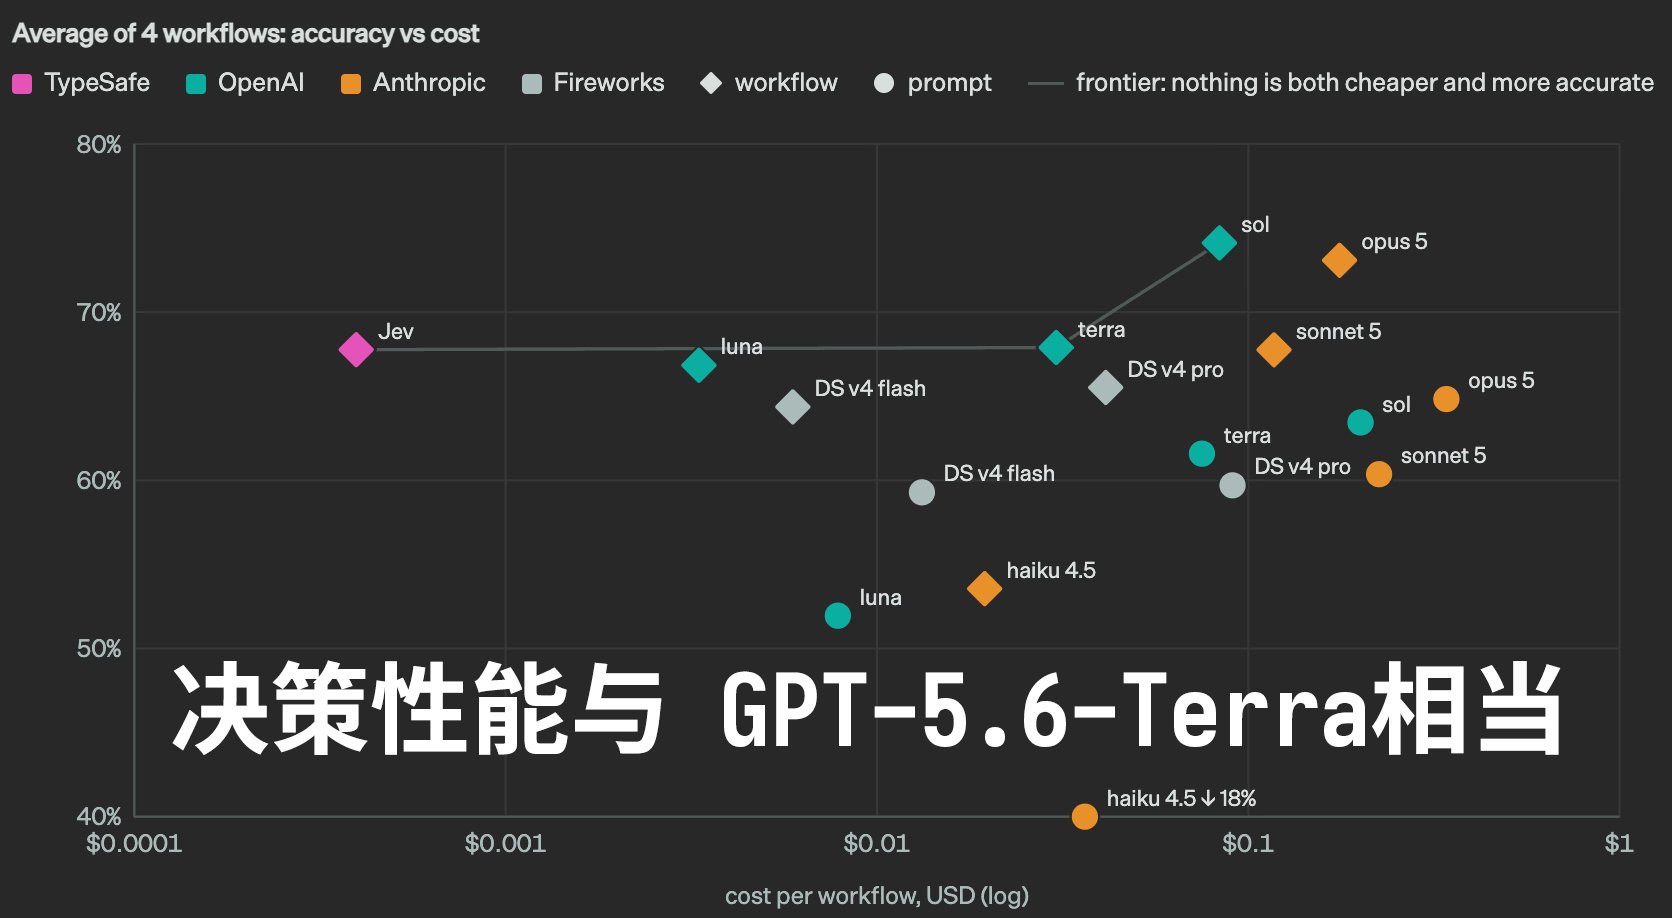
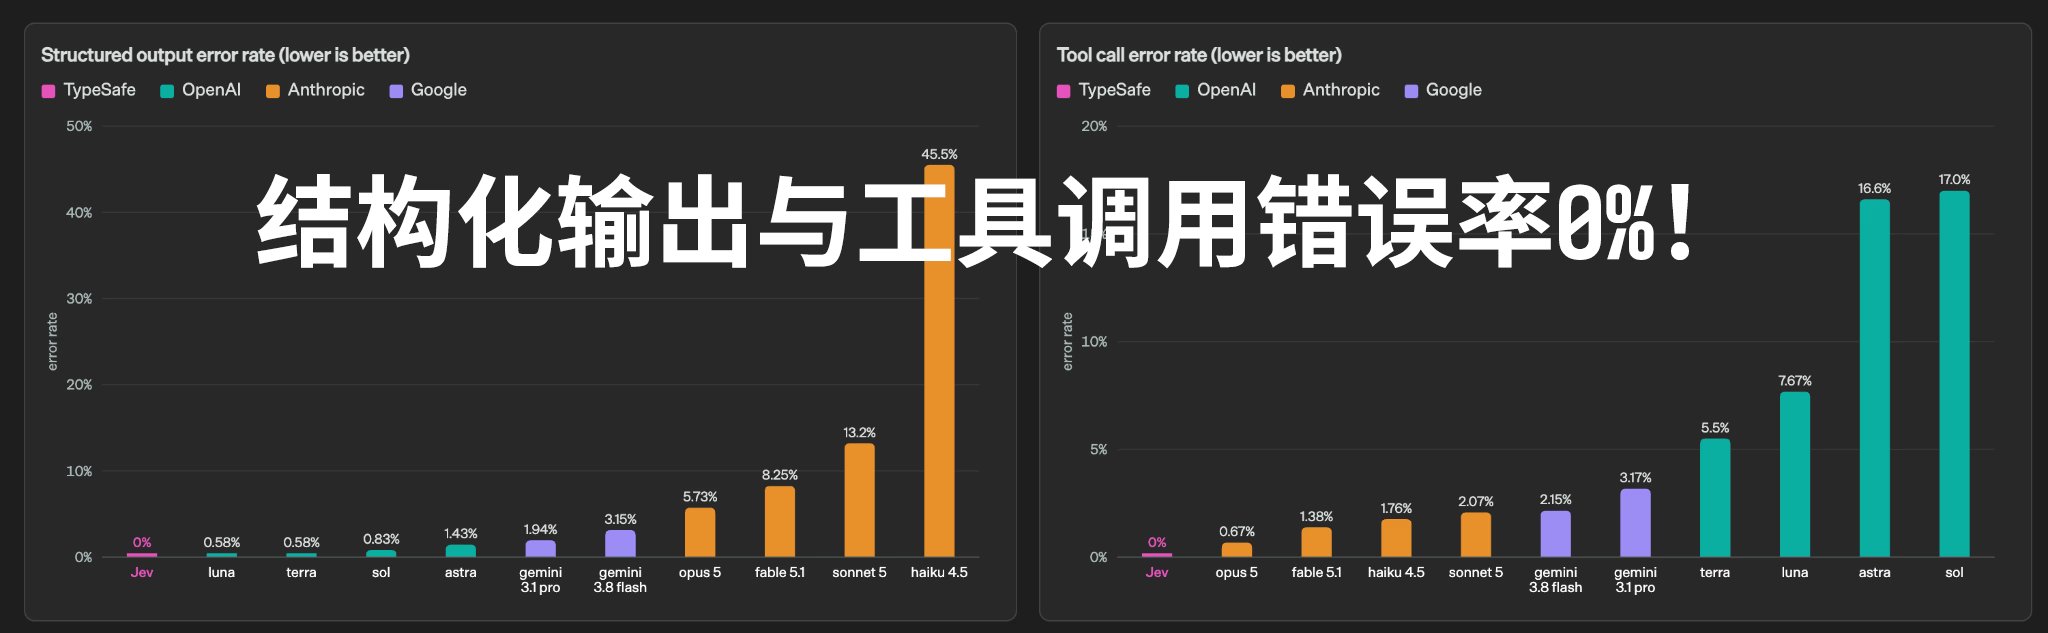
但天下武功唯快不破, 这玩意从输入到输出最快只需要70ms! 所以完全可以用在高频的生产级场景, 比如接到堡垒机里面实时判断用户输入的shell命令是否存在危险(rm -rf /). 再加上输入每百万token只需要$0.042, 输出不要钱. 妥妥的新一代flash模型斩杀线(有的flash模型会被企业用作决策器). 说完了用途再来看它的架构, 传统大模型有多少token就要把激活参数过多少遍(前向传播)所以特别吃显存带宽, 而这个模型设计了一个特殊的并行采样架构, 只需要一次前向传播, 就能输出所有预设schema字段的离散预测与分支概率. 达成了极低的延迟. 而推出Jev的 TypeSafe AI 这个公司也很有噱头, 它是 Diogo Almeida 一手创办的, 就是他曾经在 OpenAI 的 InstructGPT 和早期 RLHF(基于人类反馈的强化学习) 团队中的贡献才有了如今的ChatGPT. 最后说一下目前模型的限制, 首先由于没有本土节点, 所以虽然它只需要70ms, 但是到美西这海底光缆延迟120ms是躲不掉的, 所以至少还是200ms打底. 另外, 模型被官方称为 System One 模型, 所以理想搭配还需要一个 System Two 模型用来进行战略判断, 然后生成策略当作提示词输入进去, 这样才能提升模型的输出质量. 另外, 官网还在申请使用, 不过vercel的AI Gateway已经能直接用了, 所以想测试的同学直接去vercel用就行.
x.com/karminski3/status/2100717948881326224采集于 2026.09.18 10:12