开源复刻 Jev:Qwen3.5-9B 两天微调出 Nimble
Bespoke 用 2676 条对比数据轻量 LoRA 训出 Nimble,held-out 90.12% 逼近 Jev 的 93.21%,不生成 CoT 直接读 logits。
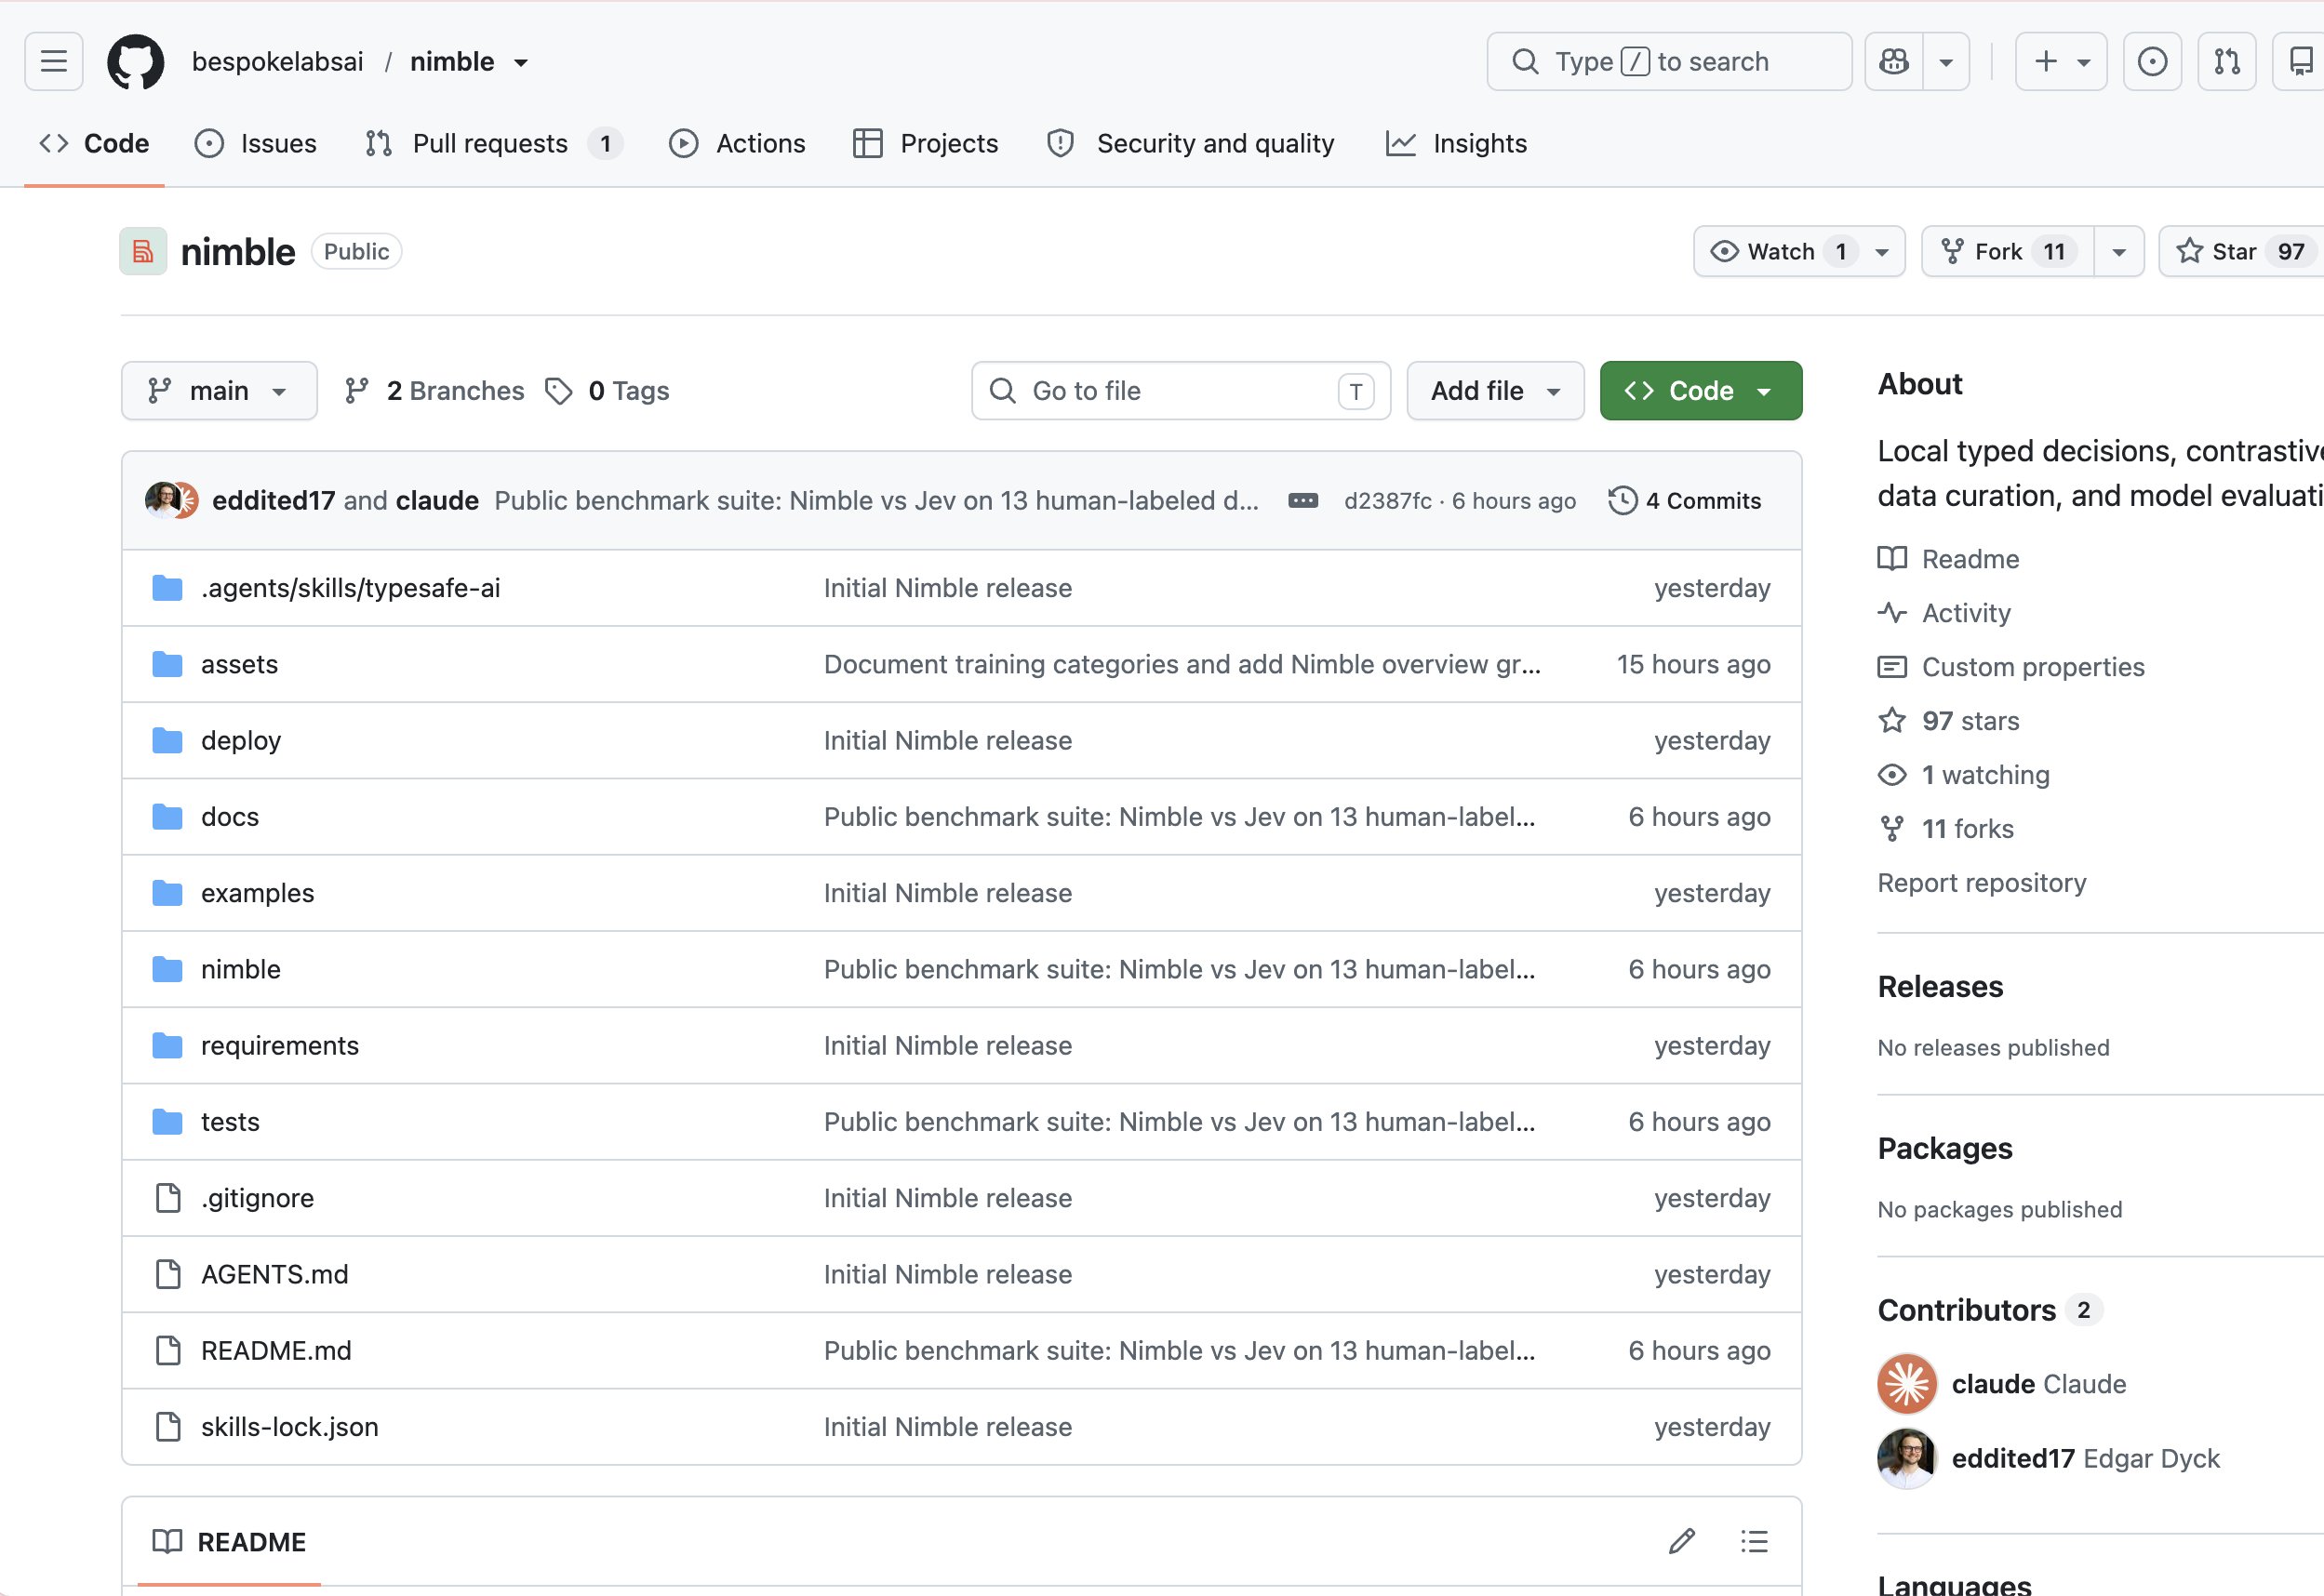
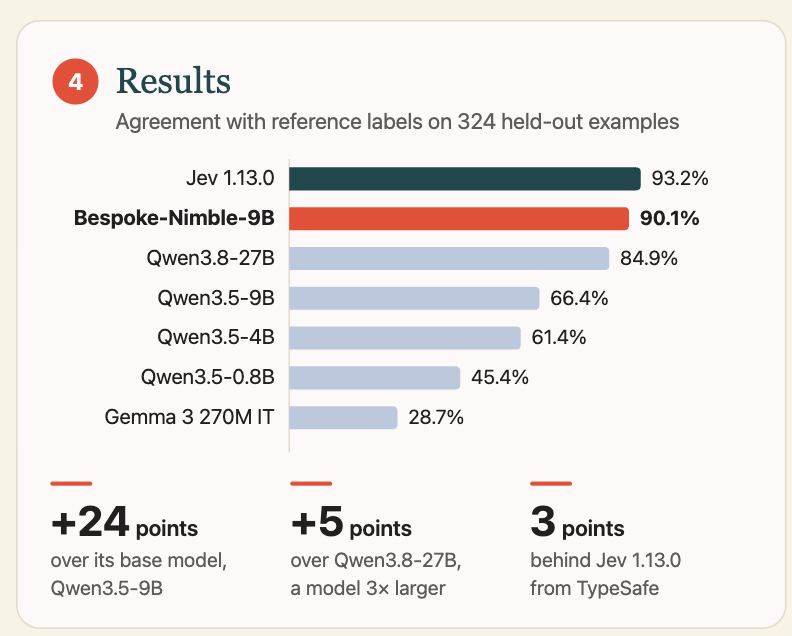
牛逼!Jev 刚火没两天,已经有人搞了个开源的Jev🤣 @bespokelabsai 发布了一个开源版的Jev:Bespoke Nimble。 更离谱的是,整个项目是基于 Qwen3.5-9B ,只花了大约两天。 数据、模型权重、训练配方、推理代码全部公开,而且没有从 Jev 蒸馏,只拿 Jev 做评测参照。 最终方法是在 Qwen3.5-9B 上做了一次很轻量的 LoRA微调。 只用了2676 条训练数据,结果在他们自己的 324 条 held-out 测试集上拿到了90.12%,而原版的Jev是93.21%。 一个 9B 模型,已经做到距离 Jev 只差 3 个百分点。 但我觉得最值得看的不是这个分数,而是他们到底怎么训的。 核心方法叫 contrastive data curation。 简单说,他们会构造两个几乎完全一样的样本,只修改一个足以改变最终决策的关键事实,让正确答案发生翻转。 模型因此被迫学会一件事: 到底哪条证据,才真正应该改变决策。 这其实特别符合 Jev 这类模型的用途。 它本来就不是拿来陪你聊天的,而是塞进 Agent 和软件系统里,做路由、审核、打分、策略判断这些高频的小决策。 推理方式上Nimble 不生成 CoT,甚至不生成 JSON。 它直接读取候选答案 token 的 logits,再把它们转成概率,最后由程序拼成结构化输出。 能不生成一个 token,就不生成一个 token。 这也是 Jev 这类模型路线真正有价值的地方。 对于大量根本不需要长思考的决策,怎么让模型几乎不想,直接判断。 PS:我个人很反感这两天狂吹 Jev 的帖子....
这条是引用着另一条写的:x.com/madiator/status/2100990591215783946