Unsloth 量化数据:M3.1 Flash 428B MoE,2-bit 约需 150GB 内存
作者拆解 Unsloth 的量化表:1-bit 129GB、2-bit 约 150GB、4-bit 249GB,并估算 2-bit 理论速度上限约 87 tok/s、top-1 精度 91.5%,提醒 1M 上下文不能按 16K 表外推。
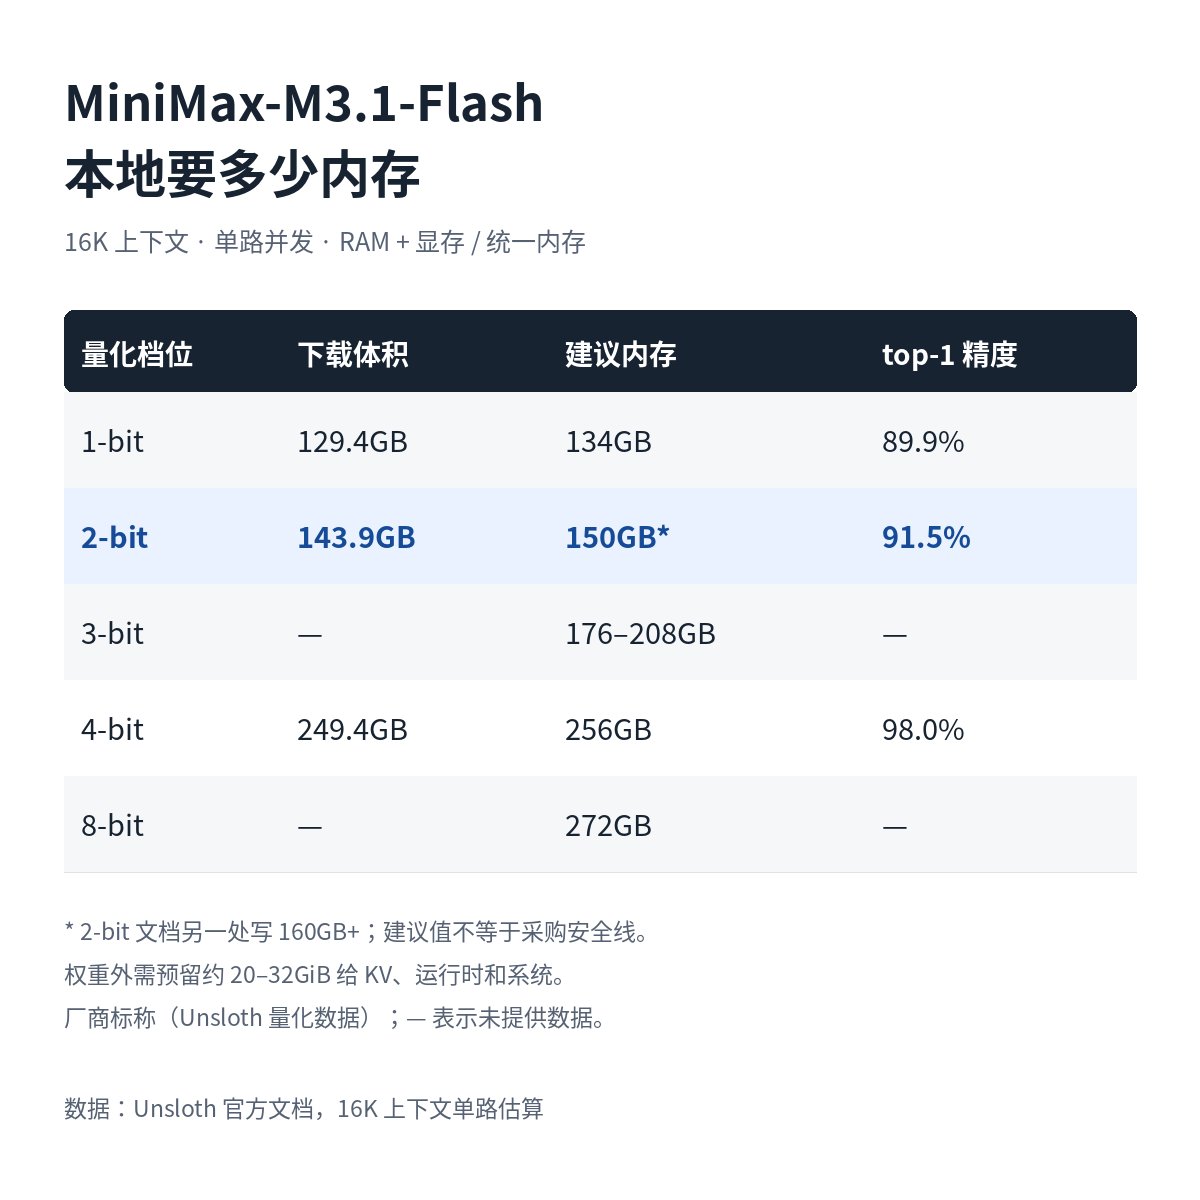
428B,2-bit 约需 150GB 内存。 这是 Unsloth 给 MiniMax-M3.1-Flash 的量化数据。 官方说,它是 428B 的 MoE,每 token 激活 23B,支持 1M 上下文、多模态,面向编程和 Agent,10 月 23 日开放权重。 先看容量。 激活 23B,不等于只装 23B。 Unsloth 明说,完整量化权重仍要放进 RAM 加显存,显存不够就 CPU offload。 MoE 省了每步计算和权重读取量,全量权重的容量账还在。 按官方 16K 上下文、单路并发的建议分三档: 1-bit:下载 129.4GB,建议内存 134GB。 2-bit:下载 143.9GB,建议约 150GB,文档另一处写 160GB+。 4-bit:下载 249.4GB,建议内存 256GB。 这些建议值别当采购安全线。 官方另提示,权重之外要给 KV cache、运行时和系统预留约 20–32GiB;GB 和 GiB 也不能直接混算。 1M 是模型能力,不能拿这张 16K 的表直接外推。 再看带宽,我做个理想估算: 23B × 2 bit ÷ 8 ≈ 5.75GB/token。 假设可用内存带宽 500GB/s,500 ÷ 5.75 ≈ 87 tok/s,只是理论上限。 实际还有量化元数据、注意力、数据搬运和计算开销,速度会更低。 精度也要付账。 Unsloth 报的 top-1,2-bit 是 91.5%,4-bit 是 98.0%,差 6.5 个百分点。 这组指标不能当成任务成功率。 我的推断是,长链路编程和工具调用更值得复测,具体损失得拿自己的任务验。 机器怎么选,modelfit 的判断更保守: 128GB Mac 装不下 2-bit;256GB 统一内存才开始有余量;4-bit 要看 512GB Mac Studio。 还得检查 llama.cpp:早期转换会乱码,按其记录要用 b11861 及以后。 我的判断:本地大模型选型,瓶颈正在往内存容量和价格上挪。 做硬件先算每 GB 内存成本,再谈能装多大的模型。 你手上有多少内存和显存,想跑哪个模型?报个配置,我帮你算能不能装下。